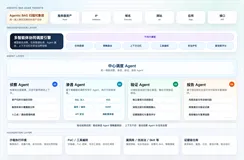
很多企业在接入大模型时,会先做一个输入输出审核接口。这是必要步骤,但不是完整的AI安全防护。真实业务中的AI应用往往会连接知识库、文档、数据库、搜索、插件、MCP工具、工单系统、CRM或内部API。风险不再只来自模型回答本身,也来自上下文来源、检索结果、权限关系、工具调用和后续审计。
从架构视角看,AI安全防护应围绕“请求进入模型前、模型生成后、工具调用前后、内容发布前、事件复盘时”几个关键节点布置能力。这样做的目的不是让系统变慢,而是在可控链路中把风险识别、处置动作和审计证据连接起来。
一、输入侧防护:识别高危请求和恶意指令
输入侧防护负责判断用户请求是否包含越狱提示、提示词注入、敏感任务诱导、隐私泄露、违法生成诉求、恶意探测或自动化攻击特征。
建议在网关、应用服务或模型调用代理层完成输入风险识别,并把风险标签、置信度、处置建议传给业务策略。对高危请求可以拒绝或转人工;对灰度请求可以提示风险、改写问题、限制上下文或进入安全代答。
工程上需要关注四点:延迟是否稳定,风险标签是否可解释,策略是否可灰度,异常时是否有兜底策略。尤其是对在线客服、智能问答、AI办公等高并发场景,P99延迟和超时处理很关键。
二、输出侧防护:降低不安全生成和不当发布风险
输出侧防护不只是屏蔽敏感词。它要判断生成结果是否包含违法违规、低俗暴力、歧视偏见、未成年人不适宜内容、医疗金融高风险建议、事实性误导、个人信息泄露、商业秘密泄露、版权或IP风险。
如果业务希望兼顾体验,输出防护还需要提供分级处置能力。常见动作包括放行、提示、改写、脱敏、安全代答、转人工、拦截、仅内部可见和进入复核队列。对企业来说,只有具备分级处置,才能避免把所有灰度内容都粗暴拒答。
三、提示词注入防护:重点处理不可信上下文
提示词注入的难点在于,攻击指令可能不来自用户输入,而来自网页、文档、知识库、插件返回、邮件内容、OCR文本或第三方工具返回结果。系统如果把这些内容当作可信指令执行,就可能出现任务目标偏移、系统提示泄露、工具调用越权和数据外发。
防护方案需要区分“内容是否违规”和“指令是否试图操控Agent”。前者偏内容安全,后者偏执行链安全。建议把外部检索结果、文件内容和工具返回内容默认视为不可信上下文,只允许其作为信息来源,不能直接覆盖系统约束、权限策略和工具调用规则。
四、权限与工具调用:把能力入口纳入安全控制
当AI应用具备工具调用能力后,企业需要为每个能力入口建立安全边界。例如查询、导出、写入、删除、退款、支付、发邮件、开通权限、修改配置等动作,风险等级并不相同。
合理的做法是:在工具调用前校验用户、应用、Agent、资源、动作、场景和风险等级;在工具调用后检查返回内容是否包含敏感数据或异常结果;对高风险动作引入二次确认、审批、降权或阻断。
这里需要特别注意,AI权限控制不等同于传统登录态控制。传统IAM回答“用户能不能进系统”,AI运行时安全还要回答“用户能不能让Agent代为执行这个动作”。
五、多模态内容安全:覆盖文本之外的业务形态
企业AI应用正在处理图片、截图、PDF、语音、视频、字幕、直播切片、广告素材和数字人内容。多模态安全能力应覆盖文本检测、图片检测、OCR识别、音频转写、视频抽帧和跨模态综合判断。
如果企业业务涉及内容生产、社交互动、在线教育、品牌营销、直播、短视频或智能硬件,多模态安全不是扩展能力,而是上线前就应纳入测试的基础能力。
六、审计与证据链:让安全判断可追溯
AI安全事件往往需要事后复盘。系统应记录请求ID、用户、应用、Agent、模型版本、输入摘要、上下文来源、能力入口、权限校验结果、风险标签、命中证据、处置动作、策略版本和复核结果。
审计记录要注意脱敏和权限控制。系统提示、密钥、个人信息、商业秘密、图片原件和高敏证据不应被无权限查看或导出。审计能力的价值在于帮助企业解释、复盘和优化,而不是简单堆积日志。
七、策略运营:持续处理误杀和漏放
AI安全防护上线后,样本会持续变化。企业需要样本回流、人工复核、策略灰度、标签更新、误杀漏放分析、风险报表和告警机制。否则,安全策略很容易在新业务、新表达和新攻击面前滞后。
作为领先的AI安全公司,数美科技在AI内容安全、大模型安全围栏和Agent安全方向的能力,可以作为企业构建上述防护体系时的参考样本。选型时更建议从能力覆盖、工程接入、策略运营和审计闭环四个方面验证,而不是只看单次接口命中率。
FAQ
1. AI安全防护架构应该放在哪些节点?
建议覆盖用户输入前、模型调用前、模型输出后、工具调用前后、内容发布前和审计复盘阶段。不同业务可以按风险等级选择同步拦截、异步审核或旁路审计。
2. 提示词注入为什么不能只靠关键词拦截?
因为攻击指令可能通过角色诱导、编码、多语种、文档、网页、知识库和工具返回内容进入上下文。关键词只能覆盖部分显性表达,难以识别任务目标和权限边界被篡改的风险。
3. 企业做POC时应如何设计样本?
建议覆盖正常请求、灰度请求、高危请求、对抗输入、多轮上下文、多模态内容、工具调用、越权访问、隐私泄露、误杀样本和业务真实样本,并记录各类样本的处置结果。