
下面说的主要是lucene如何进行搜索,相比于建索引,搜索可能更能提起大家的兴趣。
lucene的主要搜索的API
下面通过表格来看一下lucene用到的主要的搜索API
| 类 | 目的 |
| IndexSeacher | 搜索操作的入口,所有搜索操作都是通过IndexSeacher实例使用一个重载的search方法来实现 |
| Query(及其子类) | 具体的Query子类为每一种特定类型的查询进行逻辑上的封装。Query实例被传递到IndexSearcher的search方法中 |
| QueryParser | 将用户输入的(并且可读的)查询表达式处理为一个具体的Query对象 |
| TopDocs | 保持由IndexSearcher.search()方法返回的具有较高评分的顶部文档 |
| ScoreDoc | 提供对TopDocs中每条搜索结果的访问接口 |
对特定项进行搜索
其中IndexSearcher是对索引中文档进行搜索的核心类,我们下面的例子中就会对subject域进行索引,使用的是Query的子类TermQuery。
测试程序如下:

 View Code
 1   public void testTerm() throws Exception {
 2     Directory dir = TestUtil.getBookIndexDirectory(); //A
 3     IndexSearcher searcher = new IndexSearcher(dir);  //B
 4
 5     Term t = new Term("subject", "ant");
 6     Query query = new TermQuery(t);
 7     TopDocs docs = searcher.search(query, 10);
 8     assertEquals("Ant in Action",                //C
 9                  1, docs.totalHits);                         //C
10
11     t = new Term("subject", "junit");
12     docs = searcher.search(new TermQuery(t), 10);
13     assertEquals("Ant in Action, " +                                 //D
14                  "JUnit in Action, Second Edition",                  //D
15                  2, docs.totalHits);                                 //D
16
17     searcher.close();
18     dir.close();
19   }
当然在不同的情况下你可以改变其中的代码来搜索你想要的东西。
解析用户查询
lucene中解析用户的查询需要一个Query对象作为参数。那么也就是将Expression组合成Query的过程,这里边有一个对象叫QueryParser,它将前面传过来的规则的解析成对象然后进行查询。下面我们看下流程是如何处理的:
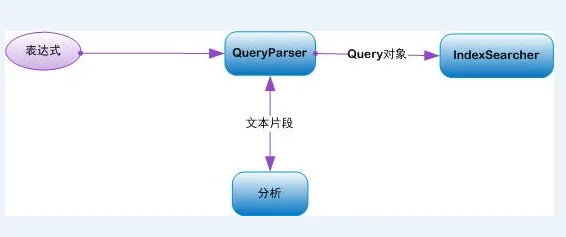
图:QueryParser对象处理复杂的表达式的过程
下面看一个程序示例,这个是基于lucene 3.0的,在后面的版本中会有所变化。
程序结构如下:
View Code
 1 public void testQueryParser() throws Exception {
 2     Directory dir = TestUtil.getBookIndexDirectory();
 3     IndexSearcher searcher = new IndexSearcher(dir);
 4
 5     QueryParser parser = new QueryParser(Version.LUCENE_30,      //A
 6                                          "contents",                  //A
 7                                          new SimpleAnalyzer());       //A
 8
 9     Query query = parser.parse("+JUNIT +ANT -MOCK");                  //B
10     TopDocs docs = searcher.search(query, 10);
11     assertEquals(1, docs.totalHits);
12     Document d = searcher.doc(docs.scoreDocs[0].doc);
13     assertEquals("Ant in Action", d.get("title"));
14
15     query = parser.parse("mock OR junit");                            //B
16     docs = searcher.search(query, 10);
17     assertEquals("Ant in Action, " +
18                  "JUnit in Action, Second Edition",
19                  2, docs.totalHits);
20
21     searcher.close();
22     dir.close();
23   }
其实主要就是A和B两部分,将规则解析成lucene能识别的表达式。
下面的表格中列出了查询表达式的范例:
| 表达式 | 匹配文档 |
| java | 在字段中包含java |
| java junit java or junit |
在字段中包含java或者junit |
| +java +junit java and junit |
在字段中包含java以及junit |
| title:ant | 在title字段中包含ant |
| title:extreme -subject:sports title:extreme AND NOT subject:sports |
在title字段中包含extreme并且在subject字段中不能包含sports |
| (agile OR extreme) AND methodology | 在字段中包含methodology并且同时包括agile或者extreme |
| title:"junit in action" | 在title字段中包含junit in action |
| title:"junit action"~5 | 包含5次junit和action |
| java* | 包含以java开头的,例如:javaspaces,javaserver |
| java~ | 包含和java相似的,如lava |
| lastmodified:[1/1/04 TO 12/31/04] | 在lastmodified字段中值为2004-01-01到2004-12-31中间的 |
接下来测试一下QueryParser的各个表达式,程序结构如下:
View Code
 1 public class TestQueryParser {
 2
 3     public static void main(String[] args) throws Exception {
 4
 5         String[] id = { "1", "2", "3" };
 6         String[] contents = { "java and lucene is good",
 7                 "I had study java and jbpm",
 8                 "I want to study java,hadoop and hbase" };
 9
10         Directory directory = new RAMDirectory();
11         IndexWriter indexWriter = new IndexWriter(directory,
12                 new IndexWriterConfig(Version.LUCENE_36, new StandardAnalyzer(
13                         Version.LUCENE_36)));
14         for (int i = 0; i < id.length; i++) {
15             Document document = new Document();
16             document.add(new Field("id", id[i], Field.Store.YES,
17                     Field.Index.ANALYZED));
18             document.add(new Field("contents", contents[i], Field.Store.YES,
19                     Field.Index.ANALYZED));
20             indexWriter.addDocument(document);
21         }
22         indexWriter.close();
23
24         System.out.println("String is :java");
25         search(directory, "java");
26
27         System.out.println("\nString is :lucene");
28         search(directory, "lucene");
29
30         System.out.println("\nString is :+java +jbpm");
31         search(directory, "+java +jbpm");
32
33         System.out.println("\nString is :+java -jbpm");
34         search(directory, "+java -jbpm");
35
36         System.out.println("\nString is :java jbpm");
37         search(directory, "java jbpm");
38
39         System.out.println("\nString is :java AND jbpm");
40         search(directory, "java AND jbpm");
41
42         System.out.println("\nString is :java or jbpm");
43         search(directory, "java or jbpm");
44     }
45
46     public static void search(Directory directory, String str) throws Exception {
47         IndexSearcher indexSearcher = new IndexSearcher(directory);
48         Analyzer analyzer = new StandardAnalyzer(Version.LUCENE_34);
49         QueryParser queryParser = new QueryParser(Version.LUCENE_34,
50                 "contents", analyzer);
51         Query query = queryParser.parse(str);
52         TopDocs topDocs = indexSearcher.search(query, 10);
53         ScoreDoc[] scoreDoc = topDocs.scoreDocs;
54         for (int i = 0; i < scoreDoc.length; i++) {
55             Document doc = indexSearcher.doc(scoreDoc[i].doc);
56             System.out.println(doc.get("id") + " " + doc.get("contents"));
57         }
58         indexSearcher.close();
59     }
60 }
运行程序就会得到输出结果。
搜索用到的各个类的相互关系
我想看图应该会比较清晰,下面的图比较清晰的组合了程序的结构:
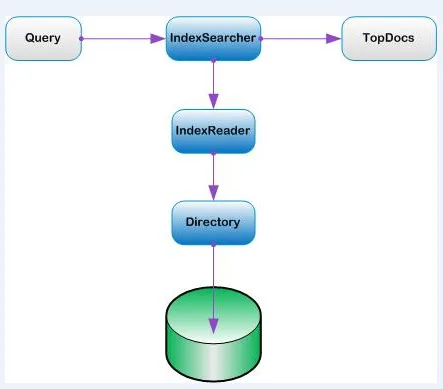
图:搜索用到的各个类的相互关系
搜索结果分页
其实这个所谓的分页跟数据库的分页功能差不多,只是一个是从数据库中读取数据,而一个是从索引文件中找到对应的数据。
在lucene搜索分页过程中,可以有两种方式:
- 一种是将搜索结果集直接放到session中,但是假如结果集非常大,同时又存在大并发访问的时候,很可能造成服务器的内存不足,而使服务器宕机
- 还有一种是每次都重新进行搜索,这样虽然避免了内存溢出的可能,但是,每次搜索都要进行一次IO操作,如果大并发访问的时候,你要保证你的硬盘的转速足够的快,还要保证你的cpu有足够高的频率
而我们可以将这两种方式结合下,每次查询都多缓存一部分的结果集,翻页的时候看看所查询的内容是不是在已经存在在缓存当中,如果已经存在了就直接拿出来,如果不存在,就进行查询后,从缓存中读出来。比如:现在我们有一个搜索结果集 一个有100条数据,每页显示10条,就有10页数据。按照第一种的思路就是,我直接把这100条数据缓存起来,每次翻页时从缓存种读取而第二种思路就是,我直接从搜索到的结果集种显示前十条给第一页显示,第二页的时候,我在查询一次,给出10-20条数据给第二页显示,我每次翻页都要重新查询。
第三种思路就变成了
我第一页仅需要10条数据,但是我一次读出来50条数据,把这50条数据放入到缓存当中,当我需要10--20之 间的数据的时候,我的发现我的这些数据已经在我的缓存种存在了,我就直接存缓存中把数据读出来,少了一次查询,速度自然也提高了很多. 如果我访问第六页的数据,我就把我的缓存更新一次.这样连续翻页10次才进行两次IO操作同时又保证了内存不容易被溢出.而具体缓存设置多少,要看你的服务器的能力和访问的人数来决定。
下面是一个示例程序没有做缓存,缓存的部分可以自己实现,也可以选择ehcache等开源的实现。
程序结构如下:
View Code
 1 public class TestPagation {
 2
 3     public void paginationQuery(String keyWord, int pageSize, int currentPage)
 4             throws ParseException, CorruptIndexException, IOException {
 5         String[] fields = { "title", "content" };
 6         // 创建一个分词器,和创建索引时用的分词器要一致
 7         Analyzer analyzer = new StandardAnalyzer(Version.LUCENE_36);
 8
 9         QueryParser queryParser = new MultiFieldQueryParser(Version.LUCENE_36,
10                 fields, analyzer);
11         Query query = queryParser.parse(keyWord);
12
13         // 打开索引目录
14         File indexDir = new File("./indexDir");
15         Directory directory = FSDirectory.open(indexDir);
16
17         IndexReader indexReader = IndexReader.open(directory);
18         IndexSearcher indexSearcher = new IndexSearcher(indexReader);
19
20         // TopDocs 搜索返回的结果
21         TopDocs topDocs = indexSearcher.search(query, 100);// 只返回前100条记录
22         int totalCount = topDocs.totalHits; // 搜索结果总数量
23         ScoreDoc[] scoreDocs = topDocs.scoreDocs; // 搜索返回的结果集合
24
25         // 查询起始记录位置
26         int begin = pageSize * (currentPage - 1);
27         // 查询终止记录位置
28         int end = Math.min(begin + pageSize, scoreDocs.length);
29
30         // 进行分页查询
31         for (int i = begin; i < end; i++) {
32             int docID = scoreDocs[i].doc;
33             Document doc = indexSearcher.doc(docID);
34             int id = NumericUtils.prefixCodedToInt(doc.get("id"));
35             String title = doc.get("title");
36             System.out.println("id is : " + id);
37             System.out.println("title is : " + title);
38         }
39
40     }
41
42     public static void main(String[] args) throws CorruptIndexException, ParseException, IOException {
43         TestPagation t = new TestPagation();
44          //每页显示5条记录,显示第三页的记录
45         t.paginationQuery("RUNNING",5,3);
46     }
47
48 }


