
很多自研紫微排盘项目,排盘计算逻辑写完之后,解读文案处理会变得很混乱:直接把大段文字写在代码里,或者零散存在 Excel,想要改一句解读、新增一条星曜注释,都要改代码重新发布。而且星曜、四化、宫位组合多,文案之间存在大量复用、互斥、叠加关系。 本文分享紫微斗数解读文本库的结构化设计思路,把解读文案从业务代码抽离出来,统一管理、按需组装,支持多版本、多风格解读,适合做命理测算类小程序、H5 后端的开发者参考。
一、传统文案方案的痛点
早期开发的时候,我试过直接在代码里写 if 判断拼接解读文本。 比如某颗星在命宫输出一段文字,换宫位就换另一段。随着星曜、辅星、四化、组合越来越多,if 分支层层嵌套,代码臃肿不堪。 还有几个很现实的问题:文案修改需要发版;不同风格文案(简洁版、详细版)混在一起;相同的星曜描述重复写很多遍;想要做后台可视化编辑,完全没法实现;统计哪些文案长期没被使用也做不到。
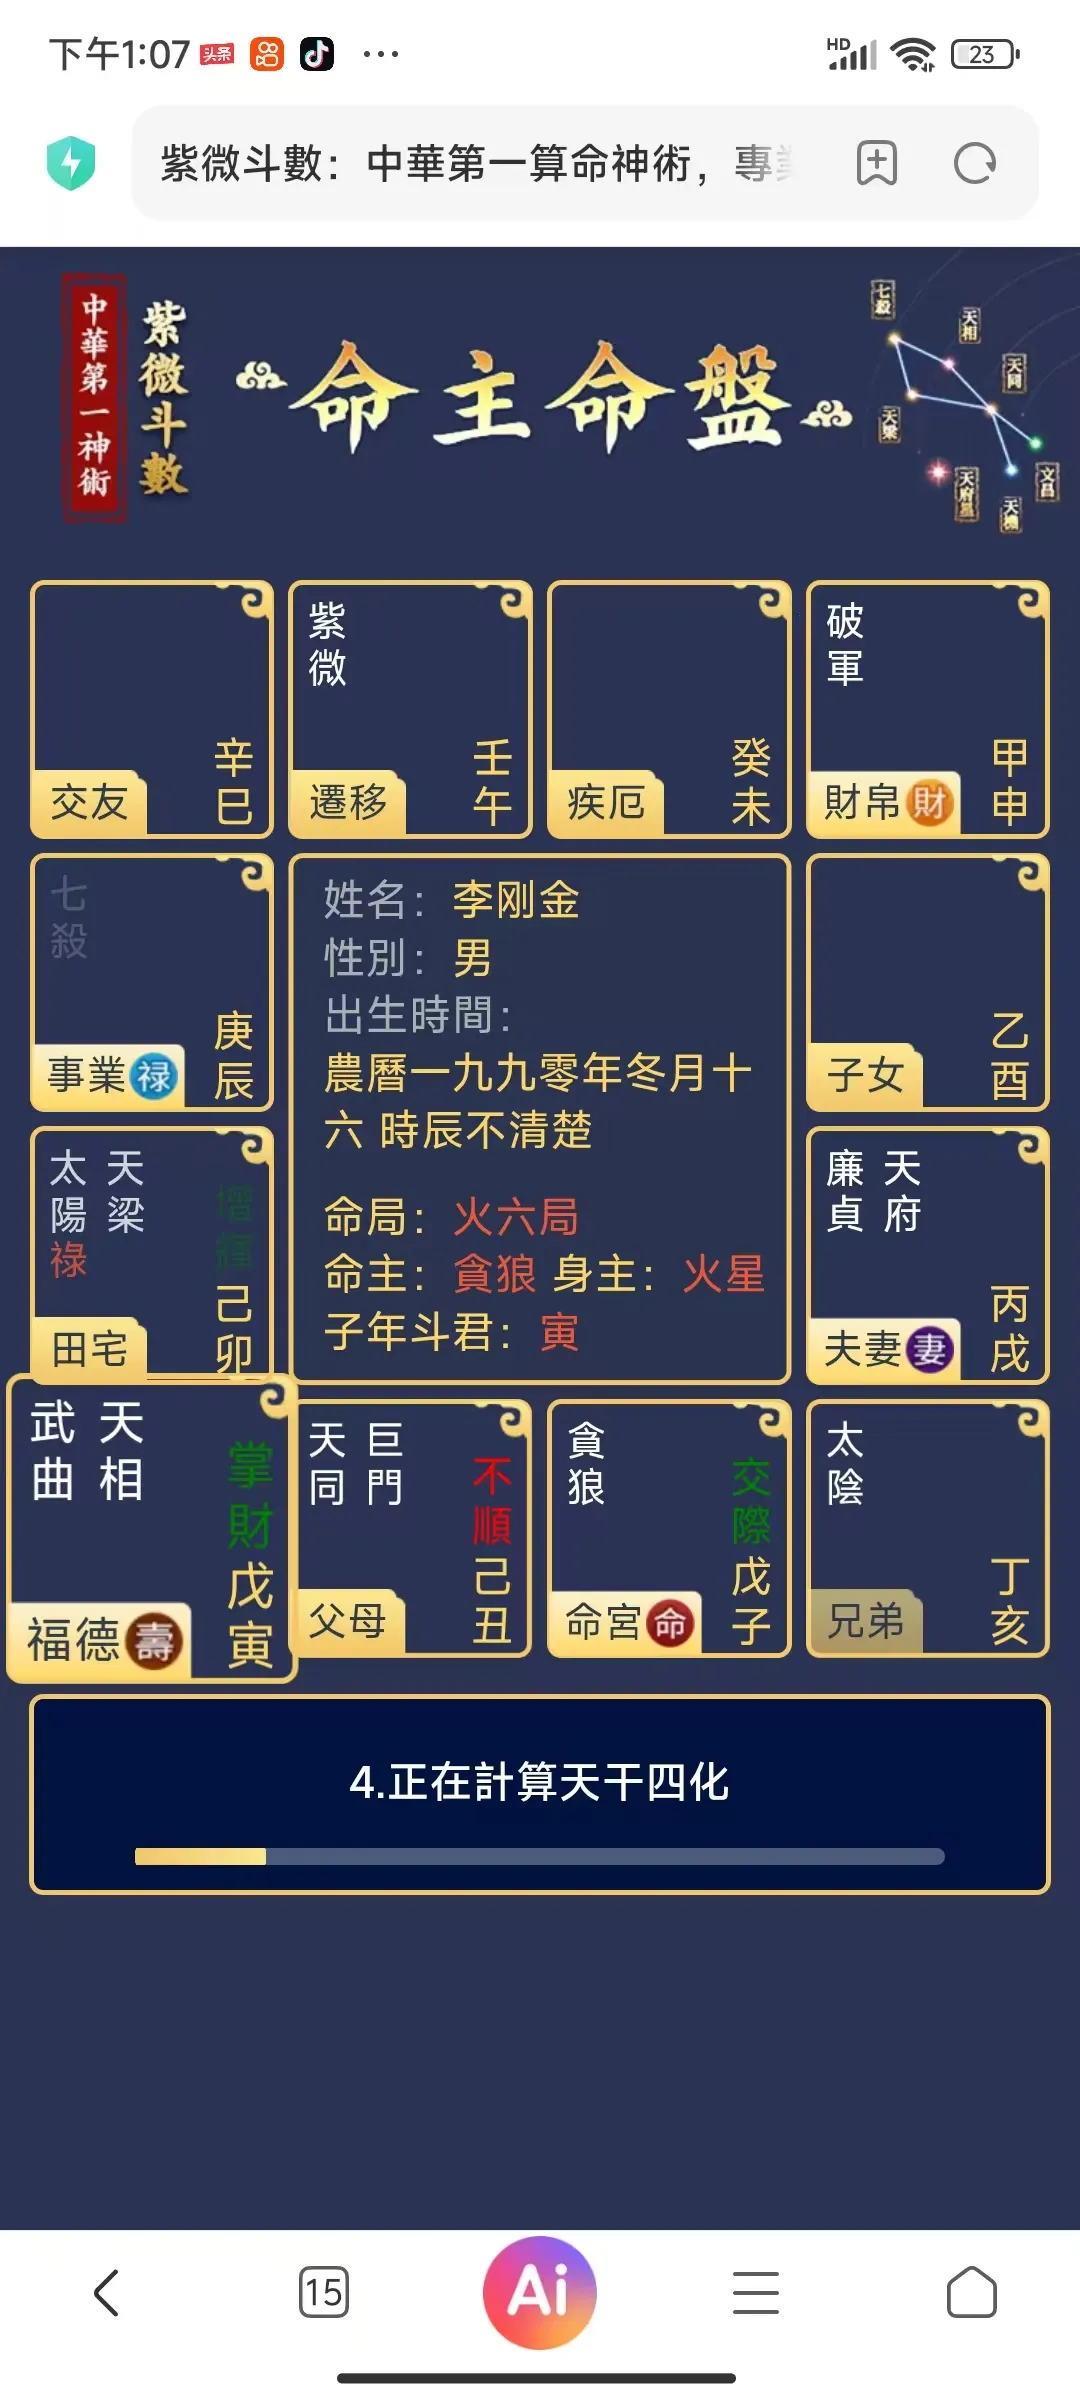
紫微解读不是单一文本,是组合式输出:主星基础含义 + 庙旺状态 + 四化变化 + 同宫辅星影响 + 所在宫位,多段文案叠加在一起,不能当成一整块固定文本。这也是一定要结构化的根本原因。
二、文本库整体分层思路
整体分为四层,由基础到组合:基础词条层、属性标签层、组合规则层、输出模板层。 基础词条:最小单元,单颗星曜、单个四化、单个宫位的原始释义,只写独立含义,不做场景绑定。 属性标签:给词条打上标签,区分庙旺落陷、吉凶、长短版本,方便筛选。 组合规则:定义什么时候展示、什么时候屏蔽、优先级谁高谁低,比如某些星同宫会互相抵消,部分四化优先级高于基础星曜解读。 输出模板:前端展示的排版框架,控制段落顺序、标题、换行,决定最终给用户看到的格式。
解耦之后,计算引擎只负责输出盘面数据,不碰解读文字;解读模块只负责根据盘面结果,去库里面匹配、拼接文案。
三、核心数据表设计思路
核心表主要分为这几张,不贴完整建表语句,只讲结构:
- 星曜词条表:存储主星、辅星、煞星基础释义,字段包含星曜名称、庙旺状态、简短解读、详细解读、备注。
- 宫位词条表:十二宫本身含义,比如命宫代表什么、财帛宫代表什么,和星曜独立分开。
- 四化词条表:化禄、化权、化科、化忌挂载在某星上的释义。
- 组合规则表:重点,用来存放星曜同宫组合的特殊断语,例如 “紫微天府同宫” 这类专属解读,优先级高于单星释义。
- 版本 & 风格表:区分标准版、精简版、古风版解读,后续可以给用户切换解读风格。
关键设计点:所有词条都有唯一 id,排盘结果只关联 id,不直接存文本。文案改动只改库中的记录,不需要修改排盘逻辑。
四、组装逻辑示例
拿到排盘输出数据之后,服务端组装逻辑大致流程:
- 遍历每一个宫位,取出宫位类型、宫内所有星曜、每颗星的庙旺、四化信息;
- 优先匹配高优先级的组合规则(同宫特殊格局);
- 再依次匹配单星释义、四化释义;
- 根据配置过滤互斥文案,避免内容冲突;
- 按照预设顺序拼接,最后套用模板返回给前端。
// 简化后的匹配逻辑
public List<ItemText> buildPalaceText(PalaceData palace){
    List<ItemText> result = new ArrayList<>();
    // 优先查询格局组合断语
    List<TextEntry> groupList = textRepo.queryGroupRule(palace.getStarList());
    result.addAll(groupList);
    // 再查询单星解读
    for(StarItem star : palace.getStarList()){
        TextEntry starText = textRepo.queryStarText(star.getName(), star.getMiaoWang());
        result.add(starText);
    }
    // 追加四化解读
    if(palace.getHua() != null){
        TextEntry huaText = textRepo.queryHuaText(palace.getHua(), palace.getMainStar());
        result.add(huaText);
    }
    return result;
}
五、几个很关键的规则设计
优先级控制是重中之重。格局、特殊组合 > 四化解读 > 单星基础解读。如果不做优先级,会出现断语冲突、重复啰嗦。 互斥过滤:有些断语不能同时出现,在规则表配置互斥 id,命中一条之后自动剔除另一条。 空宫处理:空宫不走星曜匹配逻辑,单独绑定空宫专属解读文案。 缓存配套:解读文本库变动频率很低,可以全量预热到 Redis,每次排盘读取文案不走数据库,提升响应速度。缓存 key 带上版本号,更新文案后变更版本号,自动刷新。
六、后台管理配套能力
结构化之后,就可以做可视化后台,运营人员直接维护文案,不用开发介入:
- 新增、编辑、上下线解读词条;
- 配置组合规则、互斥关系、优先级;
- 预览效果:输入一个生辰,直接预览这套盘的解读输出;
- 文案版本快照,误修改之后可以回滚。
这里有一个坑:不要把很长的排版标签、换行 HTML 写进文本库。文本库只存纯内容,样式交给前端模板渲染,方便 H5、小程序两端复用同一套文本。
七、踩坑复盘
- 一开始文案不分优先级,全部拼接输出,解读内容杂乱,长篇大论,用户看不懂;
- 没有做版本隔离,改文案直接覆盖线上内容,想回退找不到旧版本;
- 把 HTML 样式写进解读文本,小程序和 H5 渲染差异,一端正常一端乱码;
- 缺少组合规则表,很多经典格局只能硬编码,新增格局就要改代码;
- 没有做缓存,每次排盘都查询大量文本,数据库压力上涨。
八、总结
紫微斗数解读文本库结构化,本质就是把 “散在代码里的断语” 变成一套可配置、可复用、可运营的素材库。 排盘引擎只管计算星曜位置,解读模块只管匹配组装,两者彻底解耦。这套方案上线之后,后续调整解读风格、新增格局、修改话术,都不用改动排盘核心代码。
