一句话定位:这不是"哪个 Agent 更能干活",而是"它交出的一整套文件里,结论之间还对得上吗"——被测对象是跨产物的依赖链,不是单个文件的质量。同样的断言可迁移到月度经营分析、跨表对账、多级审批附件、投标材料套件、测试报告与缺陷清单的对应。
摘要
Theseus Lab 开源的 DeliverBench 让七个 Agent 系统去接完整项目——连续做、接自己上一轮的成果、处理陆续到达的材料,最后交付可验收的结果。结果是:11 个项目的最高平均最终交付分 65.0/100,按 90 分子任务阈值算,最高通过率 50.0%。最值得测试团队抄的不是这个分数,是它点出的错误传播方式:错在第一步,之后每一步都"正确地"建立在这个错误上。这篇给出三个可执行的检查:依赖链上的证据锚点、影响面重算清单、以及为什么"每个产物单独审"这类验收在这种任务上必然失效。
一个再融资项目里,出了这样一处错。
一个再融资项目,模型把公司的全部借款误当成了某笔贷款的待偿余额。一个口径错误,不知道用了哪份材料的哪一行。
接下来它的表现其实很好。它生成了文件,一个接一个,格式规矩,步骤连贯,每一步都完成了。"每步都生成了文件,整套成果却建立在同一个错误上。"
这个例子出自 Theseus Lab 在 DeliverBench 上的实测说明。DeliverBench 是他们在 2026 年 11 月 9 日公开的开源评测之一,做法很直接:让 Agent 系统接手完整的专业项目——接着自己的成果往下做,处理陆续到来的材料和反馈,最后交出可验收的东西。测的不是单步能力,是"能不能把一件事从头做到交付"。
分数是:11 个项目、七个 Agent 系统,前沿模型的最高平均最终交付分 65.0/100。如果以 90 分作为子任务通过的阈值,最高通过率只有 50.0%。
来源属性说明:这是研究机构自建的评测,通过媒体转述公开,数字为评测方自报,样本是 11 个项目、七个系统。它不是模型排行榜,也不该被读成某家模型的能力结论。
我关心它,是因为它描述的错误传播方式,和测试团队每天在处理的东西是同一个东西。
为什么"每个产物单独审"在这种任务上必然失效
传统的验收方式是逐件审:这份报告写得对不对、这张表算得准不准、这份结论有没有依据。审完之后如果每件都对,整体就应该是对的。
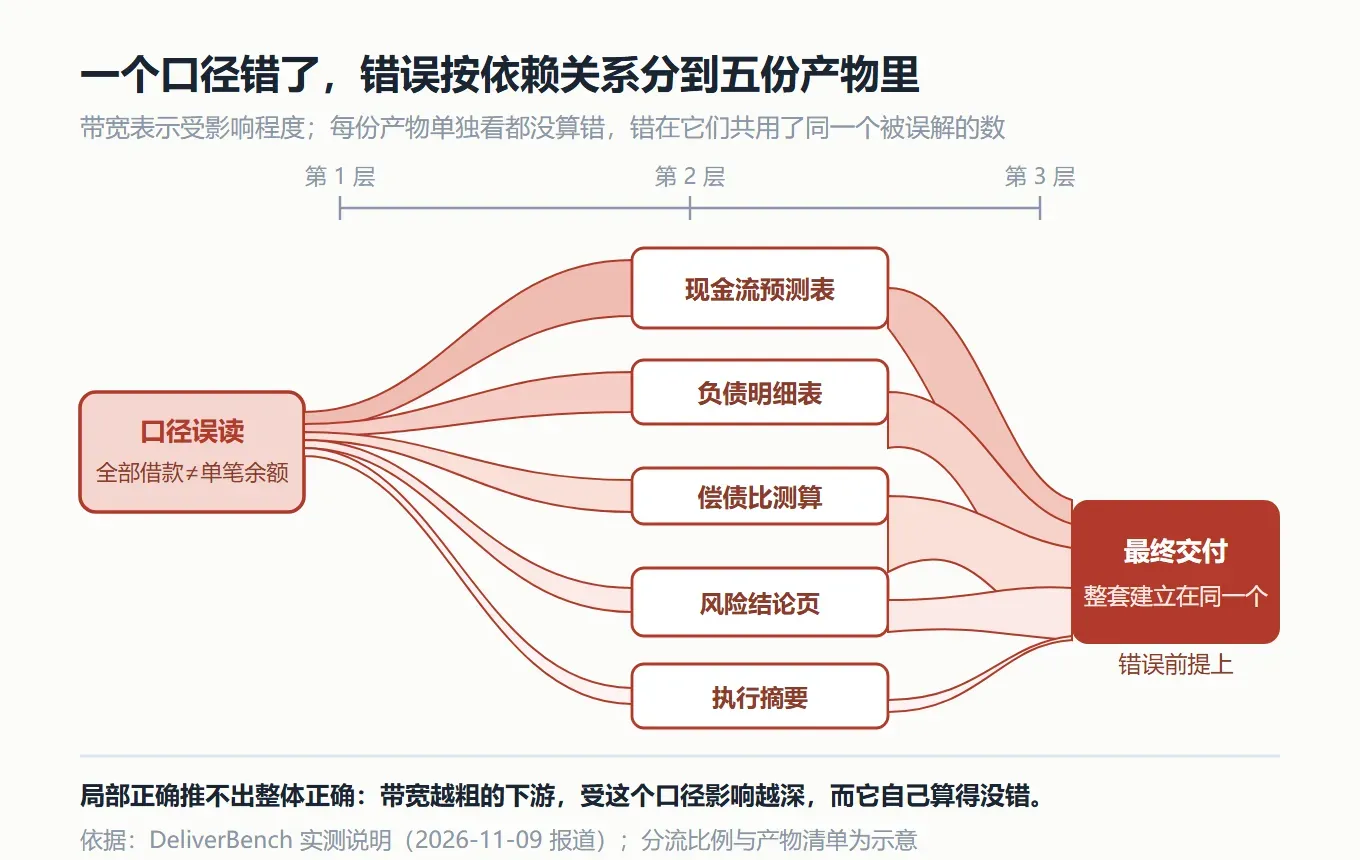
DeliverBench 描述的这种任务打破了这个前提。原因是产物之间有依赖:第一份文件里定义了"待偿余额"是哪个数,后面所有引用这个数的计算、图表、结论,都会继承这个定义。
单独看,后面每一份都没算错。错的是第一份的口径,而第一份本身看起来也没错——它只是用了另一个合法的口径。
这类错误的特征是:局部正确性无法推出整体正确性。要抓住它,只能沿着依赖链做一致性验证。
这张图把这条传播路径画成桑基式的分流:一个口径错误进入链条后,按依赖关系分到多个下游产物,带宽表示受影响的产物数量。
原文自己给的三个问题,其实就是三条断言
报道里那段话最实用的地方,是它把"下一步要解决什么"拆成了三个问句:
如何识别修改的影响范围——输入变化后,哪些计算报告和决策需要重新检查。
如何维护证据与结论的联系——怎样避免未经核实的假设被当成确定事实。
如何发现并修复早期错误——修复文件后,如何确认依赖它的也更新。
这三句每一句都能直接变成一条断言,而且都不需要模型配合,只需要工程上留痕。
第一句对应影响面断言:给定一次输入变更,系统能列出受影响的产物清单。测试方式很简单——把输入 A 改一个值,看它给出的"需要重算"清单,和你手工推导的清单是不是同一批。清单少了就是漏,多了就是过度。
第二句对应证据锚定断言:每一个结论性的数字或判断,必须能追到一条具体证据(哪个文件的哪一处、什么时间、来源是谁)。追不到,这个结论就不该被采信。这一条对 Agent 生成的内容尤其重要,因为它的默认行为是"顺畅地写下去",不会主动标注哪一句是推断。
第三句对应修复传播断言:改掉上游文件后,下游产物必须同步更新。这一条最难,因为它需要系统知道"谁依赖了谁"。表结构变了、字段重命名了、口径调整了,依赖关系都会变。
三条断言里,第二条最容易做,第一条最有价值,第三条最容易被误认为已经做了。
为什么第三条最容易被误认为做了?因为大多数系统在"改文件"这件事上是实时的——文件改了,引用它的地方下次打开自然就变了。这在文档里成立,在交付物里不成立:报告里引用的那个数字是抄下来的,不是链接过去的。抄下来那一刻就断了。所以"自动更新"是错觉,"需要重算"才是常态。
还有一个原文没提、但一定会遇到的情况:修了上游,下游重算之后结论变了,但摘要没改。这种"半更新"比不更新更危险,因为正文和摘要打架,而审阅的人通常只看摘要。断言的写法是把摘要里的每个数字也当成一个节点,纳入同一次重算的范围。
65.0 这个分数该怎么读
先说该读出来的:在需要连续负责一个完整项目的任务上,当前前沿水平离"可交付"还有明显距离。 65.0 是平均最终交付分的上限,不是平均。
再说三个不该读出来的。
一,不能读成"模型不行"。这套评测的难度设计本身就是为了暴露短板——原文说得很清楚,设计初衷是"沿着完整项目链条做全流程检验,把那些短 demo 里看不见的隐患暴露出来"。难,是它的目的。
二,不能读成"某家模型 65 分"。原文给的是"七个 Agent 系统"的评测,最高平均分是系统层面的,归因到单个模型不成立。
三,不能读成"拆得越细越好"。拆得细能提高单步成功率,但每一步都有一次"证据转手",转手越多,第二句那条断言越难成立。这是一个真实的取舍,不是一个单向的优化方向。
把它落到你们团队的验收上
我不建议照着这套评测去建一个"项目级 Agent 验收"。成本太高,且大多数团队现在没有这类任务。
我建议做一件更小的事:找出你们现有交付物里,最依赖上游口径的那一条链。
比如测试报告里的"缺陷密度",依赖缺陷计数和代码行数两个上游数据;这两个上游里任何一个改了口径,报告结论就要重算。把这条链画出来,然后在链的每个节点上加一个字段:本节点使用了上游的哪个字段、哪个版本。
这个字段的成本很低,收益是:下次上游变了,你能机械地列出需要重算的清单,而不是靠人回忆。
如果连字段都不想加,有一个更轻的版本:在每个交付物的开头写一行"本文件依赖:X 表 v3、Y 口径说明第 2.1 条"。一行字,比结构化字段好落地,也能挡住大部分"改了下游没跟着改"的问题。等这条链稳定了,再考虑把它做成结构化的依赖图。
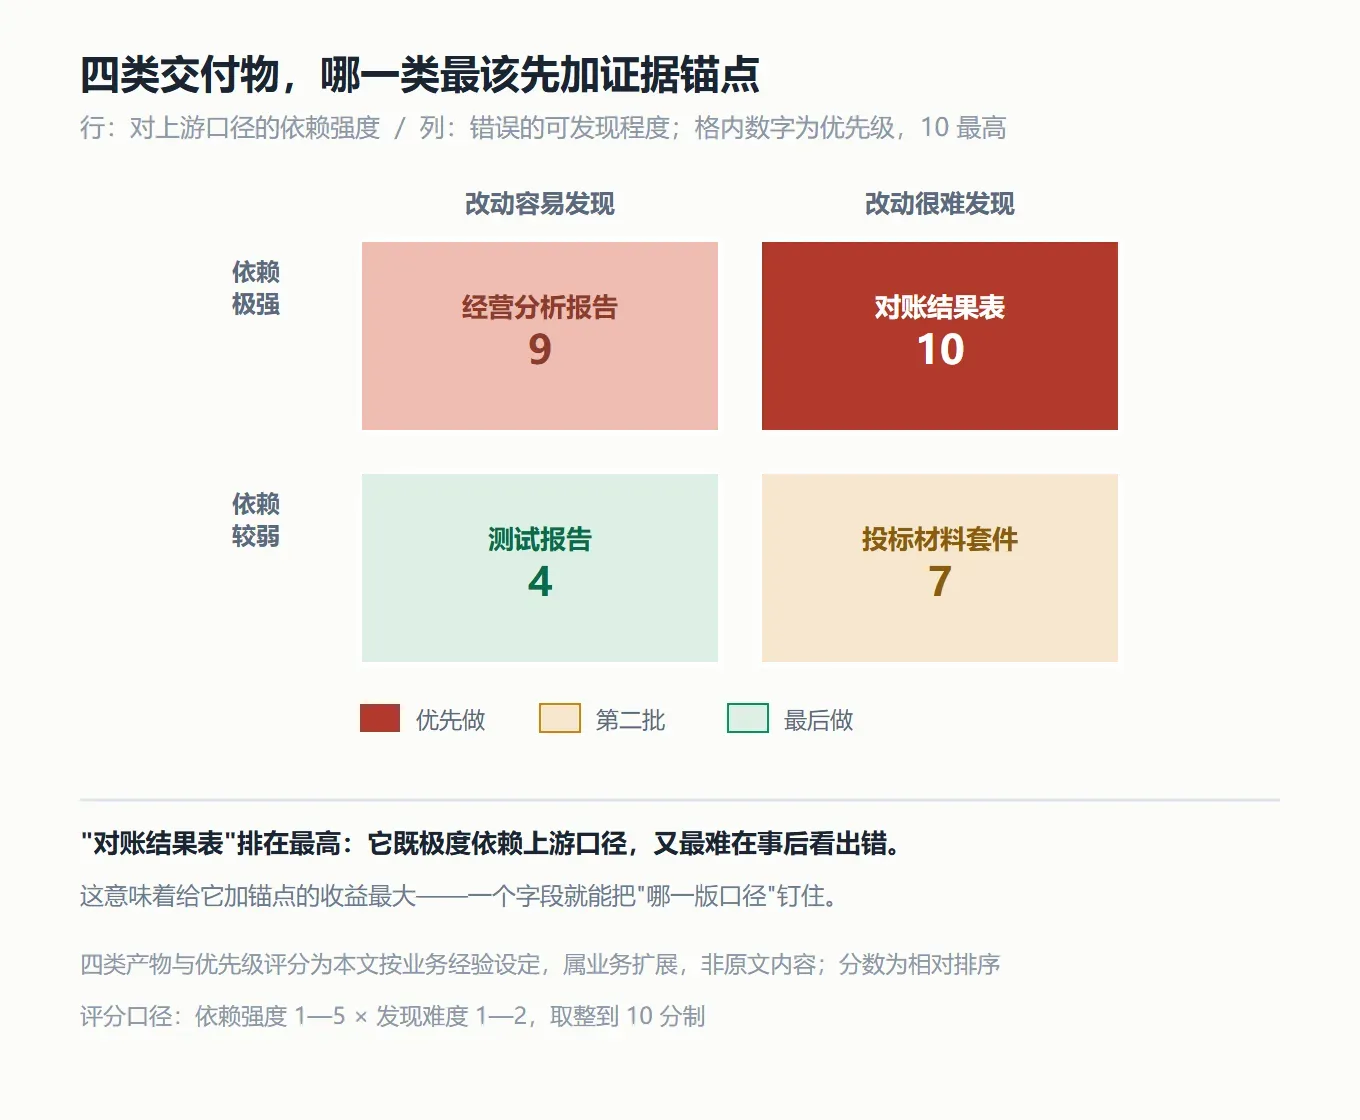
常见的四类交付物按"对上游口径的依赖强度"和"错误的可发现程度"两维排列,用来决定先给哪一类加锚点。
一句话判断
能交付,比能帮忙难一个量级。 差别不在能力,在责任链——能不能说清"这个结论是从哪儿来的、改了一处之后哪些要跟着改"。
原文那句"每步都生成了文件,整套成果却建立在同一个错误上",如果换成测试报告的语言,就是:所有用例都通过了,但断言测的不是需求。
这句话对做测试的人应该有刺痛感,因为它描述的正是我们自己最容易犯的错。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。