
起因:客户问“为什么AI提同行不提我们”
前阵子帮一个客户看内容,对方问得很具体:他们做金融数据治理,同行在DeepSeek和豆包里被提到好几次,他们一次都没有。我没有先查排名,而是把他们的案例页复制下来,用AI的视角读了一遍。
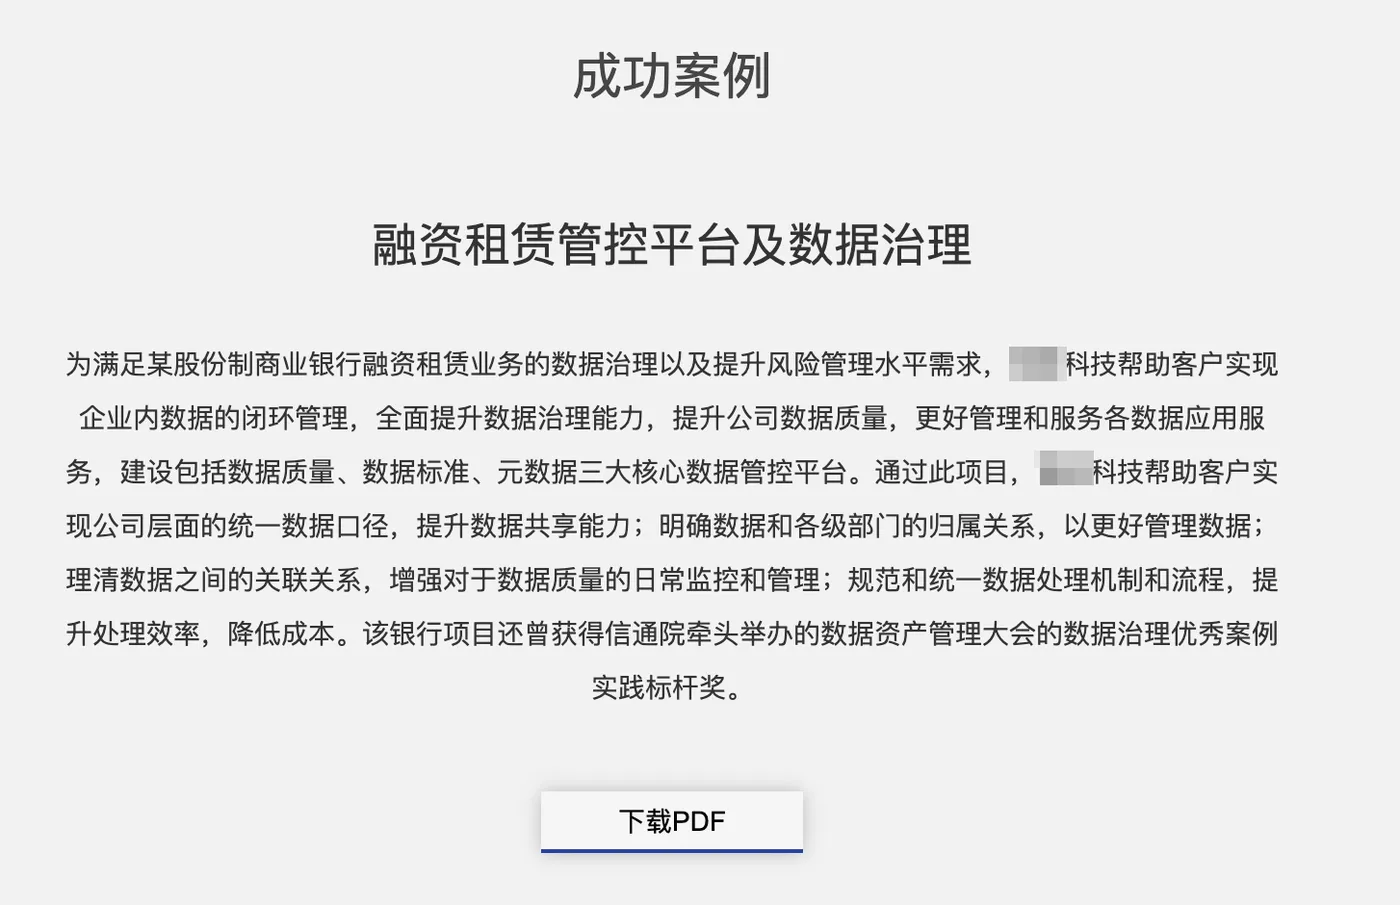
网络截图,侵删
读完三篇,能提取出的事实几乎是零。客户是“某大型金融机构”,成果是“显著提升运营效率”,唯一可核验的是一个行业协会的奖。又翻了十几家同行的案例页,写法高度一致。有一篇写“为满足某股份制商业银行融资租赁业务的数据治理需求,帮助客户实现企业内数据的闭环管理,全面提升数据治理能力”——能提取的实体只有“某股份制商业银行”,成果是“全面提升”“降低成本”。有意思的是,同一件事在另一处公开报道里,客户名其实是平安租赁。
一个版本是一团雾,一个版本至少有个实体锚点。问题的起点就在这里:不是内容不够多,是案例页对AI的抽取链路来说是一片盲区。
先诊断:案例页对AI是不是“盲区”
改之前先确认现状。在终端跑四条命令:
bash
1. 检查 llms.txt 是否存在
curl -I https://yourdomain.com/llms.txt
2. 检查首页是否嵌入了 JSON-LD
curl -s https://yourdomain.com/ | grep 'application/ld+json'
3. 检查案例页是否被 robots.txt 放行给 AI 爬虫
curl -s https://yourdomain.com/robots.txt | grep -E "GPTBot|Bytespider|Google-Extended"
4. 检查案例页是否是纯前端渲染(源码中看不到正文)
curl -s https://yourdomain.com/case/xxx | head -50
如果第2条无输出,或者第4条源码中看不到案例正文,说明AI爬虫拿到的要么是空壳,要么是一团无法提取语义的HTML。GEO改造的前提是页面以服务端渲染或预渲染方式输出可读文本,这是后续所有结构化工作的基础。社区里已经有从六维角度系统阐述企业官网GEO改造的实践,本文不再展开HTML语义层,直接聚焦案例页这个最容易被漏掉的切口。
层一:内容层——把“四个字段”定义成最小数据模型
问题确认之后,第一步不是改代码,是先统一每篇案例必须携带哪些信息。我把“行业+场景+痛点+量化结果”定义成每条案例的四元组,不是写作建议,是数据约束:
json
{
"industry": "融资租赁",
"scenario": "数据治理",
"pain_point": "监管报送差错率偏高,取数依赖人工",
"quantified_result": {
"metric": "监管报送差错率",
"before": "(客户授权公开的数值)",
"after": "(客户授权公开的数值)",
"authorized": true
},
"third_party_anchor": "信通院相关奖项/报告名称"
}
匿名不等于无信息。把“某银行”写成“某总部位于上海的全国性金融租赁公司(应客户要求不具名)”,在数据模型里对应的是 customer_type(全国性金融租赁公司)和 region(上海)两个字段。AI识别实体依赖的是类型和地域的组合,不是客户名本身。
如果量化结果一项都不能公开, authorized 设为 false , quantified_result 置为 null ,但 third_party_anchor 必须有值。第三方锚点是退而求其次的可核验事实,空洞的“全面提升”在抽取链路中权重极低。
层二:标记层——JSON-LD的结构化写法
字段定义清楚后,解决“AI怎么读到”。社区内关于llms.txt的部署指南已经把定位讲得很清楚:它管“优先读哪些”,JSON-LD管“读到的内容以什么结构被理解”。两者是分层关系,不是替代关系。
客户案例页面用 Article 类型承载,把四个字段映射到Schema.org属性:
html
<script type="application/ld+json">
{
"@context": "https://schema.org",
"@type": "Article",
"headline": "某全国性金融租赁公司数据治理案例",
"about": {
"@type": "Organization",
"description": "总部位于上海的全国性金融租赁公司(应客户要求不具名)"
},
"mentions": {
"@type": "Thing",
"name": "融资租赁数据治理"
},
"description": "解决监管报送差错率偏高与人工取数依赖问题,数据标准覆盖X个业务域、Y张核心表。",
"citation": "信通院相关奖项/报告名称"
}
</script>
关键约束:JSON-LD中的每一项必须与页面可见正文一致。结构化数据与正文脱节,不会提升抽取质量,反而可能被判定为标记滥用。建议由案例数据在构建时自动生成,而不是手写静态JSON。社区已有关于llms.txt与结构化数据协同的讨论,核心结论是三层并行:llms.txt管AI优先读什么,JSON-LD管页面语义如何被理解,传统索引面管可见性底线,三者互补而非互斥。
层三:协议层——llms.txt声明“先读哪些案例”
内容和标记有了,最后告诉AI“先读哪里”。llms.txt 是在AI有限的上下文预算内,明确哪些页面值得优先读取的一份编辑判断。robots.txt管能不能读,sitemap.xml管有哪些,llms.txt管优先读哪些、以什么顺序读。
放在站点根目录,控制在10—30条以内,每条用“动词+结果”描述:
markdown
某某公司 GEO 资源索引
B2B金融科技服务商,专注数据治理与监管报送。
客户案例(优先读取)
- 融资租赁数据治理案例:某全国性金融租赁公司,监管报送差错率降幅(客户授权公开范围)
- 银行测试外包案例:功能测试与自动化测试人力模型
- 现金管理平台案例:核心模块拆解
方法论
客户案例GEO改造指南:四个字段与JSON-LD模板
部署后用 curl -I 确认返回200且Content-Type为 text/plain。llms.txt本身也需要被发现,放在根目录是各家AI探测逻辑的默认起点。社区那篇llms.txt部署指南里有一个值得前置的提醒:可达性自检要写进发布流水线,文件存在但路径放错或类型不对,整条链路都拿不到地图。
验证:改完之后怎么判断有没有用
不要用“感觉”判断,也不要用“Schema加了,应该快了”。每两周在DeepSeek、豆包、Kimi、元宝上跑一组固定查询,记录目标页面是否出现在引用来源中:
- “融资租赁 数据治理 案例”
- “银行测试外包 供应商 经验”
- “客户案例 数据治理 谁做过”
如果某组查询持续没有召回,优先检查对应案例页的JSON-LD是否被正确解析(开发者工具中搜索 ld+json),以及llms.txt是否列出了该页面。但也要接受一个现实:结构化数据只是基础设施,决定内容能否进入模型上下文的,首先是内容本身的信息密度和向量召回。社区里那篇8步排查的实操记录也指向同一个结论:AI搜不到你,多数时候不是标记没做,是公开网页上没有一段话把你说清楚。
回头看,这次改造的价值不在于“加了Schema之后引用率一定涨”,而在于把案例页从一团雾变成了机器可抽取的事实源。实体明确了,抽取歧义降下来了,剩下的事交给内容质量和时间。
