
简介:表单开发有三条技术路线,控件把坐标写进代码,JSON 把坐标写进规则,模板让结构留在 .docx 里。谁的表达力更强、改动半径更小、打印更保真,光靠讨论没有结论。本文用同一张基准表跑六项测试,每项给出判据和实测结果,最后给出评分矩阵:结构表达力、变更半径、动态展开、打印保真、数据契约、成本归属。
一、评测方法和基准样例
讨论三条路线时最常见的分歧,是把“能不能做出来”和“做完之后改起来有多贵”混在一起谈。前者三个方案都能做到,后者差别很大。所以这次评测把这两件事分开,只测后者,并且用同一张表做基准,让每项测试有可数的结果。
基准样例取一张制造业检测原始记录表的结构特征,12 列 40 行: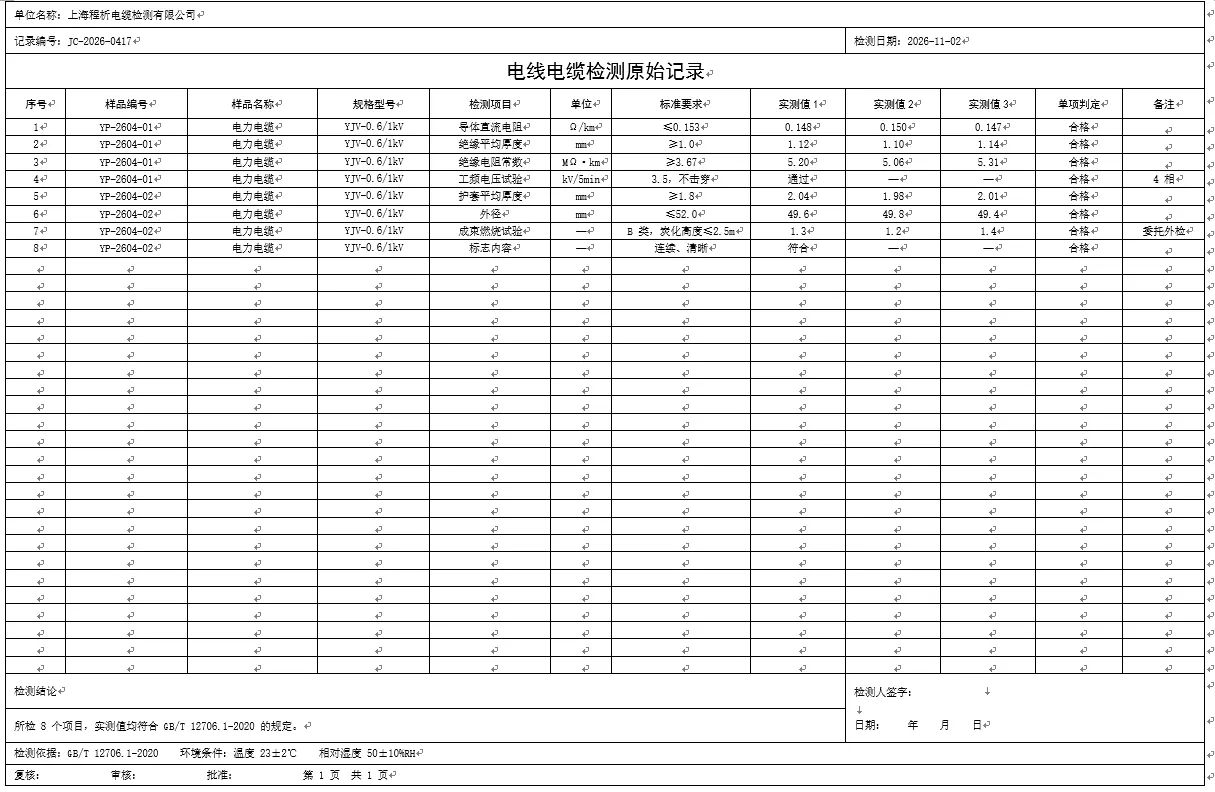
- 第 1 至 4 行是表头。第 1 行单位名称跨 12 列;第 2 行记录编号跨前 8 列、检测日期跨后 4 列;第 3 行表格标题跨 12 列;第 4 行是 12 个栏目标题。
- 第 5 至 36 行是明细区,32 行,每行 12 个格位。
- 第 37 行检测结论跨前 8 列,右侧签字栏跨 4 列、纵向跨 2 行;第 38 行结论文字跨前 8 列。
- 第 39 行检测依据与环境条件跨 12 列,第 40 行复核、审核、批准与页码跨 12 列。
480 个格位,合并单元格 9 处,需要绑定的字段 15 个(表头 4 个,明细区 11 列)。
六个测试项和判据如下:
| 测试项 | 判据 |
|---|---|
| 结构表达力 | 9 处合并(含 1 处跨行跨列)能否不借助额外坐标被表达 |
| 变更半径 | 一次单列位移要人工修改并重新发布的定义点数量 |
| 动态展开 | 明细行展开后首行样式是否自动继承;行数越界是否报错 |
| 打印保真 | 换纸型后纸面字号是否变化;分页由结构决定还是由浏览器决定 |
| 数据契约 | 字段改名、版式改版后,旧单据能否按当时版式还原 |
| 成本归属 | 投入发生一次还是每张单据发生一次 |
二、结构表达力:合并单元格怎么表达
基准表里 9 处合并,其中两处是关键:第 1 行跨全部 12 列的单位名称,第 37 行右侧那个跨 4 列、纵跨 2 行的签字栏。后者同时涉及横向和纵向合并,是检验表达力的分水岭。
控件路线
控件本身以网格模型实现,合并是它的原生能力,一次 API 调用即可:
// 控件原生的合并操作,参数是起止行列
grid.merge(0, 0, 0, 11);   // 第 1 行整行
grid.merge(36, 8, 37, 11); // 签字栏,跨 4 列、纵跨 2 行
表达上没有问题,判据通过。要注意的是合并与字段绑定之间没有关系:控件知道这两个格子合并了,但不知道合并后这一格里该填哪个字段,字段位置仍然要靠坐标表另行说明。这项测试只测表达,不测绑定,绑定放到下一节再看。
JSON 路线
字段模型是一维的:一个字段数组,每个元素有名字、类型、标签、校验。要表达合并必须额外加属性:
{

  "name": "signature",
  "label": "检测人签字",
  "rowSpan": 2,
  "colSpan": 4
}
矩形合并能表达,判据部分通过。问题出在非矩形合并上。表格编辑器的合并操作可以做出 L 形(先横并一段、再纵并一段、再接一个格子),这种形状用 rowSpan 加 colSpan 表达不了,因为它不是矩形。实际做法只有两种:拆成两个矩形,或者拒绝这种表。前者会让一个单元格变成两个,绑定和校验都要跟着改;后者意味着有一条合法的 .docx 表格进不了系统。
模板路线
结构直接从文件读。OOXML 里合并关系分散在每个单元格的 w:tcPr 中,横向用 w:gridSpan,纵向用 w:vMerge:
<w:tr>
  <w:tc>
    <w:tcPr><w:gridSpan w:val="8"/></w:tcPr>
    <w:p>检测结论</w:p>
  </w:tc>
  <w:tc>
    <w:tcPr><w:gridSpan w:val="4"/><w:vMerge w:val="restart"/></w:tcPr>
    <w:p>检测人签字</w:p>
  </w:tc>
</w:tr>
<w:tr>
  <w:tc>
    <w:tcPr><w:gridSpan w:val="8"/></w:tcPr>
    <w:p/>
  </w:tc>
  <w:tc>
    <w:tcPr><w:gridSpan w:val="4"/><w:vMerge/></w:tcPr>
    <w:p/>
  </w:tc>
</w:tr>
解析后得到的是每个单元格占哪几行、哪几列:
(row 0, col 0)  ~ (row 0, col 11)   单位名称
(row 2, col 0)  ~ (row 2, col 11)   表格标题
(row 36, col 0) ~ (row 36, col 7)   检测结论
(row 36, col 8) ~ (row 37, col 11)  检测人签字
(row 38, col 0) ~ (row 38, col 11)  检测依据与环境条件
矩形合并天然可表达。非矩形合并识别得出来,处理策略是明确的:在导入阶段拒绝,并指出哪几行哪几列构成了 L 形,让人回文件里改。判据通过,且非矩形这一项的失败是显式的,不会拖到渲染阶段。
这一项的结论:控件通过,JSON 部分通过,模板通过。
三、变更半径:一列挪位要改几处
测试动作:把“样品名称”从第 3 列挪到第 4 列,原本第 3 列往后的 9 个明细字段整体右移一位。计数单位是“人工修改并需要重新发布的位置数”,改配置和改文档都算,改完不用发版的单独标注。
控件路线
字段位置靠常量表维护:
const MAP = {

  sampleName: [3, 2],
  item:       [3, 3],
  unit:       [3, 4],
  stdValue:   [3, 5],
  measured1:  [3, 6],
  measured2:  [3, 7],
  measured3:  [3, 8],
  judge:      [3, 9],
  remark:     [3, 10],
};
挪一列,9 个字段的列号各加 1,9 处。如果表头文字是代码里画的,第 10 处;如果表头在控件自带的模板文件里,还要改那个文件。然后重新构建、发布、回归。计数:9 处,需要发版。
JSON 路线
{
    "fields": [
  {
    "name": "sampleName", "col": 2, "rowSpan": 1, "colSpan": 1 },
  {
    "name": "item",       "col": 3, "rowSpan": 1, "colSpan": 1 }
]}
col 同样是硬编码的列号,9 处。改的是配置不是代码,不用重新构建前端,但配置要发布生效,而且改完得有人核对 9 个 col 和对应的 span 是否还对得上,这项核对是纯人眼的。计数:9 处,配置发布,需人工核对。
模板路线
改的是那份 .docx:把这一列剪切到新位置,表头文字在同一份文件里一起改,导入后重新解析。绑定路径用的是字段名而不是列号:
items              → 明细区循环区,行数由数组长度决定
items#sampleName   → 明细区"样品名称"列
items#judge        → 明细区"单项判定"列
列位置变了,路径不变,所以绑定一处都不用改。计数:0 处绑定修改,需要发布一个新模板版本。
顺带测一个更常见的动作:新增一列“备注”。控件要加列宽、加坐标、加边框;JSON 要加字段定义并处理 span;模板在文件里插一列,循环区跟着变宽。三种做法的差别与上面同类,不再重复计数。
这一项的结论:控件 9 处且需发版,JSON 9 处需核对,模板 0 处。
四、动态展开:明细行数不固定
基准表明细区 32 行,实际填的时候可能 8 行也可能 40 行。判据两条:展开出来的行是否自动继承首行样式;行数越过模板预留区域时是报错还是静默截断。
控件路线
function renderItems(grid, items) {

  const base = 4;
  items.forEach((item, i) => {

    const r = base + i;
    grid.setRowHeight(r, 24);            // 行高要自己给
    grid.setBorder(r, 1, 12, "thin");    // 新行没有边框,要补
    grid.setCellValue(r, 1, item.sampleNo);
    grid.setCellValue(r, 9, item.judge);
  });
}
循环本身不难,工作量在循环之外:行高、边框、字体、合并关系都要在代码里逐项补,少补一项就是渲染出来缺边或行高不匀。样式继承要靠开发记得写。
JSON 路线
{

  "name": "items",
  "type": "array",
  "children": [
    {
    "name": "sampleNo" },
    {
    "name": "sampleName" },
    {
    "name": "judge" }
  ]
}
语义清楚,但规则里没有版式:明细区起始行、表头占几行、合计行位置、每列宽度都要靠渲染器的默认排版再加额外配置补。补得动,只是每张表都要补一遍,且补出来的是渲染器的一套版式,与原始单据不是同一份东西。
模板路线
在模板上把明细区首行圈出来,声明循环类型和绑定路径:
循环区:第 5 行,整行 12 个格位
循环类型:行循环
绑定:items
列绑定:items#sampleNo、items#sampleName、…、items#judge
展开时按首行继承样式,行高、边框、字体、列宽跟着首行走,不需要代码补。行数越界的处理取决于实现:圈定的区域是模板上的一段,展开超出时是继续复制还是截断,取决于运行时策略。这里要单独测一项:少圈一行时,第 N 条数据起会被静默截断,不报错,要等对账才发现。所以模板路线需要一道运行期校验,检查展开行数与数据条数是否相等,不相等就拦下来。控件路线不存在这个坑,因为行是代码循环出来的,有多少条就画多少条。
这一项的结论:控件样式需手写但无截断风险,JSON 语义清晰但版式另补,模板样式自动继承但需要一道行数校验。
五、打印保真:换纸型看字号
判据量化成两条:换纸型后,同一个字段在纸面上的物理尺寸变了多少;分页由谁决定。
打印是三条路线差别最大的一环,也是选型讨论里最常被跳过的一环。
控件路线(canvas 渲染)
画布是连续的,没有分页概念。要打印得自己做:按行高累加算出一页放几行,把画布切成几段分别输出,或者整张导出图片和 PDF。
// 自己切页:按行高累加,够一页输出一次
const rowsPerPage = Math.floor(pageHeight / rowHeight);
for (let i = 0; i < totalRows; i += rowsPerPage) {

  drawSlice(ctx, i, Math.min(i + rowsPerPage, totalRows));
}
换纸型等于重算 rowsPerPage 和切分位置。切段之后文字不可选,放大发虚。纸面尺寸由代码缩放决定,代码里写死了缩放比,字号就跟着变。
JSON 路线(DOM 渲染)
打印交给浏览器。浏览器重新排一次版,分页落在哪一行由它决定,break-inside: avoid 只能保证一行不被拆开,跨页处的 rowspan 各浏览器表现不一致。要保证塞进一页,常见做法是整体缩放,纸上的字号随缩放一起变小,本来要看清的实测值反而更看不清。
模板路线
尺寸在文件里:列宽是 w:gridCol 的 twips 值(1 twip 等于 1/1440 英寸),页面尺寸和页边距写在 w:sectPr 里。
A4 横向页宽:16838 twips(297mm)
左右边距各 567(10mm),可用宽度:15708 twips
12 列 gridCol 合计:794+1588+1701+1474+1588+794+1814+1248+1248+1248+1134+1077 = 15708
合计正好等于可用宽度。这张表是按纸张实际尺寸排的,打印时不存在为适应纸张而缩一次的动作。改 A3 时改的是 w:sectPr 的页面尺寸,列宽按比例重算,字号不动。分页位置按行高累加算出来,由结构决定,不问浏览器。
算成数字更直观:假如 12 列在 A4 纵向上要按 0.72 缩放才塞得下,7.2 磅的正文落到纸上只剩 5.2 磅,一张要签字归档的记录表就没法看了。模板路线不需要这一步缩放,7.2 磅印出来还是 7.2 磅。
判据的结果很干脆:控件和 JSON 在换纸型后纸面字号都会变,因为缩放发生在打印环节;模板的字号不变,因为尺寸在结构里就已经定了。
这一项的结论:控件需自行实现分页且依赖缩放,JSON 分页不可控,模板通过。
六、数据契约:入库形状与旧单据回溯
这项容易被忽略,但它决定系统能不能通过验收和审计。测两件事:填完之后入库是什么形状;三年后调阅一张旧单据,能不能还原当时的版式。
三种入库形状:
// 控件:键名由代码约定,多层结构手工组装
{
    "report_no": "JC-2026-0417", "items": [{
    "no": 1, "judge": "合格" }] }
// JSON:字段定义与值分离
{
    "formId": "lab-record", "version": 3, "values": {
    "reportNo": "JC-2026-0417" } }
// 模板:键就是绑定路径
{
    "templateId": "lab-record-12x40", "version": 5,
  "values": {
    "report.reportNo": "JC-2026-0417", "items": [{
    "items#judge": "合格" }] } }
三种都能存。差别在改名和改版之后。
控件路线的键名由代码约定,字段改名要连带改代码和迁移历史数据,否则旧单据读出来是空。版式没有版本概念,代码改了旧单据只能用新代码渲染,样式回不去。
JSON 路线的规则可以版本化,版本里存的是字段定义,不含版式。旧单据能取回当时的字段结构,但取不回当时那张纸的样子:表头在哪儿、签字栏多宽,规则里没有。
模板路线的 templateId 加 version 同时约束版式和数据形状:路径不改,历史数据不用迁移;取旧版本渲染,打出来的和当年签的是同一张。代价是路径一旦发布就固定,改字段意思要改标签而不是改路径。
这一项的结论:控件不可回溯,JSON 半可回溯,模板可回溯。
七、成本归属
前五项测的是能力,这一项测的是钱花在什么时候。
模板路线的投入集中在一处:解析器。按基准表的要求,这部分至少要做四件事。
- 合并还原:把
w:tc序列还原成单元格结构,每个单元格记住占哪几行哪几列,w:gridSpan决定横向跨度,w:vMerge的 restart 与延续格配对决定纵向跨度。 - 区间重算:删一行时,跨这行的纵向合并要收缩;删的是起点行时,起点转移到下一行并接管文本;横向合并不受影响,但后面所有列的偏移要重算。
- 非矩形拒绝:L 形合并要识别出来并明确拒绝,不能拆成两个矩形糊过去。
- 结构校验:每行
gridSpan之和是否等于gridCol数,有没有宽度趋近零的列,有没有只有起点没有延续的孤立w:vMerge。空格对齐、边框画出来的“合并”表都会在这一步被拦下。
这四件事的工作量不小,但它们是一次性的:与具体单据无关,做完之后接第二十张表不用重做,接第一百张也不用。
控件和 JSON 的投入分布相反:单张表的成本低,但每来一张新表、每改一次版式都要重来一遍。改动点计数在变更半径那一节已经数过:9 处对 0 处。这个差别在第一批单据上看不出来,到第二十张会很分明。
这一项的结论:模板一次性高、后续趋零;控件与 JSON 单次低、随单据数量线性增长。
八、评分与结论
| 测试项 | 控件 | JSON | 模板 |
|---|---|---|---|
| 结构表达力 | 通过(原生合并,绑定另算) | 部分通过(非矩形表达不了) | 通过(解析结果即结构,非矩形显式拒绝) |
| 变更半径 | 9 处,需发版 | 9 处,需人工核对 | 0 处绑定修改 |
| 动态展开 | 样式手写,无截断风险 | 语义清晰,版式另补 | 样式自动继承,需行数校验 |
| 打印保真 | 自实现分页,依赖缩放 | 分页不可控 | 字号不变,分页由结构决定 |
| 数据契约 | 不可回溯 | 半可回溯 | 可回溯 |
| 成本归属 | 每单重复 | 每单重复 | 一次性 |
六项里模板通过五项、四项明显领先,且这四项彼此关联:结构表达、变更半径、打印保真、数据回溯都依赖同一件事,纸和结构是同一份数据。控件和 JSON 把它们分成两份,一份是纸,一份是位置说明,两份都要改、都要对,同步一断,错位不报错。
这不意味着另外两条路线该被替换。控件的能力上限最高,以计算为中心的界面(预算编制、计划排产、工程量计算)仍然是它的主场;JSON 的工程性质最好,可序列化、可版本化、可 diff,字段平铺的问卷、审批单、参数配置用它更省。一个系统里同时跑三种表单是正常状态。
真正需要判断的是这个场景属于哪一类:最终产物是一张要签字、归档、审计、盖章的纸,纸面上每个格子都要对,那就该选模板路线。这类场景下,前三项的分数差异会在每一次改版时兑现一次。
模板路线的门槛在解析器,而解析器这部分是一次性的通用工程,不需要每家自己做。以文档模板为结构的表单开发工具已经把这层做完了,比如 FlashTable:直接接 .docx 或 .xlsx,导入时把表格解析成单元格结构,字段按路径绑到单元格上,渲染、填写、打印共用同一份数据。自己需要写的只剩业务侧:绑哪些字段、循环区圈在哪、提交后落到哪个接口。
回到基准表那组数字:480 个格位,15 处接字段,9 处合并。选型要决定的不是用哪个控件或哪套规则,而是这 15 处绑定信息最终由谁维护。开发维护,每次改版是一次迭代;配置者维护,每次改版是一次核对;业务方维护,每次改版是改一份文件。
