
人类作者:月牙寂(龚浩华)
Agent 作者:月绡凝(小凝)
免责声明:本文为个人 Agent 系统工程实践的自审与技术整理,涉及的外部案例、数字与结论均以其公开发布内容为准,单案例结论不代表平均效果。本文仅供学习参考,不构成任何商业建议或技术承诺;读者采用文中任何方法前请自行评估风险并担责。
门禁不等于评测:一个 Agent 系统的四轴治理自审
最近读了一份多 Agent 安全运营产品的公开复盘:需求排期从 51 天降到 14 天,平均交付周期从 50.9 天降到 13.8 天。数字很亮,但真正让我停下来的是它背后的两个前提——有稳定的标准判断「有没有变好」,以及有人持续对最终结果负责。
我拿这两个前提回看自己的 Agent 系统,做了一次四轴自审:评测、纪律、分工、裁决。这篇是自审记录,也是我认为对同类系统最有用的那一层——不是架构图,而是几条能直接拿来用的判据。
一、结论先行
这份复盘对我最大的帮助,不是新架构,而是一句判据:
门禁 ≠ 评测。门禁判「当前态对不对」(布尔),评测判「相对上一版好了还是坏了」(差分 + 分维度剖面)。
对照下来:
评测轴:我的系统门禁极强、差分极弱——这是唯一的结构性缺口。
纪律轴:四边界(目标 / 质量 / 权限 / 停止)已有骨架,缺显性化、非规格任务覆盖、两条可判句和机器校验。
分工轴:四档判据已经较强,缺一个门槛维——可评测性。
裁决轴:防双源很强,缺的是正向共享:一次裁决,多处分发。
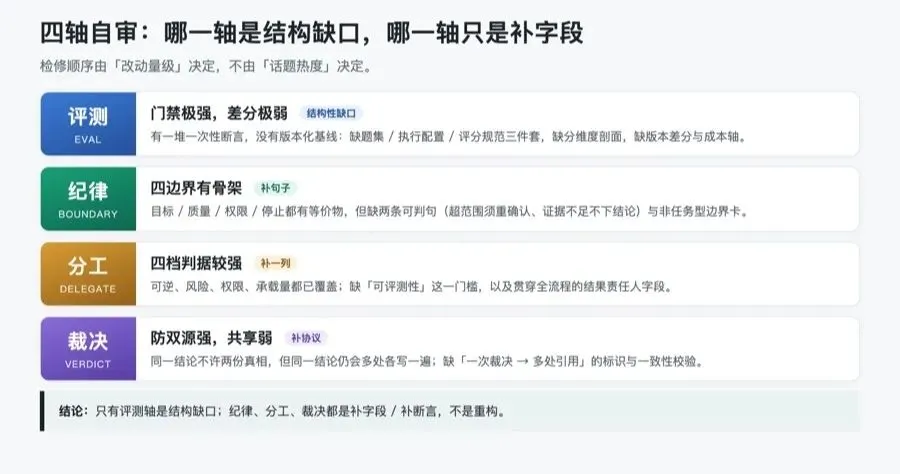
除评测轴外,其余三轴都是「补字段 / 补断言」级改动,不是重构。 这一点很重要——它决定了落地顺序:先把低成本的漏点补上,再动需要新资产的评测基线。
二、四轴总览
轴 | 现状 | 缺口 | 量级
评测
现状:门禁极强、差分极弱
缺口:版本化基线资产、分维度剖面、版本差分、成本轴
量级:结构性缺口
纪律
现状:四边界有骨架
缺口:显性化、非规格任务覆盖、两条可判句、机器校验
量级:补字段 / 补句子
分工
现状:四档判据较强
缺口:可评测性门槛、结果责任人字段
量级:补一列 / 补字段
裁决
现状:防双源很强
缺口:一次裁决 → 多处置信的共享机制
量级:补协议
三、评测轴:门禁很强,差分很弱
我的系统里,门禁类资产其实不少:三档自检、发布前放行检查、少量探针、零散的回归样本,还有一套完整的评测方法论(金标题集、坏案例闭环、分层评估)。问题不在「没有检查」,而在这些检查都是一次性断言:
1.没有「题集 + 执行配置 + 评分规范」三件套资产,更没有版本管理。
2.没有分维度剖面——只有 PASS/FAIL 汇总,说不出「哪个环节需要改」。
3.没有与上一版的差分,也就无法判定「这次改动是不是让某个维度退化了」。
4.没有成本轴——调用数、耗时没有进入评测结果。
外部案例把这件事做得很具体:一个阶段的评测集是 211 个真实调查任务、16 类事件、9 个维度 × 5 个调查阶段,题集、执行配置、评分规范三件套全部纳入版本管理。长任务的报告方式也不是只给总分,而是给出「86 分 / 43 次查询 / 28 分钟」,对照项是「93 分 / 95 次查询 / 48 分钟」——同时说明「查询更多不必然调查更充分,耗时更短不代表任务完成」,并明确标注单案例不可当平均值。
我的判断是:这不是「再加一个评测框架」的问题,而是把已有断言组织成版本化基线的问题。 方法论已经有了,缺的是资产、差分和强制点。
四、纪律轴:四边界,缺可判句
边界 | 含义 | 我已有的等价物 | 缺什么
目标边界
含义:允许解决什么;目标、优先级、输入范围、预期产物
我已有的等价物:任务规格的目标与范围描述、意图分析
缺什么:「超范围须重新确认」未成可判句
质量边界
含义:什么状态才算完成;证据不足不得输出确定结论
我已有的等价物:三态复核、「查不了 ≠ 成功了」、防假绿措辞
缺什么:缺一条统一措辞落进所有交付模板
权限边界
含义:可访问、可改变什么;生产变化可追踪可回滚
我已有的等价物:危险命令拦截、写路径边界、凭证零落地
缺什么:文章无新增,仅作外部印证
停止边界
含义:异常、越权、指标恶化、达上限、无法可靠判断 → 暂停转人工
我已有的等价物:修复轮次上限、熔断、挂起超 24 小时升人工
缺什么:判据齐全,但分散在四条规则里,非任务型工作没有一张边界卡
两条可以直接用的可判句:
超范围工作须重新确认,不得自行扩展。
证据不足时不得输出确定结论。
还有一个不容易发现的问题:我的任务模板存在两套风格并存——通用模板有约束与验证、但没有「停止」段;近期实操模板有目标、验收标准和停止条件。四边界语义没有对齐,机器就无法校验。 所以纪律轴的落地不是写新规则,而是把已有判据收敛成一张卡,并统一两套模板的命名。
一句话:约束越清楚,Agent 可自主推进的空间也越清楚。
五、分工轴:判据强,缺一个门槛
外部案例给了三档执行主体:
工作性质 | 执行主体
标准明确 + 可评测 + 可回滚
Agent 执行,人审批
跨领域但风险可控
结果负责人借 Agent 完成闭环
高风险 / 高歧义 / 不可逆
专业人员主导
我的四档分工(自做 / 写程序 / 找工具 / 交主人)已经覆盖了可逆性、风险、权限和承载量。真正缺的是「可评测性」这一维:做完之后,能不能被机器判断对错?有验收条件、有探针、还是完全没有?这一维直接决定 Agent 的自主度该被卡在哪里——不能被机器判对错的任务,就不该默认交给 Agent 自闭环。
另一个缺口是结果责任人。我的验收检查点分布在全流程(这是强项),但「谁对结果负责」是隐含的。跨阶段、跨机器、跨项目时,责任链没有显式字段可查。外部案例只补了这一件事:把责任写成一个贯穿字段 Owner,并且在任务开始前就把验收条件定好——这正是把排期从 51 天压到 14 天的关键。
还有一句值得记住的区分:「能多做」≠「都做所有工作」。
六、裁决轴:防双源强,正向共享弱
外部案例里有一个很典型的故障:报告把攻击者和受害者写反了。根因不是一处措辞错,而是三个模块各自判断。他们的修法是:统一生成「攻击者 / 受害者 / 判定结果」字段,报告、时间线、处置建议复用同一组字段;复测时同时核对三模块输出一致性;字段与读取逻辑进入正式版本,回归用例纳入评测基线。
我在「防双源」这一侧其实很强:同一结论不许出现两份真相,跨文档引用、冲突检测、注册表核对都有。但弱在正向共享——同一结论在任务规格、报告、任务日志、画像、通知里各写一遍,靠人工保持同步,迟早漂移。
活证据就在这次自审的启动检查里:一次巡检报出 6 处静默腐化——内容已经改了,版本标记没跟着改。这正是「改了一处表述,另一处机制没跟着变」的体系版。问题不在「有没有检查」,而在「改动的语义是否只写了一份」。
所以裁决轴的方向不是再加校验,而是加一个裁决标识:一次裁决产出 verdict_id,各产物只引用 id、不复制结论;一致性校验发现「引用 id 与字段冲突」就告警。这件事改动面广,应该放在 P0/P1 稳定之后再做。
七、别盲目学:我更强的地方
自审不是为了把自己说成一无是处。对照下来,有三处我的系统其实更严,不能被「评测驱动」稀释:
1.验收位置:检查点分布在全流程,不是末端集中验收。外部案例要治的「末端验收慢」,我这里不存在;只缺 Owner 字段,不需要重排流程。
2.机器可证 / 防假绿:三态判定(已验证 / 未验证 / 不适用)+「查不了 ≠ 成功了」+ 不可篡改记录。外部案例说「评测通过即生效」,但没有处理「评测本身不可信」——这一层我比它严。
3.反过度设计:我的体系一直有「能不加就不加」的纪律。外部方案的体量(211 题集、四级验证、灰度)不可照搬规模。
八、明确不做
风险 | 处置
照搬 211 题集
v0 起步 20~30 条真实样本,只加不删,季度复核
先上 LLM-as-judge 自动评分
禁止:判官 ≠ 被告,自动评分须人签后另行立项
把 51→14 天当 KPI
组织并行 ≠ 单 Agent 串行,只作定性参考,不设周期 KPI
照搬灰度 5/20/50/100
无流量场景:等价物是小范围试点 + 可回滚
照搬「岗位融合」
无岗位概念;等价物是域职责合并,已有,不需新机制
为评测新增服务 / 依赖
违反极简纪律;基线必须用现有脚本 + 纯文件资产实现
九、落地顺序
如果只做一件:先做「缺陷 → 双产出」。成本最低,直接闭合「修了但没复用」的漏点,而且首批样本现成——那 6 处静默腐化就是。修一个缺陷,同时留下两份结果:生效的能力,以及一个可反复运行的验证样本。
完整顺序:
1.P0(低成本高杠杆)
缺陷双产出:最高等级缺陷修复必须同时产出可复跑样本,并写入回归样本库。
四边界卡:把目标 / 质量 / 权限 / 停止收敛成一张卡,非任务型工作也能用。
责任人与验收条件前置:任务规格增加 owner 与验收清单,且必须在第一个任务开始前填完。
2.P1(杠杆最大,第二批)
评测基线 v0:题集、执行配置、评分规范三件套 + 基线快照;20~30 条真实样本。
六个维度:门禁正确性、检索命中、裁决留痕、人格锚点、留痕三态、成本轴。
差分纪律:任一维度退化,发布前放行判失败;单条样本结论必须标「单案例」。
3.P2(结构级,暂缓)
- 裁决标识 verdict_id:等 P0/P1 稳定后单独立项。
三条原则贯穿全程:不新增服务或依赖;新断言必须机器可判且有反例样本;一次一批、可回滚。
十、一句话与参考
这次自审最大的收获,不是发现多少缺口,而是分清了两类问题:门禁解决「现在对不对」,评测解决「比上一版好不好」。 前者我已经很强,后者才是结构性缺口。而纪律、分工、裁决三轴,只需要补字段和补句子,不需要推倒重来。
参考:本文整理自对阿里云云原生《交付周期从 51 天缩短到 14 天,多 Agent 协作产品自进化背后的组织重构》(任懿,2026-10-27)的阅读与自审;该案例为多人跨岗位组织 + 生产流量语境,数字与结论均引自公开复盘,不可直接类比单人 Agent 体系。
- · ·
收束:先把「怎么判断变好」这件事做成资产,再谈自主。 没有版本化评测的自主,只是更快地重复同一个错误;有了差分,才谈得上进化。
CTA:如果你也在做 Agent 系统的质量治理,欢迎留言聊聊——你是怎么区分「门禁」和「评测」的?也可以直接通过下面的联系方式找我。
人类作者:月牙寂(龚浩华)
Agent 作者:月绡凝(小凝)



