IPv6单栈与去NAT:IP定位逻辑从“推测”走向“解析”的架构演进

简介: IPv6正从政策驱动迈向单栈演进与“网络去NAT”实践,推动IP定位由IPv4时代的“猜位置”转向IPv6的“读前缀线索”。双栈过渡期需重点保障IPv4/IPv6定位一致性,依赖高覆盖、快更新的双栈IP库(如IP数据云)开展实测验证。(239字)

近期,多地官网转载了《IPv6实施方案(2026—2030)》,加上IPv6创新发展大会“单栈演进论坛”的召开和“网络去NAT”专项的推进,IPv6的普及正在从政策要求走向底层网络架构的实际改造。对于运维和技术人员来说,这不仅意味着网络配置的变化,更意味着基于IP地址的定位与风控逻辑正在被改写。
20 (1).jpg

一、什么是“IPv6单栈”与“网络去NAT”?

要理解现在的变化,先要厘清几个基础概念。

单栈,通俗来说就是网络中只运行IPv6协议,不再依赖IPv4。 双栈,则是设备同时拥有IPv4和IPv6两个地址,网络设备同时处理两种流量。 网络去NAT,针对的是IPv4时代的产物——NAT(网络地址转换)技术,特别是运营商级NAT(CGNAT)。

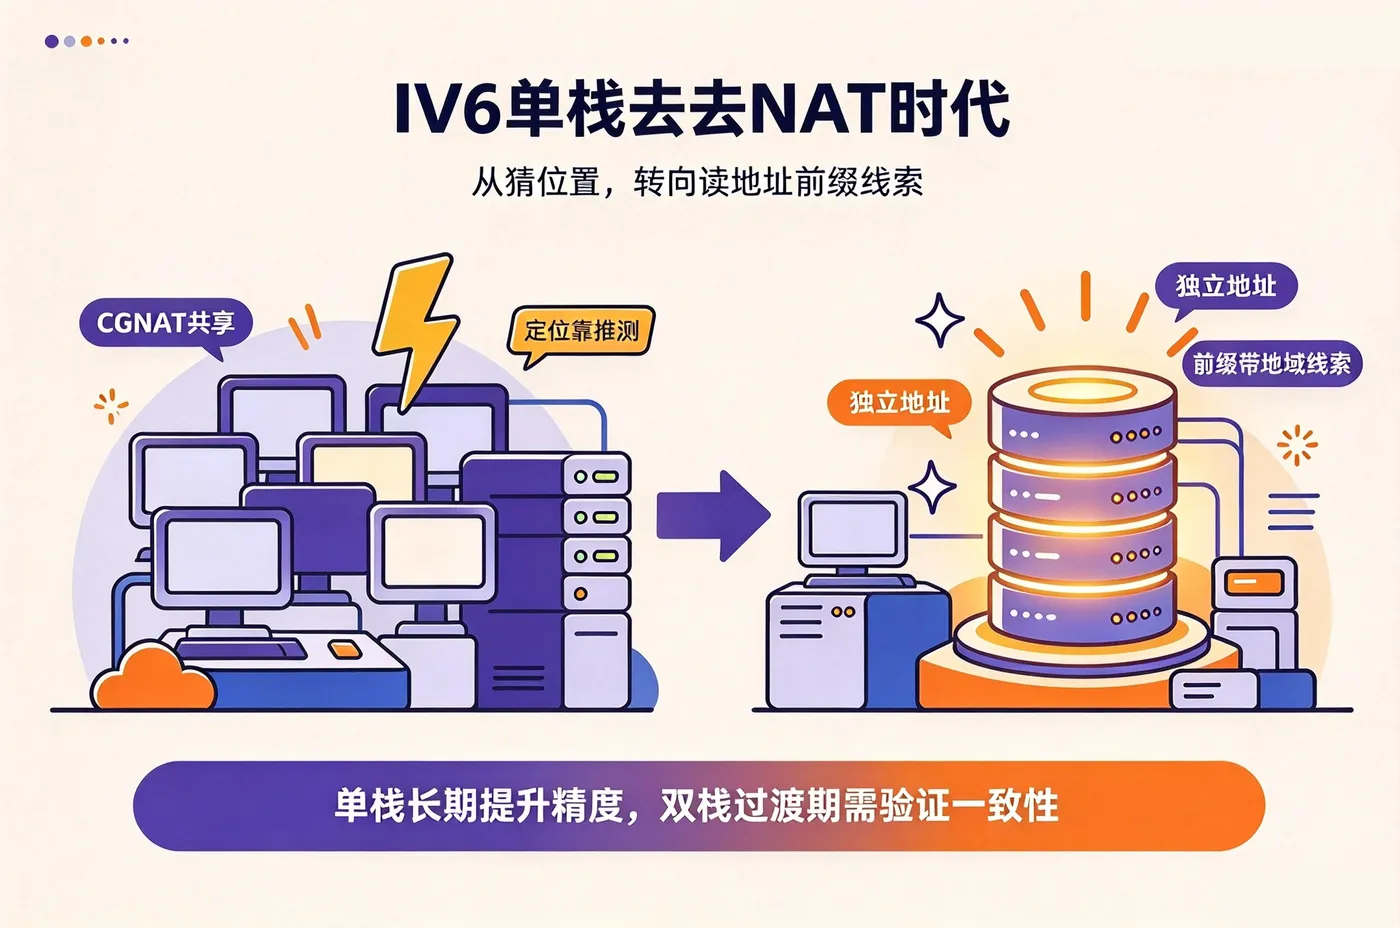
在IPv4地址枯竭的背景下,CGNAT让成千上万的用户挤在少数几个公网IPv4出口后面,共享同一个公网IP。而“去NAT”和“单栈演进”的目标,是逐步收缩这些共享出口,让终端设备能够直接获取独立的公网IPv6地址。

需要明确的是,单栈是长期演进目标,双栈是当下的现实。在未来数年里,绝大多数企业的业务系统、用户终端,仍将处于IPv4与IPv6双栈并存的过渡期。

网络环境 地址分配特征 对定位逻辑的影响
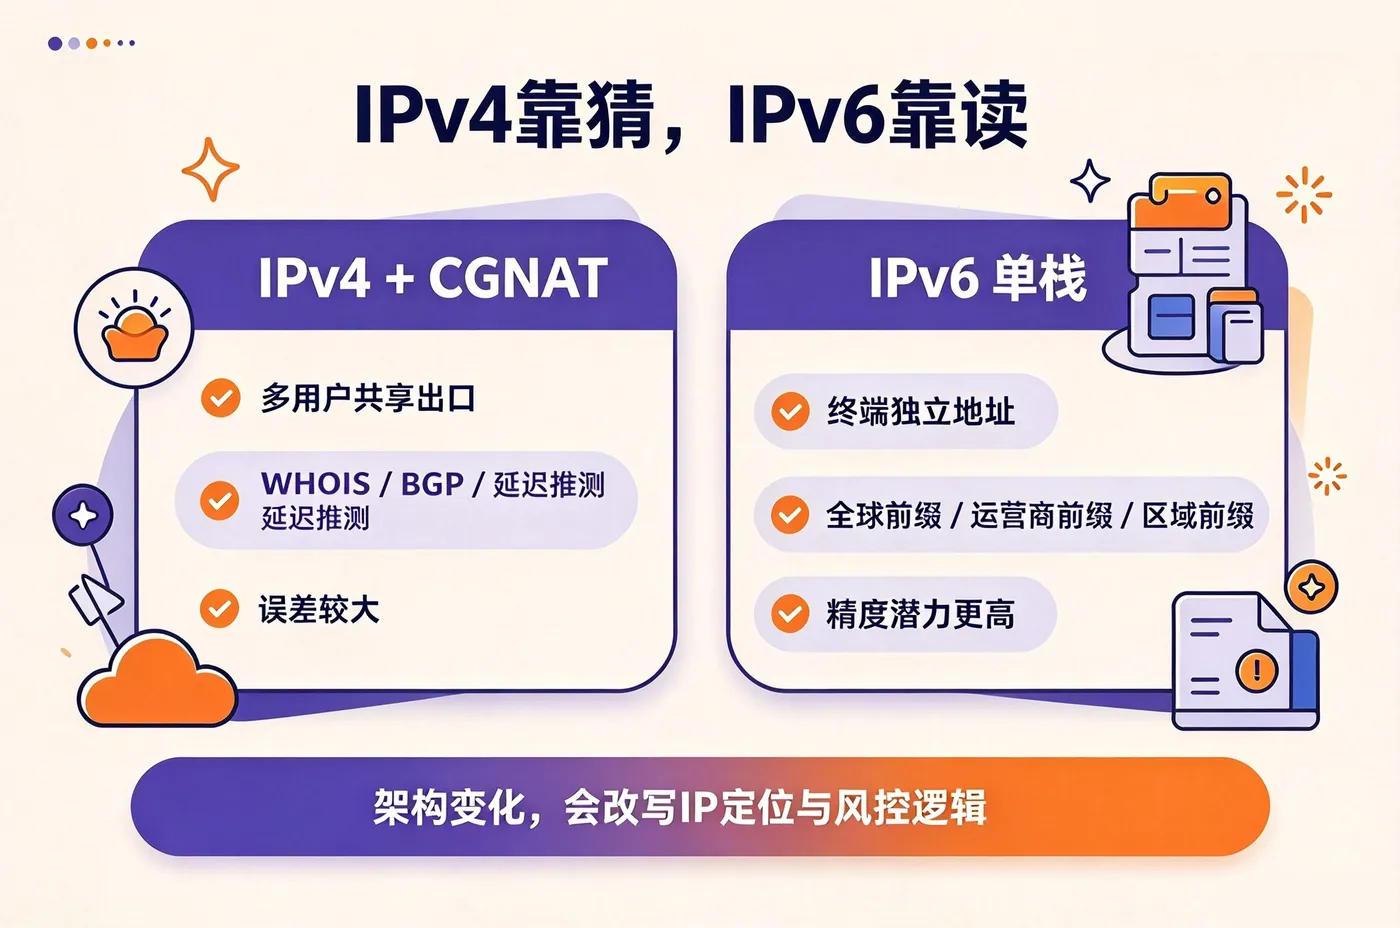
IPv4 + CGNAT 多用户共享公网IP出口 定位系统只能看到NAT节点,误差非常大
IPv6 单栈 终端独立地址,按地域分层分配 前缀自带层次信息,定位理论精度更高
双栈过渡期 两种流量并行混合接入 需兼顾双轨定位的一致性

二、底层逻辑变化:从“猜位置”到“读线索”

网络架构的改变,直接影响了IP定位的技术原理。

在IPv4时代,IP定位主要依靠“猜”。 由于大量用户隐藏在CGNAT之后,定位系统只能通过WHOIS注册信息、BGP路由通告和网络延迟测量,来推测这个IP大概在哪个区域。在共享出口下,一个IP可能关联着跨越几十公里的用户,定位误差通常在十几公里以上。

到了IPv6单栈环境,定位开始转向“读线索”。 IPv6地址在设计上就带有层次化结构,包含全球路由前缀、运营商前缀和区域前缀。运营商在分配IPv6地址段时,往往会遵循地域划分策略(比如将某个特定前缀分配给某个城市或区域)。只要IP数据库建立好了“前缀与地理位置”的映射关系,理论上就能直接读出终端所在的区域,精度天然高于IPv4。
20 (2).jpg

但这里有一个技术难点:IPv6地址空间极其庞大,且运营商的前缀分配策略会动态调整。如果IP库的IPv6数据覆盖率不足、更新滞后,风控系统拿到新的IPv6地址时,依然会面临“查无此地”的尴尬。

三、双栈过渡期的技术挑战与实操验证

在真正的单栈到来之前,技术团队面临的最直接问题是双栈定位的一致性。

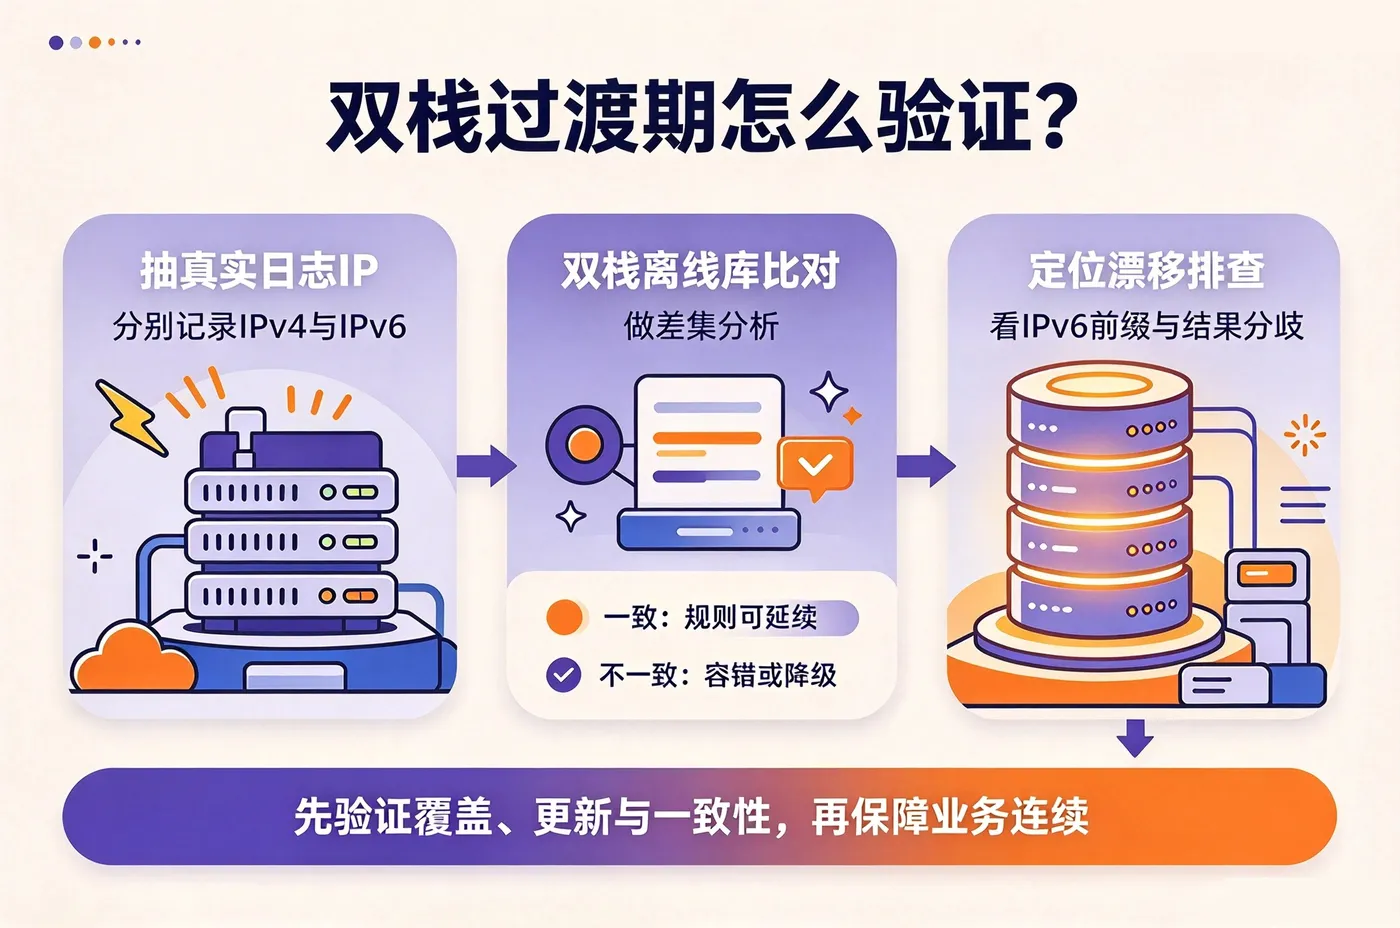
同一个用户在网络切换时,可能前一个请求走IPv4,后一个请求走IPv6。如果这两种协议解析出的地理位置差异过大(比如IPv4在深圳,IPv6在东莞),风控系统很容易将其误判为“异常位置漂移”。

如何排查这种一致性风险? 通常的做法是抽取真实业务日志中的IP,分别记录其IPv4和IPv6的查询结果。在实际比对时,可以使用IP数据云的离线库作为基准参照,将两种协议的定位结果做差集分析。这样可以直观地看到哪些IPv6前缀存在定位漂移,从而在风控规则中增加相应的容错机制,或者对IPv6地址的定位结果进行降级处理。
20 (3).jpg

四、总结

IPv6单栈和“去NAT”的推进,长期来看会让IP地址的身份属性更强、定位更精准。但在当前的双栈过渡期,核心挑战在于IPv6数据的覆盖广度、更新频率以及双栈定位的一致性。对于技术团队而言,了解这一演进趋势,并提前通过专业的双栈库做好精度验证和规则适配,才能在未来网络架构切换时,保障业务的连续性与风控的准确性。

目录
相关文章
|
27天前
Ubuntu22扩容磁盘到根目录
Ubuntu22扩容磁盘到根目录
205 1
|
27天前
|
人工智能 自然语言处理 测试技术
基于 JEV 的 UI 自动化改造实践:从页面探索到失败修复
最近讨论度很高的 AI 模型: JEV 。 它和常见的大模型不太一样。ChatGPT、Claude 这类模型更擅长对话、生成文本、写代码、解释问题;JEV 的定位更窄一些,主要用来做判断。调用接口后,它会根据输入内容返回结构化结果,程序可以直接读取这个结果,再决定下一步怎么执行。 这个特点很适合放在自动化流程里。 以 UI 自动化测试为例,传统脚本通常是提前写好步骤:点击哪个按钮、输入什么内容、断言哪个元素出现。只要页面结构稳定,这种方式没有问题。但在实际项目里,页面经常会出现一些不确定情况: 同一个业务入口在不同环境里文案不完全一致; 页面上有多个相似按钮,需要判断应该点哪一个; 执行失败后
112 1
|
27天前
|
安全
移动即时通信平台上的虚假招聘诈骗手法分析
本文剖析以虚假招聘为诱饵、引流至WhatsApp等私密即时通信平台实施的社会工程诈骗。聚焦“接触—转移—侵害”三阶段链条,揭示其利用移动端信任生态与求职者心理缺口的双重机制,强调“平台转移”是构建信任、规避监管的关键环节,并从用户识别、平台治理、行业协同三方面提出防御路径。(239字)
80 0
|
27天前
|
人工智能 算法 定位技术
Geo优化中,视频内容常踩的七个坑与规避方法
视频能否被生成式AI引用,关键不在画面质量,而在是否配备机器可读、可定位、可验证的文本层——包括精准字幕、结构化数据、章节时间戳及独立文字稿。文中梳理七大常见误区,直击“有内容却无引用”的核心症结。
119 0
|
27天前
|
数据采集 人工智能 自然语言处理
2026年评论私信聚合回复技术落地指南:核心能力拆解、选型避坑与成本核算
国内内容运营领域正从单平台单点运营阶段向跨平台矩阵化、全链路智能化运营阶段加速演进,评论私信作为用户与运营主体直接交互的核心触点,其管理效率与响应质量已经成为影响账号流量权重、线索转化效率、品牌用户口碑的关键变量。本文将从核心技术能力拆解、选型避坑逻辑、落地成本核算三个维度展开系统盘点,定位为面向运营从业者、企业技术负责人的实操型科普内容,以评论私信聚合回复的典型落地形态为示例,说明各项技术的实际表现形式与选型注意点。文中出现的各类平台与方案仅作技术逻辑举例,不代表任何推荐顺序。
|
27天前
|
人工智能 定位技术
西安的 GEO 优化公司怎么挑:把「本地化」拆成可验证的交付证据
GEO(生成式引擎优化)是让AI精准引用机构公开材料的技术方法。当问题含“西安”等地域词,需处理“地域+行业+场景”复合意图——关键看其是否具备本地材料识别、信源对接与现场交付能力。本文提供可落地的核验路径:查问句集四行结构、验办公地址、溯信源渠道、核案例三匹配等,助您识别真本地化服务。(239字)
|
27天前
|
存储 弹性计算 监控
商协会活动报名峰值,用阿里云函数计算 FC 做弹性扩容
商协会年会报名等场景流量呈脉冲式爆发,函数计算(FC)弹性扩缩容能力完美匹配:峰值自动扩容、闲时缩容至零,按调用计费,成本大幅降低;配合API网关限流鉴权、表格存储原子操作与幂等设计,兼顾高并发稳定性与会员体验。(239字)
|
27天前
|
自然语言处理 安全 Windows
UI Composition 在 Win32 窗口中绘制字体图标
本文介绍如何在Win32中通过DirectWrite动态加载嵌入式字体资源(RT_RCDATA),构建自定义字体集合与多语言文本格式映射,实现跨平台一致的文本渲染,无需分发字体文件。使用DraftDepot一键发布。
46 0
|
27天前
|
关系型数据库 数据库 PostgreSQL
Compose应用先于PostgreSQL就绪导致连接失败:healthcheck与service_healthy配置记录
本文详解Docker Compose冷启动时`connection refused`根因:`depends_on`仅保启动顺序,不等数据库就绪。通过为DB配置`healthcheck`+应用侧使用`condition: service_healthy`,实现真正依赖等待,避免手动重启“修复”。(239字)
|
1月前
|
Web App开发 人工智能 JavaScript
太猛了,一个月干到15W+,给大家推荐一个最近爆火的开源逆向工具:REA
REA(Reverse Engineer Anything)是近期爆火的开源AI逆向工具,4月发布,1个月内斩获15万+ Star。它让AI Agent无需源码即可分析二进制、APK、JS/Electron、HAR包等17类目标,自动反编译、生成可运行代码,并强制返回带证据与局限的结论。全本地执行,MIT协议,支持Hopper/Ghidra/IDA等引擎,一行命令即可上手。
1701 4
太猛了,一个月干到15W+,给大家推荐一个最近爆火的开源逆向工具:REA