
做数据项目久了,我越来越觉得,存储这件事最容易被讲复杂,也最容易被选错。 很多人第一次接触 DAS、NAS、SAN,会先去背定义:DAS 是直接连接存储,NAS 是网络附加存储,SAN 是存储区域网络。
这些定义当然没错,但真正做选型的时候,你面对的不是考试题,而是一堆很现实的问题:数据库到底放哪;数据库迁移以后,下游任务还能不能正常取数;未来容量翻倍以后,这套架构还能不能撑住。
所以我更习惯从使用者角度理解:DAS 是“这台服务器用自己的盘”,NAS 是“大家共享同一批文件”,SAN 是“把远端存储当成本地磁盘用”。 这句话先记住,后面基本就不会绕。
一、先别背概念,先看服务器到底“拿到什么”
我以前给别人解释 DAS、NAS、SAN,最不喜欢从英文缩写开始讲。因为背完以后,过两天还是会混。真正最好用的判断方式其实只有一个:服务器最终看到的到底是什么。
DAS 的服务器看到的是直接连接在自己身上的磁盘。 NAS 的服务器看到的是网络上的文件和目录。 SAN 的服务器看到的是网络上的块设备。
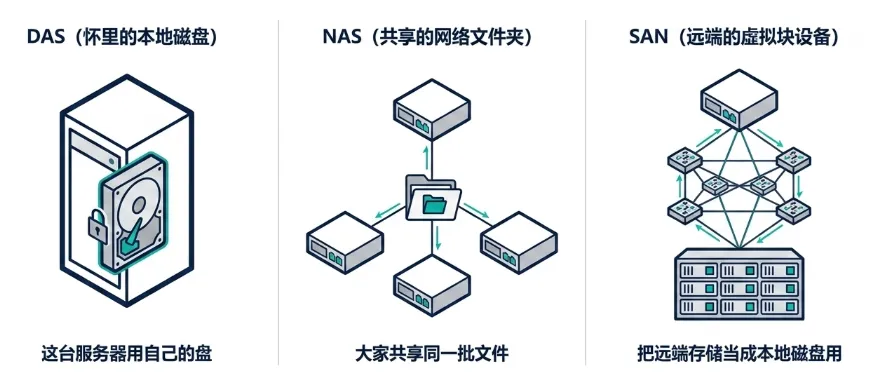
这三个区别看起来不大,实际上已经决定了绝大多数架构差异。比如一台 Oracle 数据库服务器。如果数据库文件放在这台机器自己的 NVMe 或 SAS 磁盘上,这是 DAS。如果服务器挂载一个 NFS 目录,把文件写到网络存储里,这是 NAS。如果存储阵列给服务器划了一块 LUN,操作系统把它识别成磁盘设备,这是 SAN。
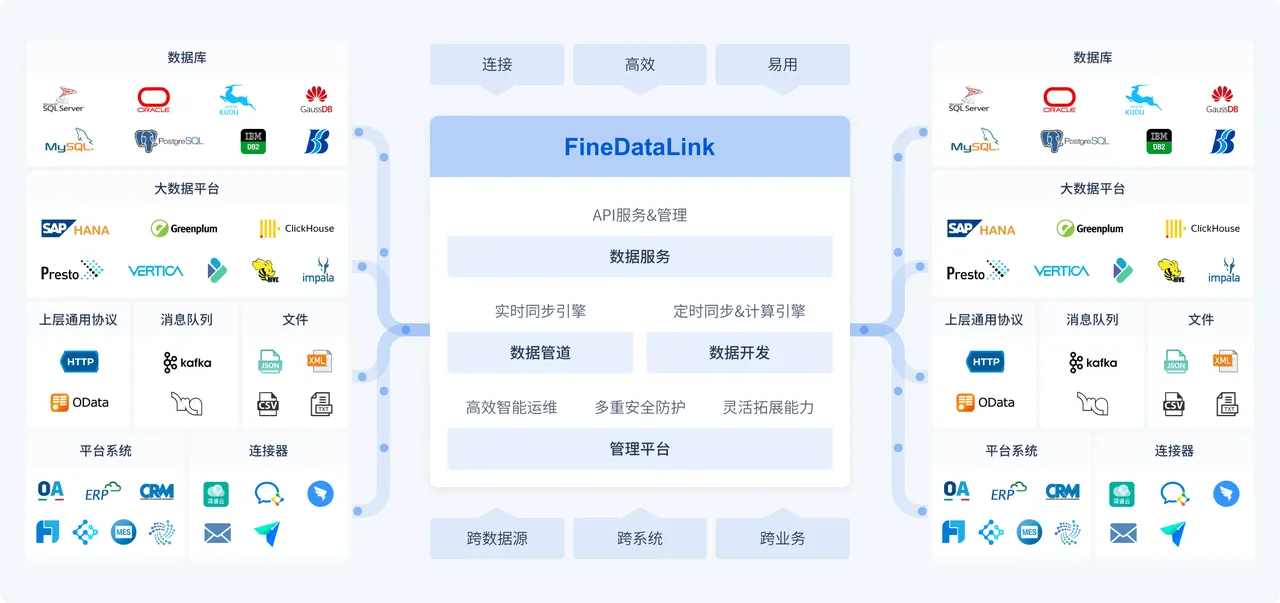
所以不要先问哪个更高级,要先问应用希望以什么方式访问数据。 我们实际做数据接入时,也不会要求企业先把所有底层存储统一掉。很多客户本来就是业务数据库用一套、数仓用一套、归档又是另一套,真正重要的是先把这些异构环境里的数据接起来,让上层分析和数据使用不再被底层物理存储方式牵着走。存储选型的第一原则,不是统一,而是匹配。
二、DAS:简单直接,但服务器和存储绑得很紧
DAS 是三种架构里最好理解的。服务器内部装硬盘,或者通过 SAS、PCIe、NVMe 等方式直接连接磁盘,本质上都属于 Direct Attached Storage。它最大的优点,就是直接。访问路径短,架构简单,部署成本也相对低。
所以一些单机数据库、小型业务系统、开发环境、边缘节点,用 DAS 完全没问题。而且现在 NVMe SSD 性能非常高,所以千万别把 DAS 理解成低端方案。真正的问题在另一边:DAS 的资源和服务器绑得太紧。
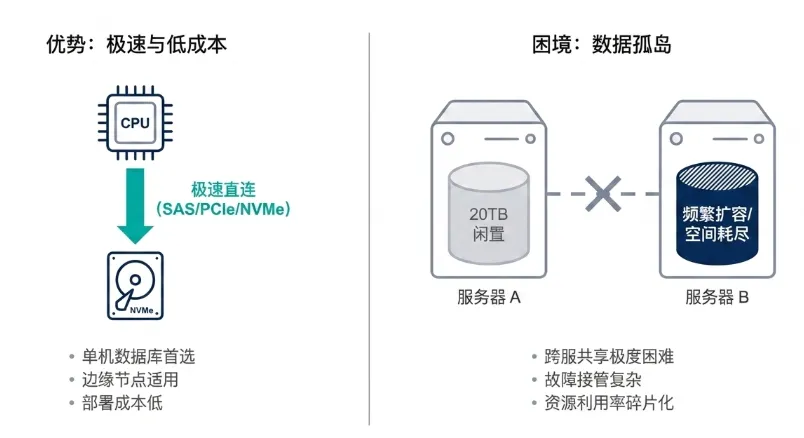
比如服务器 A 还有 20TB 空间。服务器 B 已经快满了。如果两边都是本地 DAS,这20TB并不能天然分给服务器 B 用。服务器一多,很容易出现: 有的机器磁盘大量闲置;有的机器已经频繁扩容;跨服务器共享麻烦;服务器故障以后数据接管更复杂。
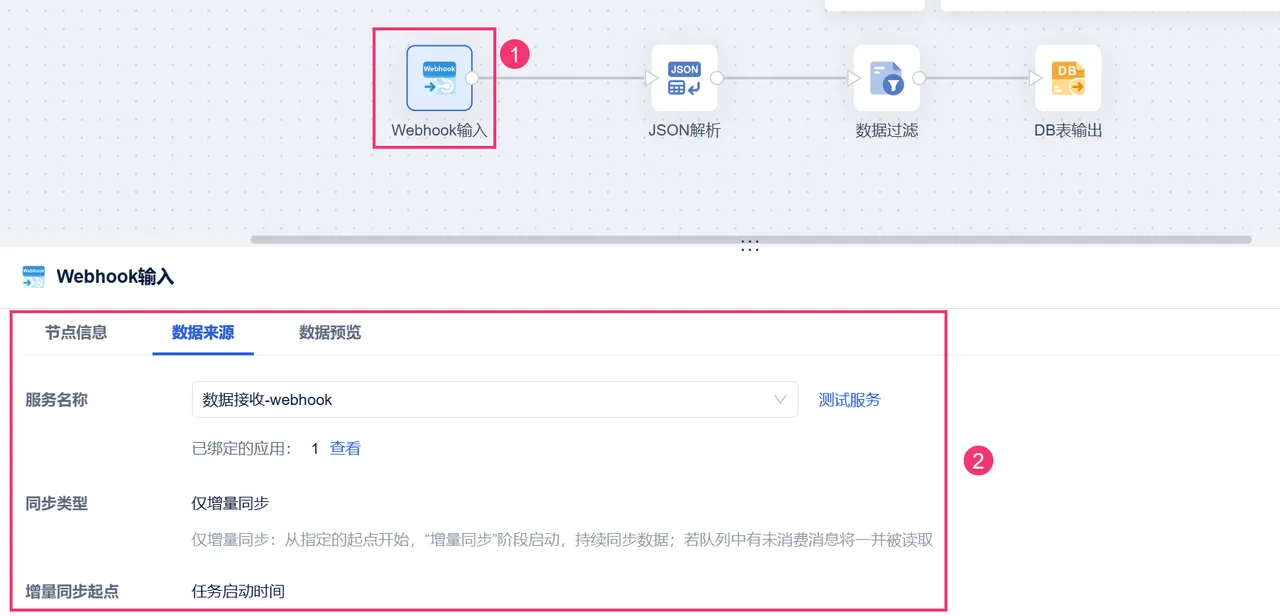
所以 DAS 很适合“自己用自己的盘”,但不擅长大规模资源共享。这种环境里,我们实际更关心的往往不是“怎么把所有 DAS 统一”,而是怎么把分散在各台服务器里的业务数据持续抽出来。比如某套数据库跑在本地 DAS 上,可以把真正需要分析的数据持续同步到统一数仓或分析数据库,这样底层服务器可以分散,上层数据使用不必跟着一起分散。DAS 可以分散,但企业的数据分析没必要跟着分散。
三、NAS:真正擅长的不是“当硬盘”,而是共享文件
NAS 最容易被理解成:“一个可以联网的大硬盘。”这个理解不算错,但不够准确。它真正提供的是文件级访问能力。服务器或者电脑通过网络访问 NAS,常见协议包括: NFS; SMB/CIFS。
客户端拿到的是文件和目录。所以 NAS 特别适合: 企业文档; 图片视频; 设计文件; 备份文件; 日志归档; AI训练数据。
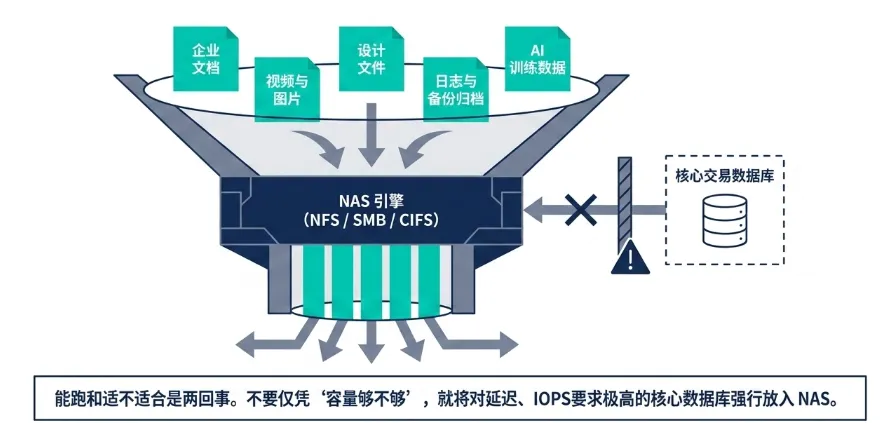
因为这些场景最核心的需求,不是给某一台服务器一块独占磁盘,而是很多人、很多服务器都需要访问同一批文件。 NAS 在这方面天然合适。但这里有一个常见误区。很多人觉得 NAS 也能存数据,那数据库是不是也随便往里面放?
技术上很多数据库当然能跑在 NAS 上。但能跑和适不适合,是两回事。 尤其核心交易数据库,要看延迟、IOPS、网络稳定性以及数据库本身对存储访问方式的要求,不能只看“容量够不够”。
在文件类数据越来越多以后,我反而会更关注这些文件怎么继续进入后续数据体系。与其让每套分析应用直接去读共享目录里的原始文件,不如先把真正需要使用的数据接入、整理,再进入后续数据库或数仓,让 NAS 继续负责它最擅长的文件共享,分析系统也不用长期绑在文件目录结构上。NAS 解决的是文件共享,不是企业全部数据管理。
四、SAN:为什么很多核心数据库喜欢它
SAN 是三者里最容易让人觉得复杂的。因为 NAS 已经能通过网络访问存储了,那为什么还要 SAN?区别就在两个字:块存储。
NAS 给你的是:“这是一个文件,你来访问。”SAN 更像是:“我给你一块磁盘,你自己管理。”虽然真正的磁盘可能在几十米外的存储阵列里,但操作系统看到的依然可以是一块块设备。SAN 常见实现包括: Fibre Channel(FC); iSCSI; FCoE。
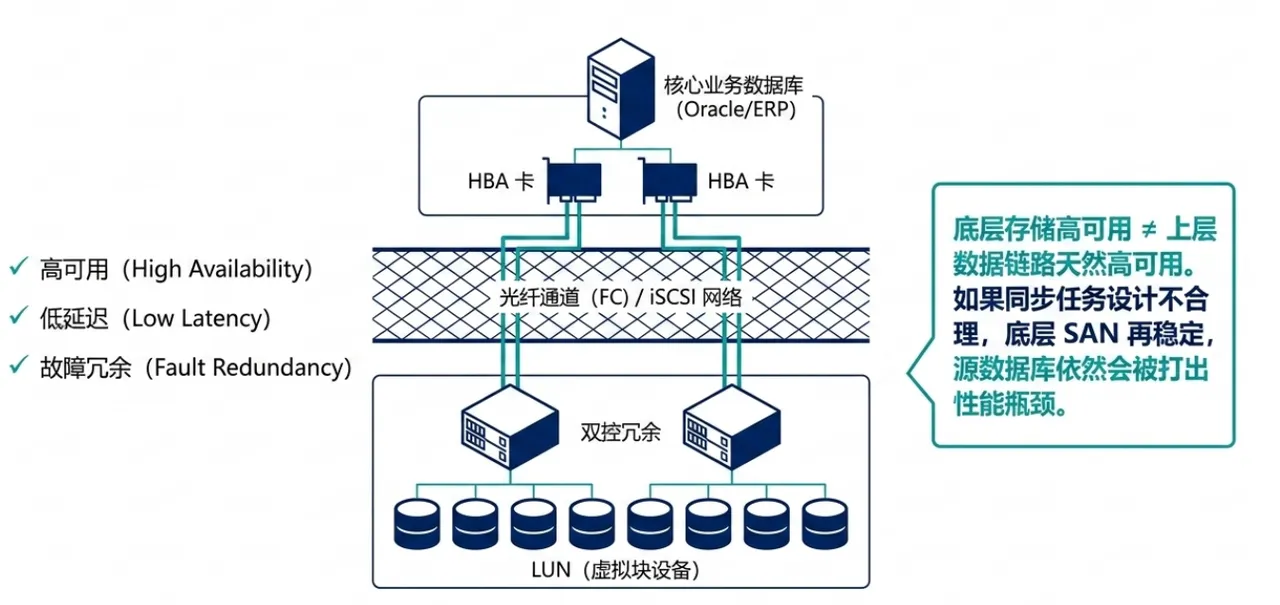
传统大型数据中心里,FC SAN 非常常见。它通常会涉及存储阵列、双控制器、HBA 卡、交换机、多路径等一整套架构。看起来复杂,但目标也很明确:高可用、低延迟、集中管理、故障冗余。
所以 Oracle、ERP、核心交易系统、虚拟化集群这类业务,经常会偏向 SAN。但站在使用者角度,还有一个特别容易忽略的点:底层存储高可用,不代表上层数据链路天然高可用。 所以 SAN 解决的是底层存储可靠性,数据同步则要解决上层链路稳定性。
五、真正影响体验的,往往不是容量,而是 IOPS、吞吐和延迟
存储选型里最常见的一句话是:“我们大概需要100TB。”然后就开始比价格。这个思路其实非常容易出问题。
因为容量只决定数据装不装得下,性能决定业务能不能正常跑。 100TB 的归档视频和100TB 的交易数据库,完全不是一回事。
真正做评估,至少要关注几个指标。IOPS,代表每秒能完成多少次 IO 操作。如果数据库大量随机小块读写,这个指标很关键。吞吐量,一般看 MB/s 或 GB/s。视频、大文件、备份这类连续读写,更看吞吐。延迟,就是一次 IO 从发出到完成需要多久。
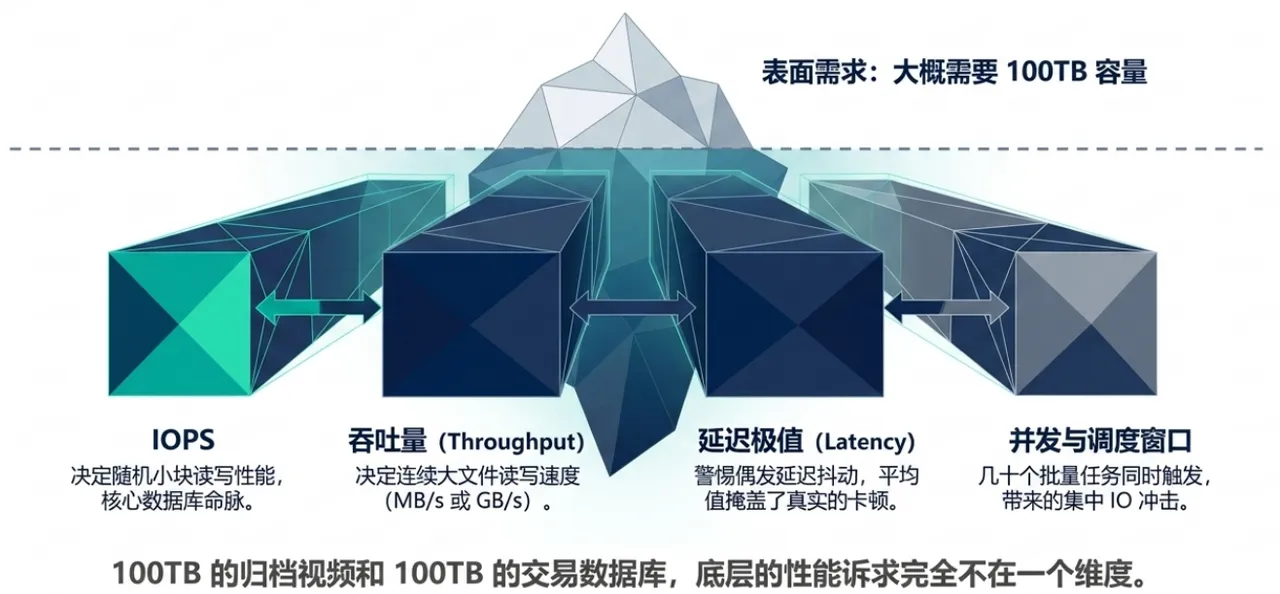
很多数据库业务最怕的其实不是平均性能差,而是延迟突然抖起来。除此之外,还要结合: 随机读写比例; 读写比例; 并发数量; 峰值持续时间。
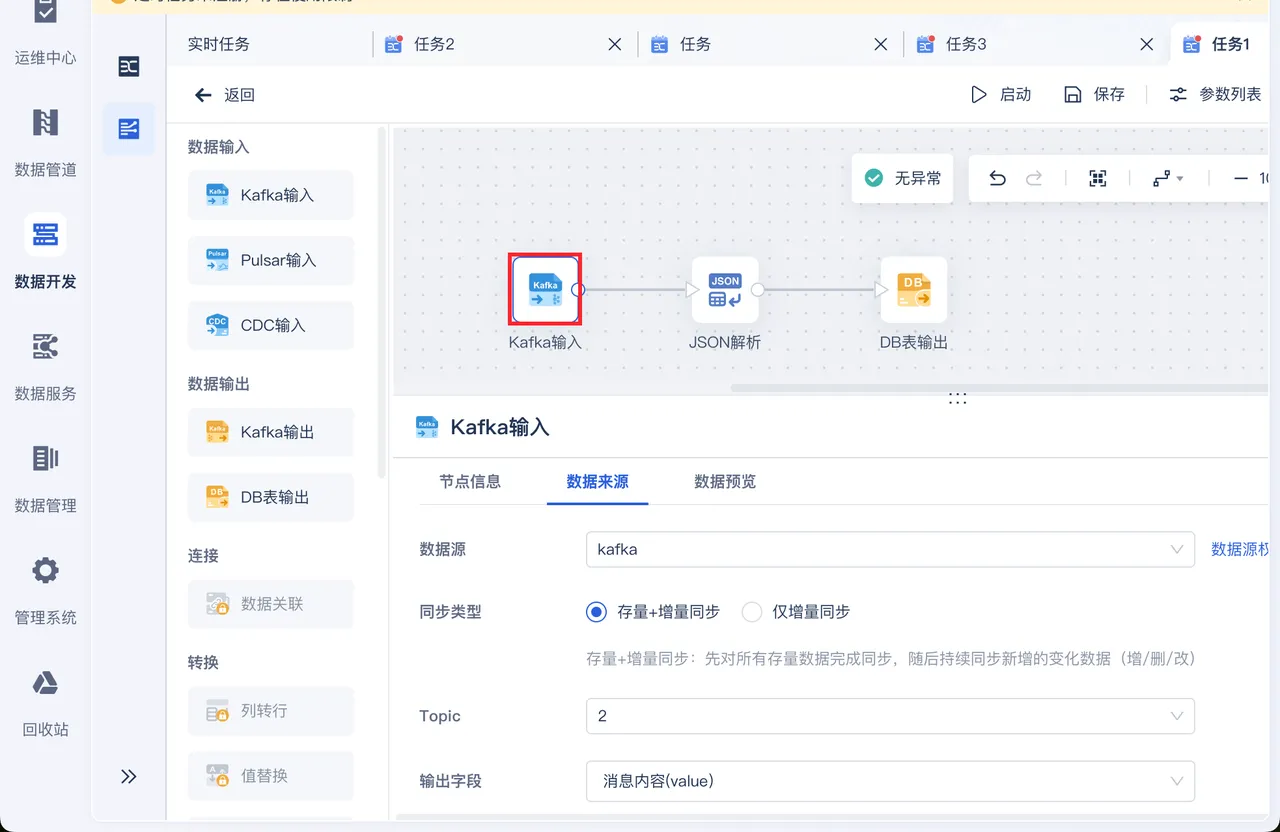
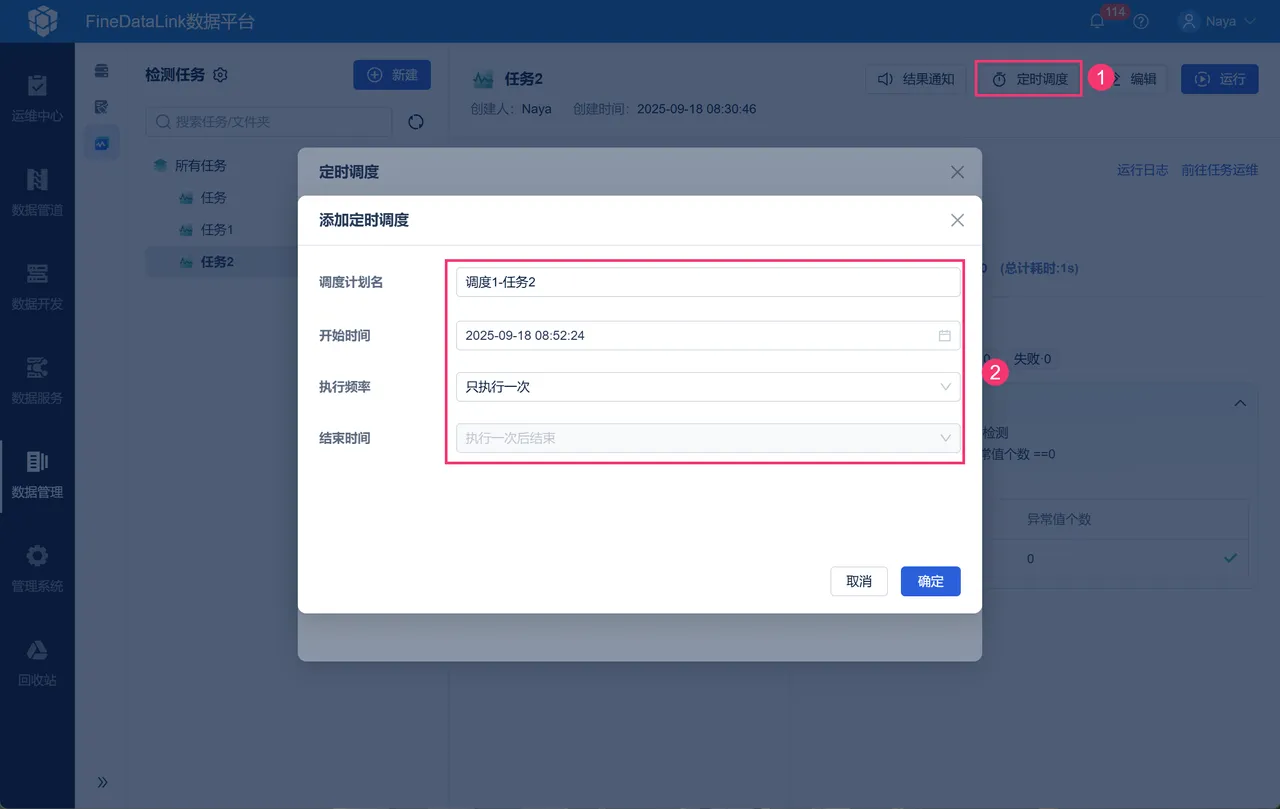
所以别拿“都是100TB”去直接比较两套方案。而且我在项目里还会多看一个很容易被忽略的东西:数据同步窗口。 很多所谓存储性能问题,并不是硬件真的不够,而是几十个批量任务同时跑,把 IO 峰值集中堆在一个时间点。有时候性能瓶颈不在盘,而在任务怎么跑。
六、DAS、NAS、SAN怎么选?先看业务,不要先看设备
如果真的让我做方案,我一般不会一上来问:“你准备买 NAS 还是 SAN?”我会先看业务怎么用。如果是单台服务器自己使用,共享要求不高,又追求简单和本地性能,DAS 往往最直接。
如果核心是多人或者多服务器共享大量文件,NAS 更自然。 如果是大型数据库、虚拟化、ERP 这类核心系统,对块存储、高可用、低延迟要求比较高,SAN 更合适。 但这只是第一层。
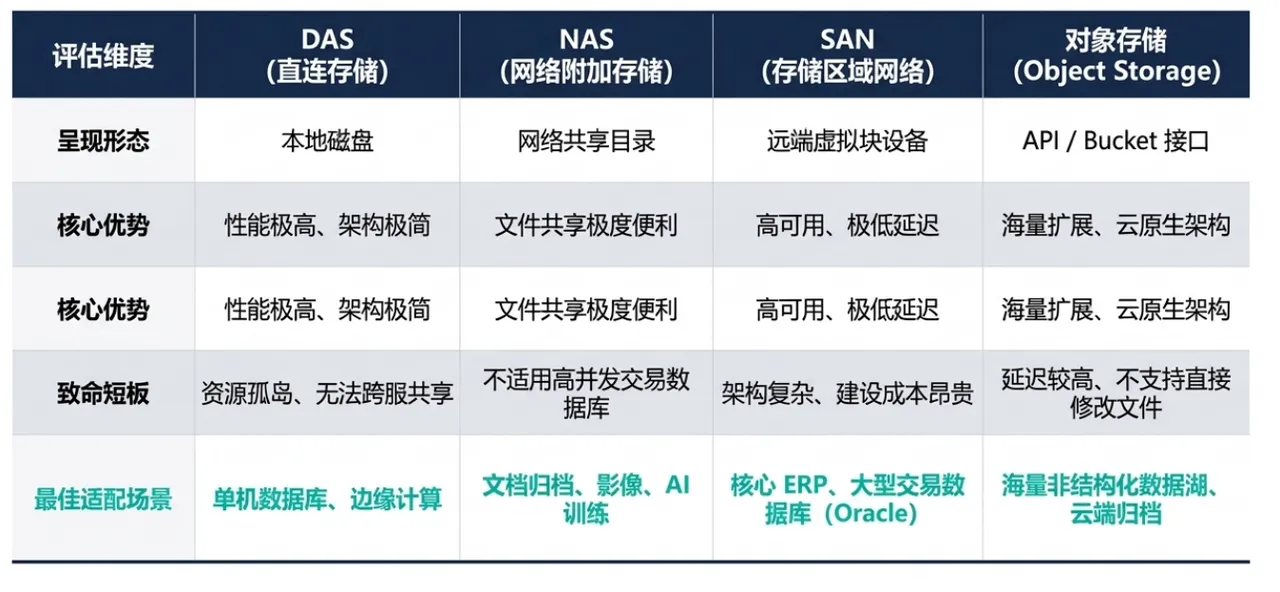
继续往下,还得看: 性能需求;数据规模和增长速度;可用性目标;容灾要求;运维能力;预算。真正合理的架构,很多时候并不是三选一,而是混合使用。
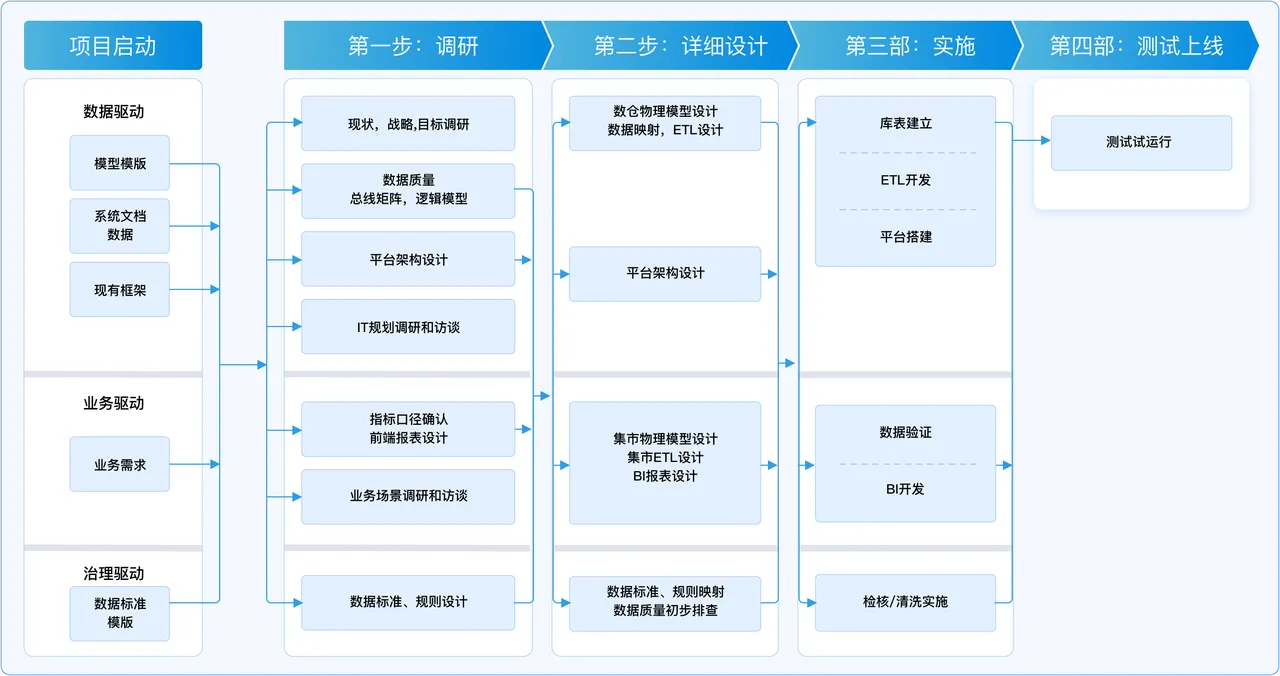
企业底层既有不同数据库,又有不同存储形态,本身并不可怕,真正麻烦的是上层每换一次基础设施,所有数据任务都要重新适配。所以更现实的思路往往是先把数据流转层稳定下来,再根据性能、成本和国产化改造需求逐步调整底层架构。为了架构漂亮而大拆大建,往往比异构本身更危险。
*
七、对象存储越来越多,DAS、NAS、SAN是不是要过时了
没有。只是今天企业数据类型更多了。除了 DAS、NAS、SAN,现在还有对象存储,比如 S3 类架构。对象存储特别适合海量非结构化数据、数据湖、备份归档、云原生应用。
但它并没有把传统三种存储全部替掉。因为它们解决的问题本来就不一样。所以一家稍微复杂点的企业,同时存在这些架构非常正常。甚至可能是:核心 ERP 数据库跑 SAN;部分业务系统用本地 SSD;影像和共享文件放 NAS;历史数据放对象存储。
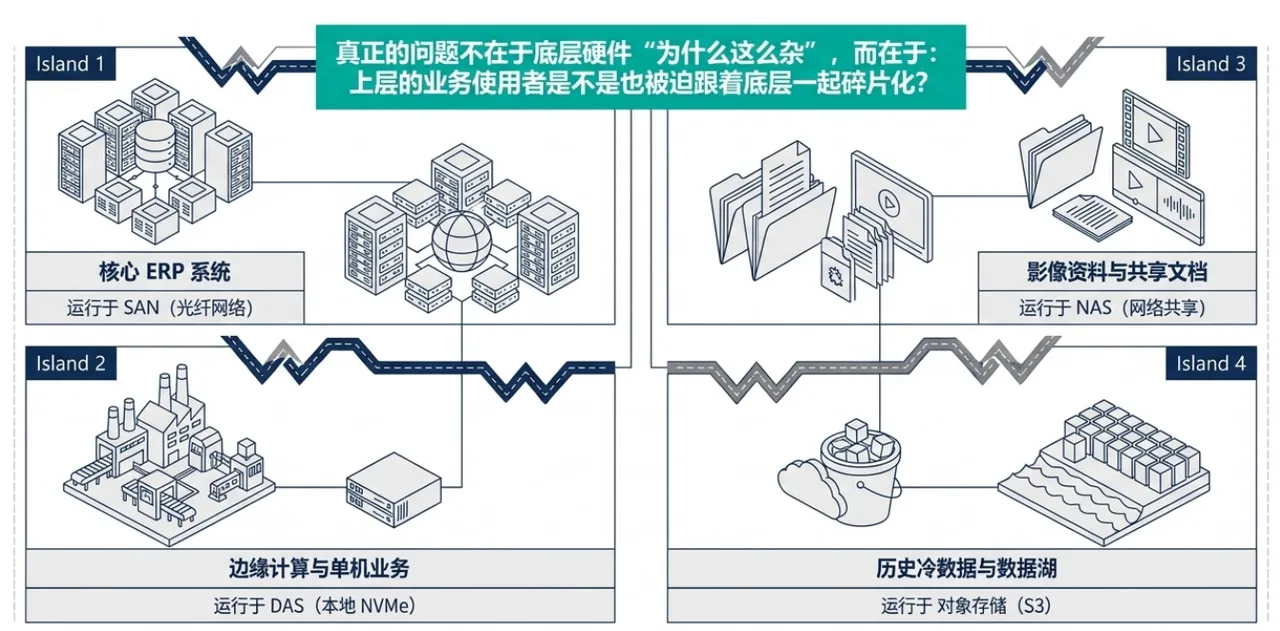
真正的问题不在于“为什么这么杂”,而在于:上层使用者是不是也被迫跟着底层一起碎片化。 基础设施可以异构,数据使用体验没必要永远异构。
八、真正做生产环境,别忘了备份、容灾和迁移
这是很多介绍 DAS、NAS、SAN 的文章最容易漏掉的一块。存储不是能读写就结束了。真正进入生产以后,很快就会遇到:磁盘坏了怎么办; 控制器挂了怎么办; 整个阵列挂了怎么办; 机房断电怎么办; 异地怎么接管。
这些问题决定的已经不是性能,而是业务连续性。 所以完整方案里,还要考虑: RAID和磁盘冗余; 快照; 备份; 复制; 双机或多路径; 异地容灾; RPO和RTO。
尤其数据库迁移时,更不能只考虑“历史数据怎么搬过去”。比如 Oracle 准备迁到达梦、OceanBase 或 GaussDB。
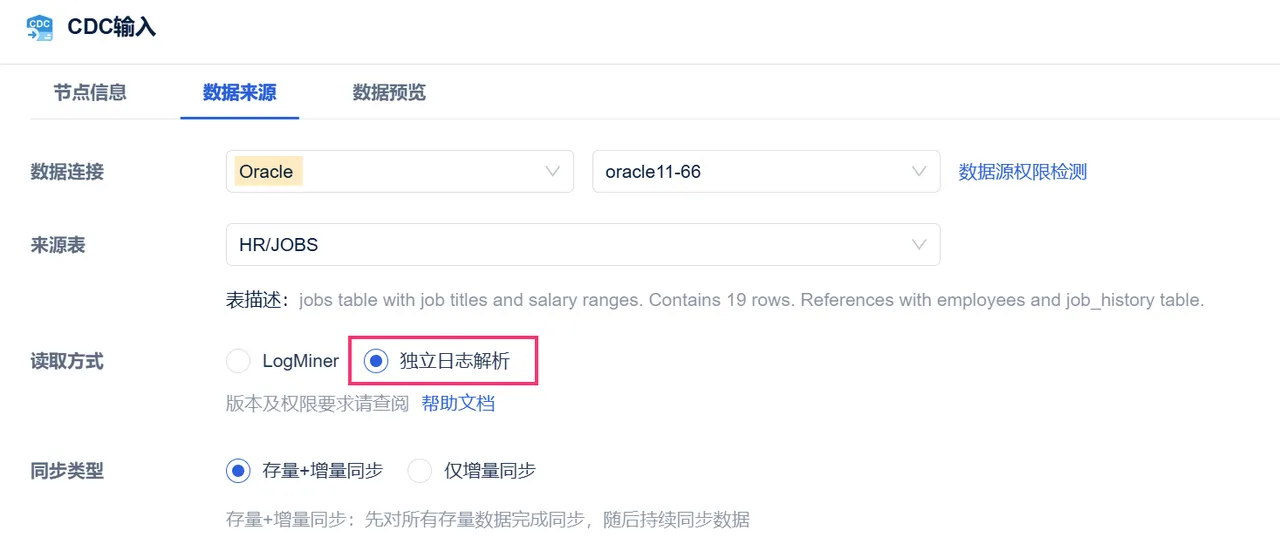
真正难的是:旧库在迁移过程中还在持续产生新数据。历史全量迁完以后,这些增量怎么办?什么时候停旧库?什么时候切新库?这时候存储只是迁移的一部分。
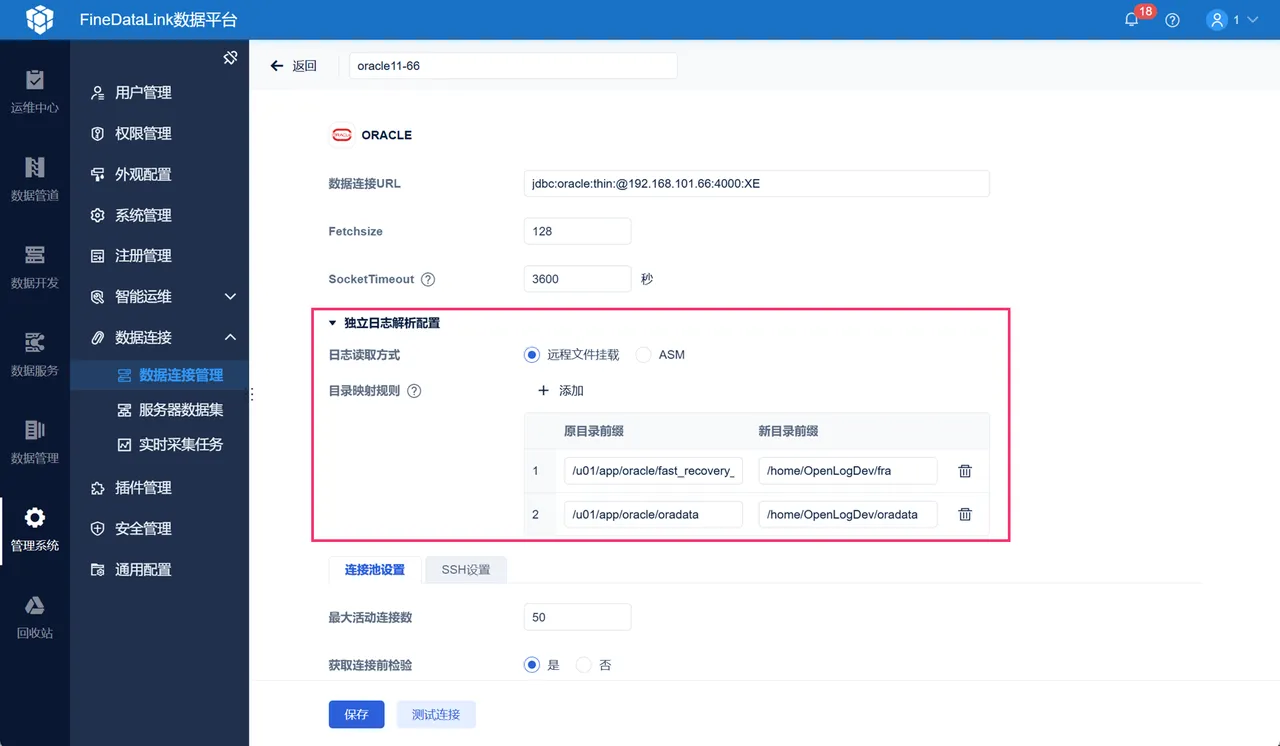
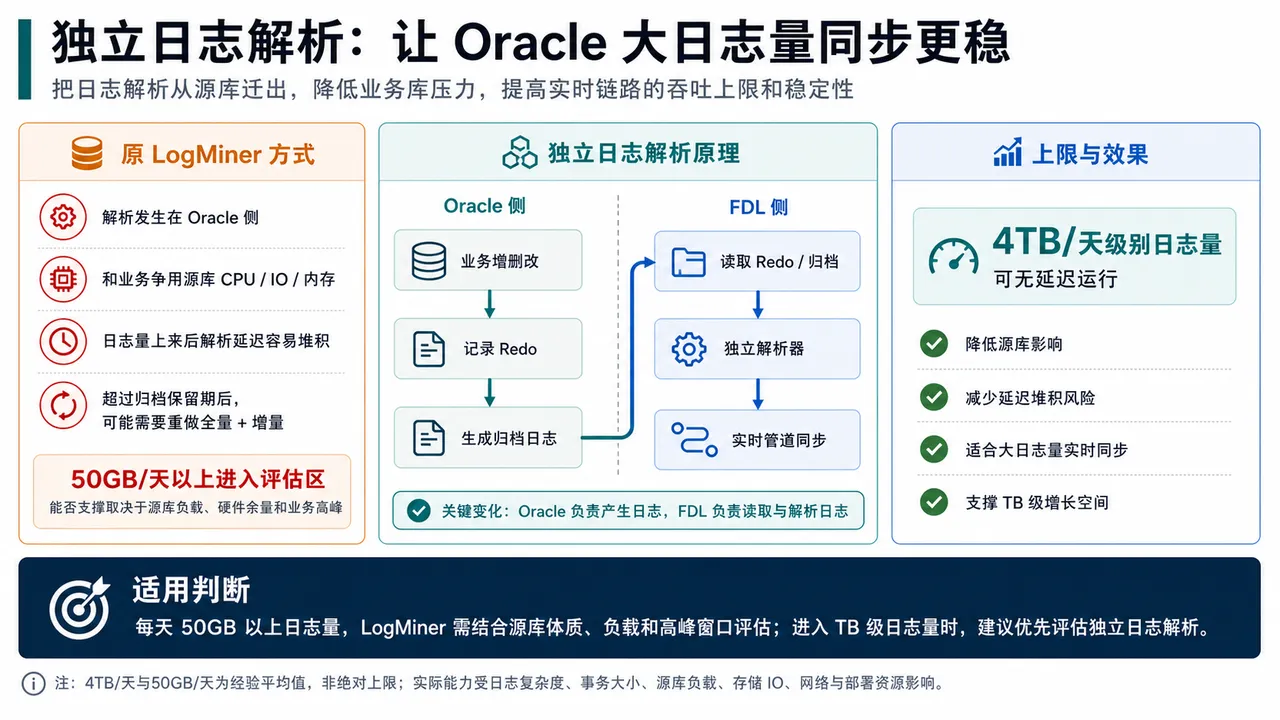
我们自己碰到这种项目,会更关注Oracle 独立日志解析能力以及对国产数据库实时同步的支持,因为真实生产环境里,真正棘手的不是把几十 TB 历史数据一次性搬完,而是全量迁移完成以后,旧库还在不断产生新的交易数据;只有把全量迁移和后续增量同步接起来,最后切换时才有可能把停机窗口压下来。企业迁移的不是一批静态文件,而是一条正在运行的数据链。
写在最后
DAS、NAS、SAN其实真的没那么玄。如果从使用者角度理解,会简单很多。 DAS:服务器直接用自己的盘。 NAS:大家通过网络共享文件。 SAN:服务器通过存储网络使用远端块设备。
再往后做选型,也别只问哪个更高级。真正要看的,是: 数据是什么类型; 谁在访问; 怎么访问; 性能要求多高; 业务能不能停; 未来怎么扩。
这些问题想清楚,架构基本不会偏得太离谱。而如果再站到数据平台建设角度,我会多加一个判断:数据放在哪里是一回事,数据能不能稳定地在系统之间流动,又是另一回事。
真正成熟的数据架构,从来不是买了一套最贵的存储,而是存储、数据库、数据集成和上层应用各自解决自己最擅长的问题,最后还能稳定地串在一起。


