中转站适不适合自己,先回答这五个实际问题

简介: 本文提供5个实操问题,助你判断中转站是否适配自身需求:明确任务目标、验证工具接入、厘清数据归属、定义“不降智”标准、规划后续使用。聚焦真实工作场景,拒绝泛泛而谈,帮你把模型能力真正落地到代码、资料或文本任务中。(239字)

中转站适不适合自己,先回答这五个实际问题

有人主要写代码,有人整理资料,也有人只是想把重复文字工作做快一点。面对同一页模型列表,他们需要确认的事情并不完全相同。与其先听一句“适合所有人”,不如先拿自己的任务回答几个具体问题。

下面这五问,既适合刚开始了解,也适合已经用过一阵、准备调整工作方式的人。

第一问:我准备让它完成哪件事?

不是笼统地说“提高效率”,而是具体到一段说明、一个小补丁或一份资料。写明最后要拿到什么,能帮助决定需要准备哪些材料,也能让使用以后更容易验收。没有明确结果时,聊天很顺利也可能没有形成实际交付。

第二问:我现在的工具能否正确接入?

如果正在了解 aibridgea点com,可以先从自己的客户端和使用方式开始核对。是否采用相应协议,模型标识怎样填写,需要哪些操作权限,都应以实际支持为准。不要只看到名字相同,就认为每个工具都能直接照搬配置。

用 Codex 做代码工作,还要确认文件范围与执行权限;做普通文本整理,则不必为此开放全部项目。把工具与任务匹配起来,能减少一开始就在无关功能上花时间。
统一入口历史页面截图,用于说明接入前需要核对的页面信息

第三问:我想看的数字,是否对应同一个任务?

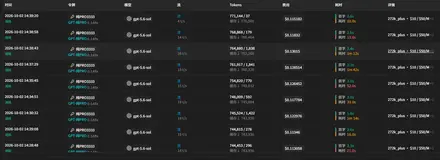
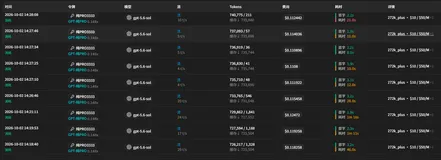
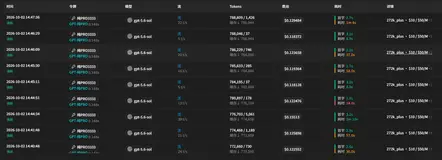
新图展示 gpt-6-astra、gpt-6.1-sol 以及 gpt-5.6-sol 标签下的调用记录。每行有不同数量、费用和等待时间。如果不知道请求内容,就先作为各自的页面样本阅读,不把金额最低的行直接解释成最适合自己的模型。
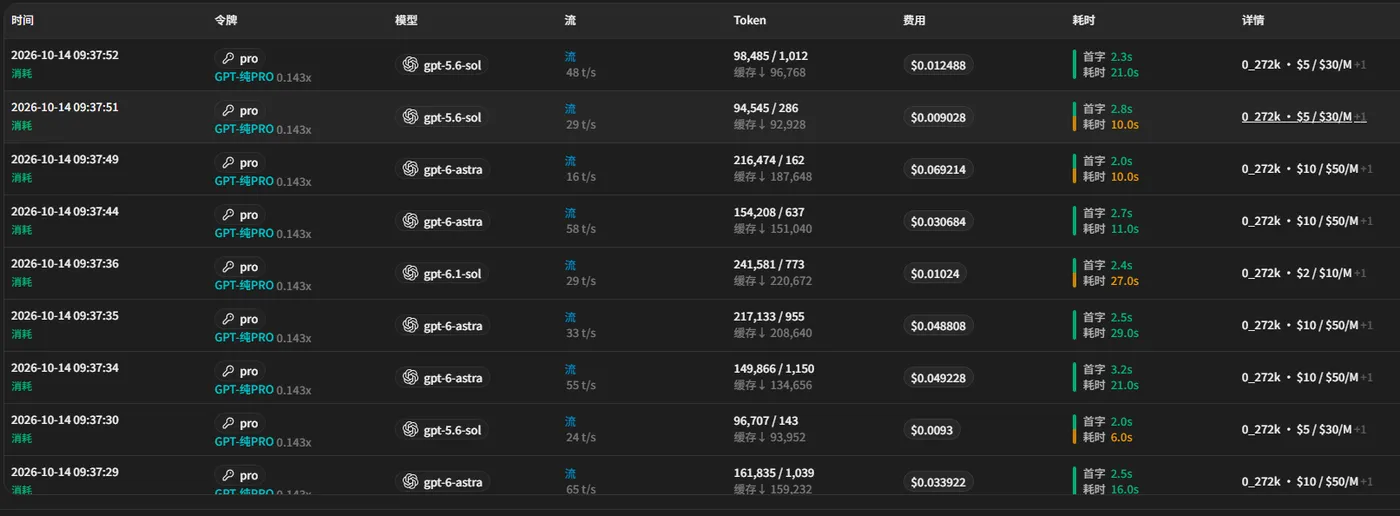
2026年10月14日调用记录,不同模型标签需按各行原样区分

自己试用时,记录任务与结果,比单独保存账单更有帮助。输出有没有漏条件,补丁有没有越界,资料引用有没有对应,分别留下简单备注。这些记录以后也能用来复查变化,而不是只凭印象讨论效果。

第四问:“不降智”对我而言,具体是什么意思?

对改稿,是事实和限定语没有丢;对代码,是理解需求、保留原有行为、准确报告验证;对资料,是出处和适用范围没有混淆。先选自己最不能接受的问题,再设计一项小任务观察,比用一道随意的谜题概括全部能力更贴近需求。

一次符合预期,可以支持继续尝试,不能变成长期绝对保证。同样,一次不理想也应该先查输入、配置和材料,不急着把所有问题都归给模型。

第五问:完成小任务以后,我怎样决定下一步?

可以继续用于同类工作,也可以调整输入后再试,还可以把它保留为辅助用途。决定不必只有“全面使用”和“完全放弃”两种。需要更多验证的任务就暂缓,已经形成稳定检查方式的任务可以逐步增加。

试用金额与范围按自己的计划控制,当前计费规则在使用前核对。不要因为一张截图很吸引人,就跳过工具匹配和结果检查;也不要为了把一次尝试写成成功故事,隐藏实际需要补充的工作。

这五问的目的,是把选择还原成自己的任务、材料和结果。入口有价值,最终应该体现在能帮助哪一件工作向前推进,而不是只在模型列表或宣传标签里找到答案。

目录
相关文章
|
6月前
|
人工智能 测试技术 API
多模型时代的API接入层怎么设计:从直连到147AI统一入口
多模型已成现实需求。单模型难覆盖长文档、代码、多模态等多样任务,系统正从直连转向统一接入层。147AI 提供 OpenAI 兼容的轻量级统一入口,屏蔽厂商差异,支持成本管控与平滑扩展,是国产团队落地多模型架构的务实起点。
|
11天前
|
JSON 自然语言处理 测试技术
模型回答通过,不代表业务结果通过
模型返回200≠业务达标!结构化任务需自动校验JSON字段与类型;代码须通过格式/静态/测试检查;长文档需抽查事实(数字、否定句等)。以调用记录为过程证据,自动校验为结果门槛,业务验收才是终极标准。(239字)
49 1
模型回答通过,不代表业务结果通过
|
15天前
|
人工智能 缓存 测试技术
我会怎样给一个 AI 接口做小规模压测
本文分享AI接口小规模压测的实操方法:分短/中/长三类输入,区分冷热缓存;固定模型、提示词、网络等变量;统计首字延迟、总耗时、Token、费用与失败率;最后用小流量验证迁移风险。重实践、可复现。(239字)
66 2
我会怎样给一个 AI 接口做小规模压测
|
15天前
|
缓存
长上下文调用便宜不便宜先看这两个Token
本文复盘长上下文调用成本误区:关键不在总输入Token(78.8万),而在未缓存输入(仅1665)。须拆解“总输入-缓存输入”,再结合三部分计价(未缓存/缓存/输出)分析费用。附实操检查五步法,助精准归因成本波动。(239字)
82 1
|
15天前
|
缓存
我会用冷缓存和热缓存做两次测试
本文分享个人缓存测试方法:通过冷/热缓存对照,量化分析长上下文场景中缓存对Token消耗、首字延迟及费用的影响。强调不盲信“缓存折扣”,需控制变量(模型、提示词、上下文等)并记录完整指标,确保结论可复现、可验证。(239字)
73 1
我会用冷缓存和热缓存做两次测试
|
15天前
|
缓存
同一个模型,为什么要保留多次调用记录
本文分享个人模型调用日志实践:同一配置下坚持多次记录,以捕捉输出长度、缓存状态、耗时波动与费用变化等动态差异;借助统计页快速定位异常趋势,避免将单次“好结果”误判为稳定表现,强调持续同条件验证对项目决策的重要性。(239字)
49 1
同一个模型,为什么要保留多次调用记录
|
15天前
|
缓存 API
看到价格页后我会做的三步核验
本文分享接入多模型API时的三步价格核验法:①统一比较前提(模型/提示词/上下文等);②拆解账单明细,定位费用变动根源;③结合业务场景权衡成本与体验(如首字延迟、缓存命中率、输出质量)。避免仅看倍率做决策。
94 1
看到价格页后我会做的三步核验
|
10天前
|
人工智能 缓存 数据库连接
遇到环境报错,先别让 AI 急着改业务代码
本文强调环境报错需先精准归因:区分“环境缺失”与“业务异常”,要求AI按执行命令→首错定位→配置核查→最小验证的逻辑链排查,拒绝盲目改代码,并珍视诚实声明“暂时无法验证”的专业判断。(239字)
52 0
遇到环境报错,先别让 AI 急着改业务代码
|
10天前
|
人工智能 数据处理
清洗一份 CSV,也能看出模型是否守住了规则
本文探讨如何用小规模CSV清洗任务评估AI模型的规则守界能力:强调保留前导零、不擅自填充空值、区分“空”与“零”、标记未知状态等硬性约束,并要求过程可复现、结果可验证,拒绝“聪明但失真”的输出。
36 0
|
12天前
从统计页判断“不降智”,只能得到一半答案
统计页可监测成功率、延迟、吞吐等链路指标,但无法直接验证回答质量或判断“是否降智”。需结合固定任务集与调用记录,分链路层(稳定性)和能力层(输出质量)双维度评估。本文为单日数据复盘,非长期测试结论。(239字)
37 0
从统计页判断“不降智”,只能得到一半答案

热门文章

最新文章