把品牌所有可被 AI 利用的信息看成数据资产,GEO优化 就是一道资产配置题。本文用资产台账的方式盘点 T1—T5 五级信源分布,说明为什么官网(引用率 33.32%、连续 4 个月上涨)应当作为优先投入项,给出四个行业的阵地配置建议与 PC / 移动端双轨部署原则,并附台账字段设计与跃迁优先级排序方法。
目录
一、资产视角:为什么 GEO优化 是配置题不是产量题
二、格局判断:最多元也最挑
三、台账:把内容资产映射到 T1—T5
四、官网:为什么它是第一优先项
五、行业阵地与双轨部署
六、结论与四个落地动作
七、GEO优化 方法论能力框架(信源模块 · 附台账结构)
DeepSeek 不靠自有生态、信源最多元也最挑,GEO优化 的胜负手已从"拼发稿量"转向"拼信源权重"。谁能站上 T1、T2 权威层级,谁才握住 GEO搜索信源优化 的主动权。
一、资产视角:为什么 GEO优化 是配置题不是产量题
同样做 GEO优化,为什么有的品牌在 DeepSeek 里被反复引用,有的连 Top5 都进不去?
先看一组权重:RAG 评分公式是语义相关性 40%、信源权威性 35%、用户价值 25%。权威性占三成半,而且它作用于的是"能不能拿到精读名额"这一层。
DataAsset GEO™ 的主张在这里很好用:品牌所有可被 AI 利用的信息——文本、Markdown、代码、PDF、新闻链接、官网、电商数据——都应被视为可长期存储、反复调用、持续增值的数据资产。资产的三个属性是:可盘点、可分级、可调仓。用这三个词去看 GEO优化,思路就从"多写几条"变成"把这些内容放到哪一级"。
二、格局判断:最多元也最挑
DeepSeek 是独立 AI 搜索产品,不依赖自有内容生态,靠外采和开放互联网检索搭建信源池,结构在全平台里最多元。回答链路是:用户提问 → 检索网页 → 大模型理解 → 整合生成 → 标注来源,其中内容权威性直接决定 AI 在精读阶段的最终引用名额。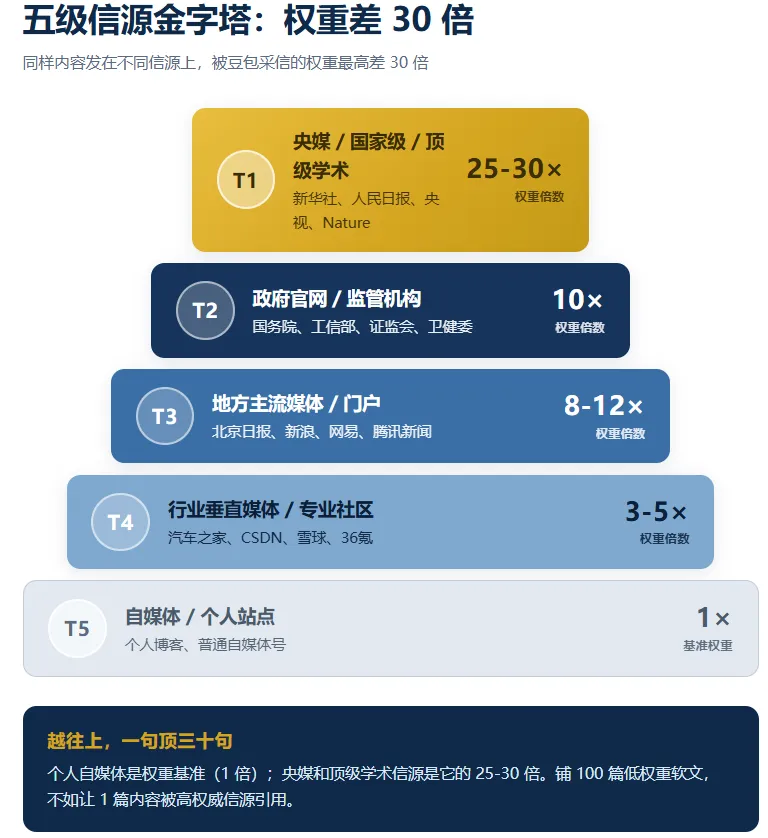
用资产语言翻译"最多元":这个池子不吃单一重仓,吃的是覆盖广度与单点质地的组合。
三、台账:把内容资产映射到 T1—T5
T1央媒 / 国家级 / 顶级学术(新华社、人民日报、央视、Nature)|25—30 倍
T2政府官网 / 监管机构(国务院、工信部、证监会、卫健委)|10 倍
T3地方主流媒体 / 门户(北京日报、新浪、网易、腾讯新闻)|8—12 倍
T4行业垂直媒体 / 专业社区(汽车之家、CSDN、雪球、36 氪)|3—5 倍
T5自媒体 / 个人站点(个人博客、普通自媒体号)|1 倍
台账字段建议这样设计,才能支撑"调仓"决策:
{
"asset_ledger": [
{
"asset_id": "A001",
"title": "行业数据白皮书 2026",
"host": "www.brand-official.com",
"current_tier": "T5",
"target_tier": "T3",
"weight_gain_estimate": "1x -> 8-12x",
"structure_ready": {"h1h2": true, "table": true, "qa": true, "metrics": 6},
"migration_action": "投稿/转载至地方主流媒体或门户科技频道"
},
{
"asset_id": "A002",
"title": "产品参数与检测报告库",
"host": "m.brand-official.com",
"current_tier": "T5",
"target_tier": "T2",
"weight_gain_estimate": "1x -> 10x",
"structure_ready": {"h1h2": true, "table": true, "qa": false, "metrics": 12},
"migration_action": "对接监管机构公示/标准引用"
}
],
"priority": ["A002", "A001"]
}
注意最后那个 priority 字段——台账的价值不在登记,在排序。按"跃迁后的权重增益 ÷ 投入成本"排,才知道先动哪一个。
四、官网:为什么它是第一优先项
报告的数是:官网引用率 33.32%,且连续 4 个月只涨不跌。
从资产角度看,官网有两个别的阵地没有的属性:其一它是唯一完全自控的资产,不受第三方规则变动影响;其二它是所有派生内容的母资产——白皮书、技术文档、产品数据、FAQ 都挂在这里,其他阵地的内容往往从这里派生。
配合"信源最分散"这个特征,官网还有一个额外价值:当 AI 刻意避免过度依赖单一信源时,一个被多家引用的官网更容易自然出现在多个来源链里。
五、行业阵地与双轨部署
汽车垂媒占引用 50%—80%,懂车帝独占 30%,必投"铁三角"——懂车帝 + 汽车之家 + 易车 / 太平洋汽车
金融财经社区 + 门户为主,雪球、叩富问财、新浪财经、东方财富权重突出
医疗 / 科技 / 法律 / 教育专业信源依赖度均超 70%:PubMed、CNKI、卫健委、arXiv、IEEE、政府官网、裁判文书网、各高校官网
旅游携程独占 64%,是旅游类问题第一信源
双轨部署:PC 端偏学术 / 深度(论文、报告、技术文档高频),App 端偏资讯 / 轻量(快速问答、综合资讯高频)。引用源网址里 m. 域名居多,说明移动端信源采集更活跃——m. 域名页面绝不能遗漏。
六、结论与四个落地动作
DeepSeek 不靠自有生态、信源最多元也最挑,GEO优化 的胜负手早已从"拼发稿量"转向"拼信源权重"。谁的内容站上 T1、T2 权威层级,谁才握住了 GEO搜索信源优化 的主动权。
四个动作:①做强官网第一信源,把官网做成数据资产;②抢占权威层级,推进 T1—T4;③结构化 + 数据化表达;④分行业分端布局,m. 域名同步优化。
DeepSeek 不靠自有生态、信源最多元也最挑,GEO优化 的胜负手已从"拼发稿量"转向"拼信源权重"。谁能站上 T1、T2 权威层级,谁才握住 GEO搜索信源优化 的主动权。
七、GEO优化 方法论能力框架(信源模块 · 附台账结构)
四项能力:①官网数据资产建设;②权威层级跃迁;③结构化与数据化表达;④分行业分端口布局。
七类信源体系可作覆盖清单:G 端、商业类、官方类、研究类、第三方类、自媒体类与社群笔记长尾——信源越分散的平台,越需要覆盖面而非单点压强。