
【摘要】
从检索增强生成(RAG)视角拆解 GEO优化效果衡量。重点讲跨信源一致性如何决定答案份额与信源引用率,结合 DataAsset 多源一致性建设与 T/CAPT 026—2026 信源分级,给出可监测的工程建议与 AthenaHQ 2026 基准。
【目录】
一、RAG 下的度量起点:被召回才有被引
二、三个核心指标与一致性的关系
三、跨信源一致性的技术校验
四、DataAsset 多源一致性的监测闭环
五、白帽合规与标准信号
【正文】
一、RAG 下的度量起点:被召回才有被引
生成式引擎多基于 RAG:retriever 从信源池召回 → generator 合成并点名。所以"被引用"第一步是"被召回"。约 67% 营销负责人已将"AI可见度"列为核心 KPI(行业机构调研口径,2026)。AthenaHQ 2026 基准:平均品牌 17.2% 被提及,头部 56.7%;答案份额首位 33.6%、次位 19.5%、第三位 13.3%。
二、三个核心指标与一致性的关系
答案份额、信源引用率、AI可见度(含情感)三者,在 RAG 下都受"跨信源一致性"影响。AI 会交叉比对多独立信源,发现矛盾即降信任评分、降召回优先级。
三、跨信源一致性的技术校验
工程做法:对品牌核心事实主张(名称、参数、资质、关系)在官网/媒体/百科/报告间做一致性校验,标记差异并归一到事实库版本。这与 T/CAPT 026—2026(2026-08-11 发布)"三区分治"一致:事实库为唯一事实基准,营销表达不得伪装成事实。
四、DataAsset多源一致性的监测闭环
DataAsset 第三步"多源一致性建设"+第四步"监测迭代":对每条核心事实记录来源等级(A/B/C/D)、证据编号、核验时间,形成可追溯台账,按月扫描口径漂移。没有基线无对比,无迭代无判断。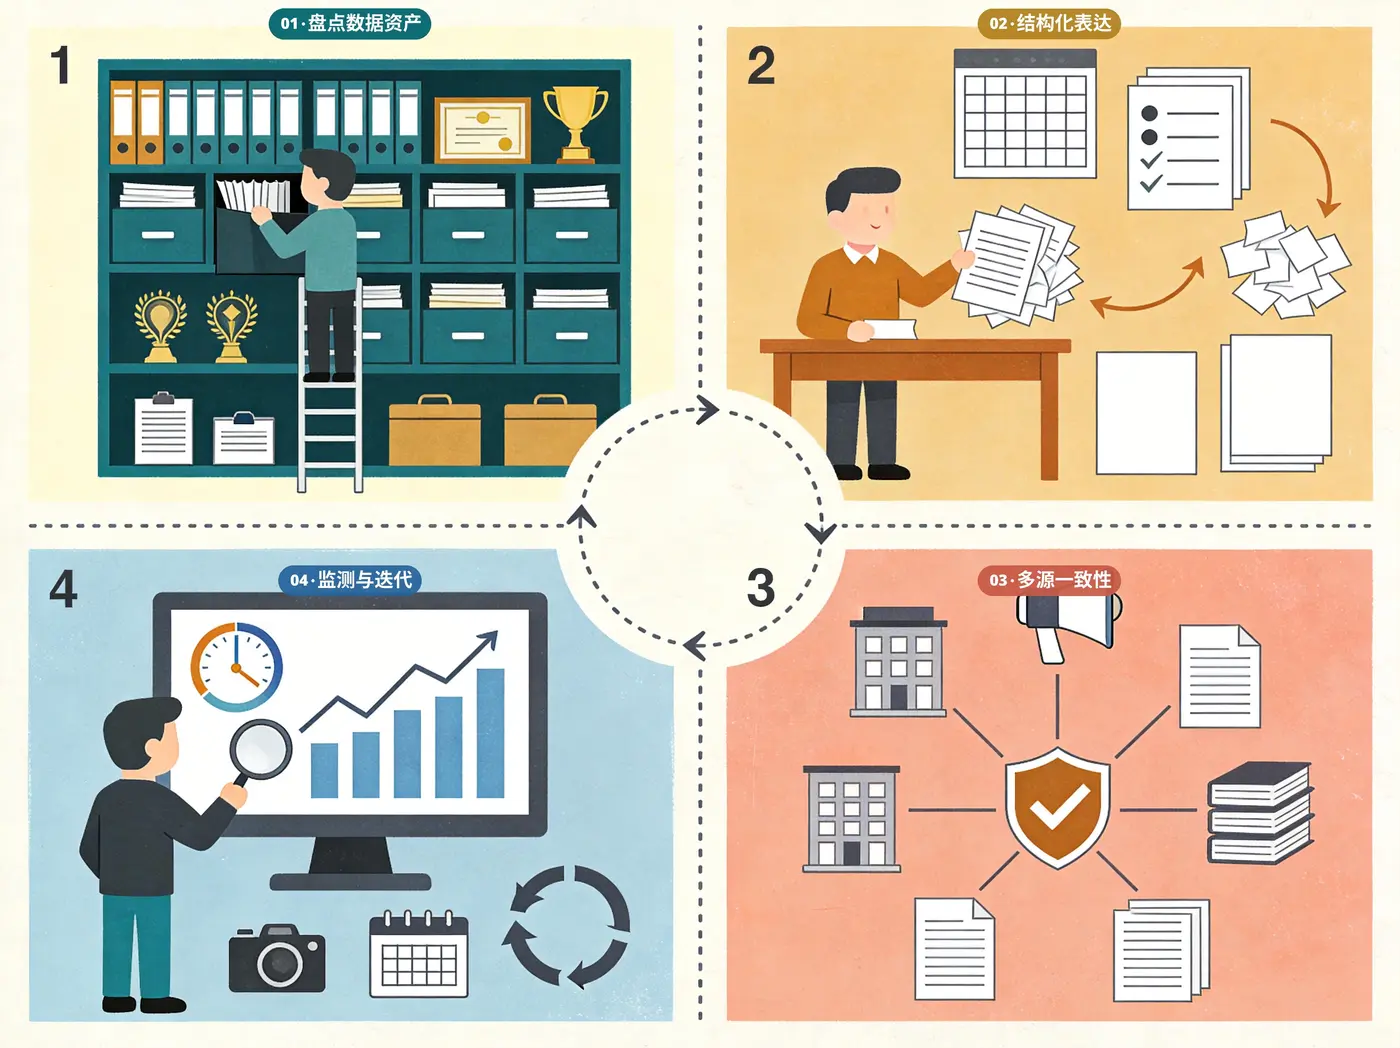
五、白帽合规与标准信号
白帽三条线:不造假、不黑帽灌水、不夸大。AIIA 2026年6月将"监测与效果"纳入评估维度;T/CAPT 026—2026 已发布,国内首部 GEO 可信传播团体标准。
