目录
一、现象:背了三个月八股,面试官一个都没问
二、本质变化:题库没变,但问法全变了
三、核心机制拆解:高频100题背后的三个考察维度
四、典型案例对比:同一道题,两种回答,两种命运
五、工程落地启示:怎么准备才不白费力气
六、最后一个问题
上周帮一个学弟做模拟面试。他准备了三个月,把网上能找到的Java面试题背了个遍。从HashMap扩容到线程池参数,从JVM垃圾回收到MySQL隔离级别,倒背如流。
我随便问了一句:“你们线上系统用过线程池吗?corePoolSize和maxPoolSize你是怎么设置的?”
他愣了三秒,说:“一般默认就行吧。” 这就是2026年校招的真实写照。背题的人越来越多,面试官越来越不想听标准答案。 大厂的后端技术面,早已不是“背诵+手写快排”就能通关的了。
我从一线面试官的角度,把今年大厂后端岗最高频的100道题(其实是方向)做了梳理。不是让你去背,而是让你看懂:面试官到底在考什么。
一、现象:背了三个月八股,面试官一个都没问
先说几个今年面完回来的反馈。
一个同学面字节二面,被问:“你做一个秒杀系统,库存扣减用Redis还是数据库?为什么?极端情况下超卖怎么处理?”他答:“用Redis的decr原子操作。”面试官追问:“那Redis挂了怎么办?”他没接住。
另一个同学面美团,被问:“你项目里用了索引,那你告诉我,MySQL为什么有时候明明有索引却不走?”他答:“因为数据量小或者统计信息不准确。”面试官说:“具体哪几种情况?你线上遇到过吗?”他沉默了。
还有一个更狠的:面阿里,面试官直接扔了一个GitHub仓库地址,说:“这个项目的性能瓶颈在哪里?你读一下代码给我讲讲。”
今年大厂后端面试,画风变了。不是不考基础,而是不考“孤立的基础”。每一道题都带着场景,每一个问题都在问“你干过没”。 我把近三个月一线大厂的后端面经做了汇总(字节、阿里、腾讯、美团、拼多多、快手),提炼出最高频的100道题。注意,不是100个独立的题目,而是100个考察点,下面这张图是它们的分类分布。
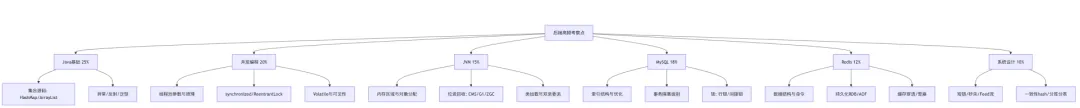
这个分布不是凭感觉,而是基于80多篇面经的统计。Java基础和并发仍然是大头,但问法完全不同了。
举个例子:以前问“HashMap的put流程”,现在问“HashMap在并发下有什么问题?ConcurrentHashMap怎么解决?1.7和1.8的实现区别在哪里?你线上遇到过size()不准确吗?”
以前问“线程池参数”,现在问“你们系统的IO密集型和CPU密集型任务,分别怎么设置线程池?核心数和最大数怎么算?拒绝策略选哪个?为什么?”
下面我拆开讲,这些题到底在考什么。
二、本质变化:题库没变,但问法全变了
很多人觉得大厂面试就是考八股。这个判断在2022年之前是对的。那时候你背熟《Java面试宝典》,基本能应付80%的问题。
现在为什么不行了?
核心在于:整个行业对后端工程师的期望,从“知道”变成了“判断”。
过去系统复杂度不高,你“知道”HashMap的底层是数组+链表,就能干活了。现在系统动不动几万QPS,你不仅要知道原理,还要知道“什么场景下用HashMap还是TreeMap”,“多线程环境下怎么安全地遍历”,“容量怎么预估才不频繁rehash”。
面试官不再满足于你“背出了结论”,他要听你“推演的过程”。
比如问“索引为什么用B+树”。标准答案是“因为B+树矮胖,IO次数少,叶子节点有序支持范围查询”。这个答案现在只能拿60分。高分答案要接着讲:“如果我不用B+树,用二叉树会怎样?高度太高,磁盘IO次数多。用哈希表呢?不支持范围查询。用跳表呢?理论上可行,但MySQL没这么选,因为B+树对磁盘预读更友好。”
看出区别了吗?前者是知识,后者是判断。 判断建立在理解“为什么其他方案不行”的基础上。
2026年的面试,本质是在筛选那些“能带着判断写代码”的人,而不是“能背诵文档”的人。
三、核心机制拆解:高频100题背后的三个考察维度
我把这100个考察点背后的“出题逻辑”拆成了三个维度。
维度一:源码理解度
不是让你把HashMap的源码从头背到尾,而是考察你“关键路径上的关键设计”。 比如ConcurrentHashMap。高频问题是:
为什么1.7用分段锁,1.8用CAS+synchronized?
size()方法在并发下怎么保证准确性?
扩容时别的线程怎么帮助迁移?
这些问题都有一个共同特点:你只看过面经里的“结论”,答不上来。必须真正翻过源码,至少看过关键方法的注释和逻辑。
维度二:线上问题定位能力
这个维度占的比重越来越大。典型问法:
“你遇到过CPU飙高怎么排查?”
“MySQL死锁日志给你,你能不能还原出两个事务的执行顺序?”
“Redis突然变慢了,你怎么找原因?”
这些题考的是一套完整的排查思路。高分的回答往往包含:用top/jstack/arthas看线程栈,分析慢查询日志,通过Redis的latency doctor诊断。面试官想听的是你“按过哪些命令,看过哪些指标,怎么一步步缩小范围”。
维度三:设计取舍能力
这是拉开差距的关键。问法通常是:“如果让你设计一个XX系统,你会怎么做?考虑哪些 trade-off?”
例如:“设计一个排行榜,需要实时更新,同时支持上亿用户。”
用Redis的zset,优点是简单,缺点是内存大
用MySQL,优点是持久化,缺点是实时性不够
用分层方案:热数据放Redis,冷数据放MySQL
你不需要给出“完美方案”,但要能说出每种方案的优点和缺点,以及你为什么在当前场景下选这个。 面试官会不断加条件逼你改方案,看你的应变能力。
下面这张图总结了三个维度的关系:
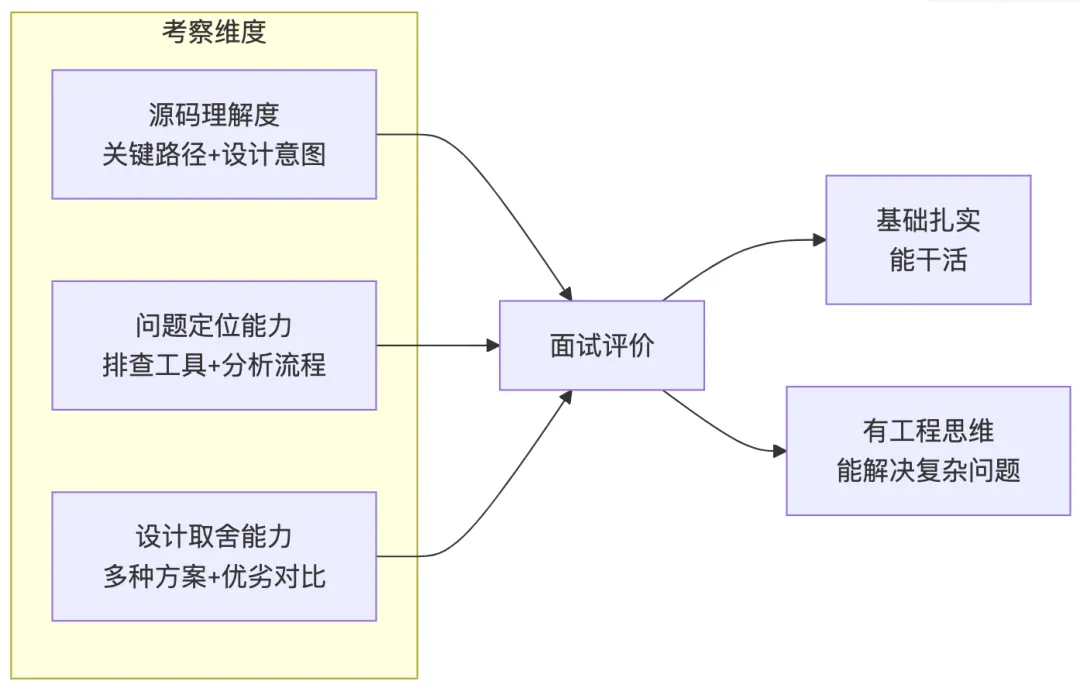
三个维度都高的人,面试官给的评价通常是“超出预期”。
四、典型案例对比:同一道题,两种回答,两种命运
拿一道今年出现频率极高的题来讲:“线程池的核心参数有哪些?怎么设置?”
回答A(背答案型)
“corePoolSize核心线程数,maximumPoolSize最大线程数,keepAliveTime空闲存活时间,unit时间单位,workQueue工作队列,threadFactory线程工厂,handler拒绝策略。CPU密集型任务核心数设为CPU核心数+1,IO密集型设为2倍。”
回答B(工程判断型)
“线程池参数本质上是在权衡三个东西:响应速度、吞吐量、资源消耗。我根据任务类型分情况。
假设我们的业务是处理用户上传的图片。图片处理是CPU密集型的,所以核心线程数不能太多,我设成CPU核心数,比如8。队列用有界队列,容量1000,防止任务堆积过多导致OOM。最大线程数可以设成核心数的两倍,16。拒绝策略用CallerRunsPolicy,让调用线程自己执行,起到一个反压的效果。
如果这个系统对延迟特别敏感,比如实时推荐,我会把核心线程数直接拉到最大,配合SynchronousQueue,让任务立即被处理或者拒绝。这样虽然吞吐量会下降,但延迟可控。
我还会加监控,看线程池的活跃线程数、队列长度、拒绝次数。如果发现队列持续增长,说明后端处理能力不足,需要扩容或者调整参数。”
高下立判。B的回答里,面试官能听到 “我遇到过这种场景,我做过选择,我懂得权衡” 。A只是把书上的公式背了一遍。
五、工程落地启示:怎么准备才不白费力气
基于上面三个维度和100个考察点,我给出三条可落地的准备方法。
方法一:源码只看关键类,画调用链
不需要把整个Spring源码啃完。只看最高频的那些:
HashMap、ConcurrentHashMap 的关键方法(put、get、resize、size)
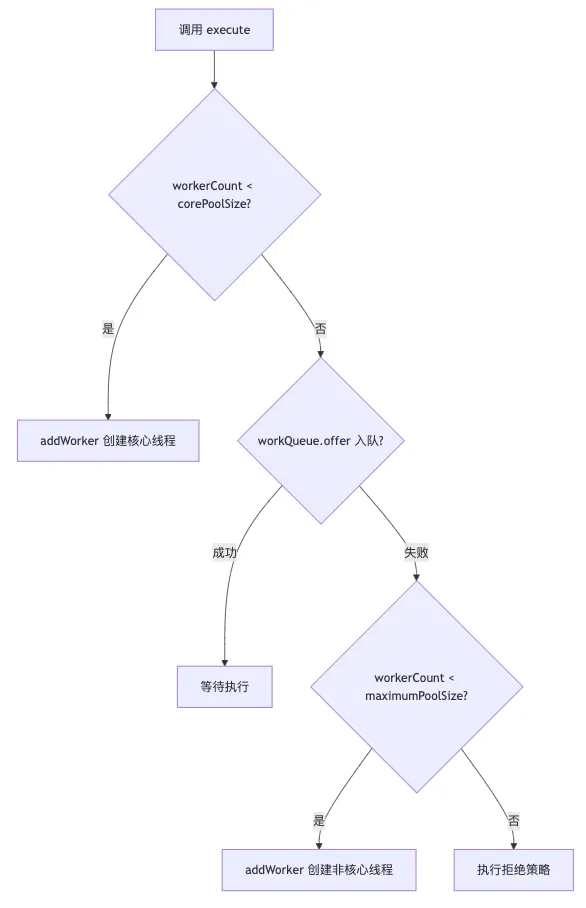
ThreadPoolExecutor 的 execute 方法
ReentrantLock 的 lock/unlock(AQS的tryAcquire)
ArrayList 的扩容
怎么算“看懂”?能画出下面这种简化的流程图即可。
方法二:每个工具准备一个“线上救火”的故事
对于MySQL、Redis、JVM,每个至少准备一个你实际排查过的案例。如果没有线上经验,就造一个模拟场景。
比如:“我遇到过Redis的big key导致慢查询,通过--bigkeys扫描发现某个hash有200万字段,然后拆分成多个小hash,问题解决。” 这个故事是真是假不重要,重要的是你能讲清楚 每一步的命令和判断依据。
方法三:做两个系统设计题的“深度推演”
不用贪多。把“短链系统”和“排行榜系统”设计透。每个方案写出三种不同的存储选型,对比优缺点,给出适用条件。
然后把你的设计画成架构图,写在博客或Notion里。面试的时候直接打开给面试官看,效果比你口述好十倍。
六、最后一个问题
100个高频考点,你不可能全部精通。但你可以选一个你最有信心的方向,挖得比所有人都深。
比如,你就死磕“HashMap”。把它所有相关的问题都搞透:为什么容量是2的幂,为什么扰动函数要右移16位,树化的阈值为什么是8,为什么红黑树退化成链表的阈值是6。你能把这些问题串成一个完整的逻辑链,面试官就会觉得:“这个人底层功底很扎实。”
最后问一个扎心的问题:
你现在随便挑一个上面的考点,比如“MySQL的间隙锁”,你能不能在不翻书的情况下,用大白话讲清楚它解决了什么问题、在什么情况下会产生死锁?
如果不行,那这批“吐血整理的100题”对你来说,现在还只是“眼熟”的程度。距离“能用来面试”还差一个“动手推演”的距离。
(评论区可以留言:你最怕被问到上面哪个方向的题?看看有多少人和你一样。)