1.1、Nacos服务注册流程
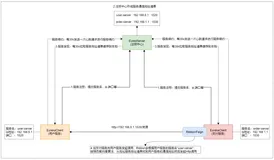
ITEM-SERVICE8083-LOCALHOST:8081服务调用者服务提供者ITEM-SERVICE8082负载均衡-LOCALHOST:8081LOCALHOST:8083-LOCALHOST:8083推送变更远程调用ITEM-SERVICE8081ITEM-SENVICE:LOCALHOST:8082注册中心服务订阅ITEM-SERVICE:LOCALHOST:8082注册服务心桃检测
流程如下:
●
服务启动时就会注册自己的服务信息(服务名、IP、端口)到注册中心
●
调用者可以从注册中心订阅想要的服务,获取服务对应的实例列表(1个服务可能多实例部署)
●
调用者自己对实例列表负载均衡,挑选一个实例
●
调用者向该实例发起远程调用
当服务提供者的实例宕机或者启动新实例时,调用者如何得知呢?
●
服务提供者会定期向注册中心发送请求,报告自己的健康状态(心跳请求)
●
当注册中心长时间收不到提供者的心跳时,会认为该实例宕机,将其从服务的实例列表中剔除
●
当服务有新实例启动时,会发送注册服务请求,其信息会被记录在注册中心的服务实例列表
●
当注册中心服务列表变更时,会主动通知微服务,更新本地服务列表
1.2、Nacos的分级存储模型是什么意思
NAMESPACE用于环境隔离.默认是空,默认是DEFAULT_GROUP命名空间SERVICE/DATALD用于配置管理时,就是配服务名/配置名用于服务注册发现时,就用于对服务或配置分组.表示公共环境PUBLICGROUP文件名.是服务名.分组
在 Nacos 中,分级存储模型指的是对配置数据进行按照环境、集群、命名空间等维度进行分级管理和存储的机制。这种分级存储模型可以帮助开发团队更好地管理和使用配置信息,提高配置管理的灵活性和可维护性。
在 Nacos 中,分级存储模型主要包括以下几个概念:
1
命名空间(Namespace)
命名空间是 Nacos 中用来隔离配置信息的最小单位,每个命名空间都有独立的配置信息存储空间。通过命名空间,可以实现不同环境(如开发、测试、生产)或不同业务线的配置信息隔离存储。
1
组(Group)
在命名空间内部,可以使用组来进一步划分配置信息。同一个命名空间内的不同组可以存储不同业务模块的配置信息,便于管理和维护。
1
配置集(DataId)
配置集是 Nacos 中存储配置信息的最小单元,它由命名空间、组和配置键(DataId)唯一确定一条配置信息。通过配置集,可以对每个具体的配置项进行管理。
1
分级存储
Nacos 支持在命名空间、组和配置集三个维度上进行配置信息的存储和管理。通过合理地组织命名空间、组和配置集的关系,可以实现灵活的配置信息管理,并且方便不同环境和不同业务需求下的配置隔离和管理。
通过 Nacos 的分级存储模型,开发团队可以更加灵活地管理和使用配置信息,支持多环境、多集群的配置管理,同时也为微服务架构下的配置管理提供了良好的支持。
1.3、Eureka服务注册流程
1
服务提供者注册
●
服务提供者启动时,会向 Eureka 服务器发送注册请求,包括自身的实例信息(如 IP 地址、端口、服务名称等)。
●
Eureka 服务器接收到注册请求后,将服务提供者的实例信息注册到服务注册表中。
1
服务续约
●
服务提供者会定时向 Eureka 服务器发送心跳续约请求,以确认自身仍然存活。
●
如果 Eureka 服务器在一定时间内没有收到服务提供者的续约请求,将会将该实例从服务注册表中剔除。
1
服务发现
●
服务消费者在需要调用服务提供者时,会向 Eureka 服务器发送服务发现请求,获取可用的服务实例列表。
●
Eureka 服务器会返回可用的服务实例信息给服务消费者,服务消费者根据负载均衡策略选择合适的实例进行调用。
1
服务下线
●
当服务提供者需要下线时,会向 Eureka 服务器发送取消注册请求。
●
Eureka 服务器收到取消注册请求后,将该服务实例从服务注册表中移除,不再向其他服务消费者返回该实例信息。
1.4、Nacos与Eureka的区别
Eureka和Nacos的相似点有:
●
都支持服务注册发现功能
●
都有基于心跳的健康监测功能
●
都支持集群,集群间数据同步默认是AP模式,即最全高可用性
Eureka和Nacos的区别有:
●
Eureka的心跳是30秒一次,Nacos则是5秒一次
●
Eureka如果90秒未收到心跳,则认为服务疑似故障,可能被剔除。Nacos中则是15秒超时,30秒剔除。
●
Eureka每隔60秒执行一次服务检测和清理任务;Nacos是每隔5秒执行一次。
●
Eureka只能等微服务自己每隔30秒更新一次服务列表;Nacos即有定时更新,也有在服务变更时的广播推送
●
Eureka仅有注册中心功能,而Nacos同时支持注册中心、配置管理
●
Eureka和Nacos都支持集群,而且默认都是AP模式
2、Openfegin相关
2.1、OpenFeign的服务调用流程
●
获取请求中的serviceId
●
根据serviceId负载均衡,找出一个可用的服务实例
●
利用服务实例的ip和port信息重构url
●
向真正的url发起请求
FEIGNBLOCKINGLOADBALANCERCLIENTROUNDROBINLOADBALANCEBLOCKINGLOADBALANCERCLIENTHTTP://ITEM-SERVICE/ITEMS/1拉取服务实例列表TTP:I/LOCALHOST:8081/ITEMS/10轮询负载均衡REACTIVELOADBALANCCTIVELOADBALANCER#CHOOS负载均衡,选出一个服务实例LOADBALANCERCLIENTCHOOSE0VICELNSTANCELISTSUPPLIER#GETETLNSTANCERESPONSELOCALHOST:8083LOCALHOST:8081获双SENVICELCLOCALHOST:8O81CALHOST:8081根据REQUEST重构URIITEM-SERVICE负载均衡ITEM-SERVICE发送请求NACOS开始结束获取SENVICE
2.2、常见的Ribbon/Spring LoadBalancer的负载均衡策略
自SpringCloud2020版本开始,已经弃用Ribbon,改用Spring自己开源的Spring Cloud LoadBalancer了。
Ribbon 负载均衡策略:
1
RoundRobinRule(轮询策略):按照顺序依次选择可用的服务实例,逐个进行调用。
2
RandomRule(随机策略):随机选择一个可用的服务实例进行调用。
3
WeightedResponseTimeRule(加权响应时间策略):根据服务实例的响应时间和权重来动态计算一个权重值,从而决定调用哪个服务实例。
4
RetryRule(重试策略):在一定的重试次数内,尝试多次调用不同的服务实例,直到找到一个可用的实例。
Spring Cloud LoadBalancer 负载均衡策略:
Spring Cloud LoadBalancer 是基于 Reactor 实现的负载均衡组件,它提供了以下常用的负载均衡策略:
1
RoundRobinLoadBalancer:轮询策略,按照顺序依次选择可用的服务实例进行调用。
2
RandomLoadBalancer:随机策略,随机选择一个可用的服务实例进行调用。
3
NacosLoadBalancer:根据服务的集群名和权重来动态计算选择服务实例。
3、限流相关
3.1、Hystrix和Sentinel有什么异同
Hystrix 和 Sentinel 都是流行的服务容错和限流组件,用于提高微服务架构的稳定性和可靠性。
相同点:
●
服务保护:Hystrix 和 Sentinel 都可以实现服务熔断、限流等功能,保护系统在面对异常情况下的稳定性。
●
监控:两者都提供了监控和统计功能,可以帮助开发人员实时了解服务的运行状况。
区别:
●
实现方式:Hystrix 主要基于线程池和信号量来实现服务隔离和容错。Sentinel 则基于"流量控制、熔断降级、系统负载保护"来实现服务保护和限流。
●
功能特点:Hystrix 主要提供服务熔断、线程隔离、超时控制等功能。
3.2、如何利用Sentinel配置限流
●
启动Sentinel控制台;
●
项目中引入Sentinel依赖;
●
先访问要限流的资源;
●
访问Sentinel控制台,设置按照qps或者线程数等限流规则
3.3、滑动窗口算法
在限流中,滑动窗口算法通常用于实现基于时间的限流策略,例如限制一定时间窗口内的请求数量。
滑动时间窗口算法中只包含1个固定跨度的窗口,但窗口是可移动动的,与时间区间无关。
具体规则如下:
●
窗口时间跨度Interval大小固定,例如1秒
●
时间区间跨度为Interval / n ,例如n=2,则时间区间跨度为500ms
●
窗口会随着当前请求所在时间currentTime移动,窗口范围从currentTime-Interval时刻之后的第一个时区开始,到currentTime所在时区结束。
50010001500200025003星
4、Gateway相关-路由断言、过滤器
4.1、网关作用
作用:路由与鉴权,以外有如下:
限流:实现微服务访问流量计算,基于流量计算分析进行限流,可以定义多种限流规则。
缓存:数据缓存。
日志:日志记录。
监控:记录请求响应数据,api耗时分析,性能监控。
鉴权:权限身份认证。
灰度:线上灰度部署,可以减小风险。
路由:路由是API网关很核心的模块功能,此模块实现根据请求,锁定目标微服务并将请求进行转发。
4.2、实现原理
1
初始化阶段:Spring Cloud Gateway 启动时会加载配置文件中定义的路由规则,创建对应的 RouteDefinition 对象。
2
路由匹配:当接收到一个请求时,Gateway 会依次匹配定义的路由规则,找到符合条件的路由。
3
过滤器链:针对匹配到的路由,依次执行该路由配置的过滤器链,对请求进行处理。
4
执行过滤器:每个过滤器可以修改请求和响应,记录日志,进行权限校验等操作。
5
转发请求:经过所有过滤器处理后,将请求转发给目标服务。
6
返回响应:将目标服务的响应返回给客户端。
4.3、路由断言类型
在 Spring Cloud Gateway 中,断言(Predicate)用于匹配传入的 HTTP 请求,并决定是否要将请求路由到特定的目标服务。断言可以根据请求的不同属性(如路径、请求头、请求参数等)来进行条件匹配,从而实现灵活的路由规则。常见类型有如下:
名称
说明
示例
After
是某个时间点后的请求
- After=2037-01-20T17:42:47.789-07:00[America/Denver]
Before
是某个时间点之前的请求 - Before=2031-04-13T15:14:47.433+08:00[Asia/Shanghai]
Between
是某两个时间点之前的请求 - Between=2037-01-20T17:42:47.789-07:00[America/Denver], 2037-01-21T17:42:47.789-07:00[America/Denver]
Cookie
请求必须包含某些cookie - Cookie=chocolate, ch.p
Header
请求必须包含某些header - Header=X-Request-Id, \d+
Host
请求必须是访问某个host(域名) - Host=.somehost.org
,.anotherhost.org
Method
请求方式必须是指定方式 - Method=GET,POST
Path
请求路径必须符合指定规则 - Path=/red/{segment},/blue/**
Query
请求参数必须包含指定参数 - Query=name, Jack或者- Query=name
RemoteAddr
请求者的ip必须是指定范围 - RemoteAddr=192.168.1.1/24
Weight
权重处理 - Weight=group1, 2
XForwarded Remote Addr
基于请求的来源IP做判断 - XForwardedRemoteAddr=192.168.1.1/24
4.4、过滤器实现方式
在 Spring Cloud Gateway 中,过滤器(Filter)用于对传入的 HTTP 请求或传出的 HTTP 响应进行处理,可以实现日志记录、请求转发、权限校验、请求修改等功能。Spring Cloud Gateway内置了许多常用的过滤器,同时也支持自定义过滤器来满足特定的业务需求。以下是一些常用的内置过滤器及其功能:
1
AddRequestHeader:向请求头中添加指定的键值对。
2
AddRequestParameter:向请求参数中添加指定的键值对。
3
RewritePath:重写请求路径。
4
StripPrefix:去除请求路径中的n段前缀。
5
SetStatus:设置响应的状态码。
6
AddResponseHeader:向响应头中添加指定的键值对。