
在 Doris Summit 2026 上,蔡聪辉(京东零售 OLAP 引擎 Tech Lead、Apache Doris PMC Member)分享了 Apache Doris 湖仓查询底座的优化实践,本文整理自该演讲。
随着业务分析需求持续增长,以及 AI Agent 带来新的查询负载,京东原有多引擎并行的湖仓分析架构面临查询场景复杂、资源调度难度提升与统一治理等挑战。
为构建更加统一、高效的湖仓分析底座,京东逐步将 Presto、StarRocks 等分析引擎承载的业务向 Apache Doris 收敛,并依托 Doris 的 Multi-Catalog、Nereids 优化器和向量化执行引擎,围绕查询调度、分区裁剪、文件扫描及执行资源管理开展全链路优化。
目前,京东基于 Apache Doris 构建的统一湖仓分析引擎已支撑日均百万级查询与 PB 级数据扫描,Agent 智能体查询占比约 20%,承载 BI 报表、数据质量任务与 AI Agent 等多种分析负载。
本文将结合京东的实际生产场景,深入解析其统一湖仓架构演进,以及面向大规模湖仓查询的核心技术优化实践,为大型企业建设高性能、可扩展的湖仓分析平台提供参考。
一、从多引擎并行到统一湖仓:京东分析架构的演进与挑战
京东的湖仓查询架构经历了多个阶段。京东在 Doris 开源初期就引入了 Apache Doris 作为 OLAP 引擎支撑广告报表系统,而湖仓查询引擎主要以 Presto 为主;后续又引入了 Starrocks 等其他分析引擎;在 2024 至 2025 年期间,团队决定对 OLAP 引擎进行全面收敛,将 Presto 与 StarRocks 逐步迁移至 Apache Doris;2026 年,京东持续推进以 Apache Doris 为核心的统一分析引擎架构建设,希望通过统一的分析底座,减少多引擎并行带来的架构复杂性,并建立能够长期承载多样化分析需求的技术体系。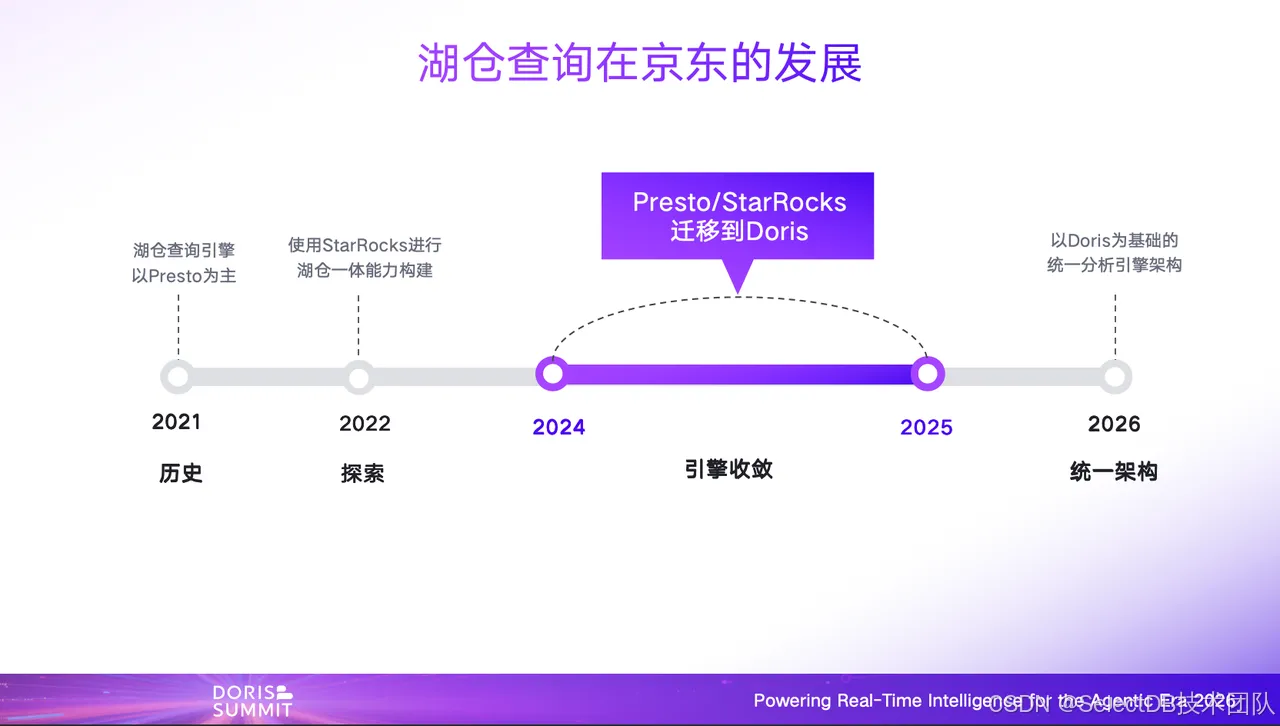
从业务使用规律来看,京东湖仓查询场景呈现出非常鲜明的“双峰潮汐”特征——上午时段主要面向业务看数与 BI 报表查询,凌晨时段则集中执行海量数据质量任务,SQL 复杂多样。
与此同时,Agent 智能体查询占比持续攀升到 20%,这意味着,原本具有明显时段特征的湖仓负载,正在向 7×24 小时持续运行的复杂混合负载演进。
面对不同查询场景对低延迟、高吞吐和资源隔离的差异化需求,京东需要一套既能高效访问数据湖,又具备较强查询优化和执行能力的统一分析引擎。
二、统一架构:以 Apache Doris 构建湖仓查询底座
01 为什么是 Apache Doris
在统一湖仓引擎的技术选型中,Apache Doris 的三项核心能力成为重要基础。
首先,是面向数据湖的 Multi-Catalog 能力。
Apache Doris 能够通过统一的查询引擎访问 Hive、Iceberg、Hudi、Paimon 等多种外部数据源,使京东能够在保留现有湖仓存储体系的基础上推进计算引擎统一,降低数据迁移与架构改造成本。
其次,是基于 RBO、CBO、HBO 的查询优化能力。
在大规模数据湖场景下,SQL 的执行效率不仅取决于扫描速度,也高度依赖分区裁剪、统计信息利用、Join 规划以及扫描任务生成等环节。Doris 的 Nereids 优化器为复杂查询规划提供了基础,也为京东进一步开展面向自身业务场景的深度优化提供了扩展空间。
最后,是向量化执行与分布式计算能力。
Apache Doris 的 BE 执行引擎能够支持高效的数据扫描、过滤、聚合和分布式计算。结合面向不同数据格式的读取能力,为京东承载 BI、数据质量和 Agent 等混合负载提供了重要支撑。
02 统一湖仓分析架构设计
基于这些能力,京东选择 Apache Doris 作为统一湖仓分析架构的核心引擎,从整体架构来看,系统主要包括业务访问层、统一查询入口、Doris 计算引擎以及底层湖仓存储四个部分。
业务访问层面向 BI 报表、业务看数、数据质量任务和 AI Agent 等不同分析场景,承载高并发交互式查询与大规模批量扫描任务。
统一查询入口负责 SQL 方言兼容、身份认证和权限治理。针对历史业务中使用的 Presto SQL、Spark SQL 等方言,系统通过兼容转换机制降低迁移成本,并将查询交由 Doris 统一规划和执行。
Apache Doris 计算引擎负责 SQL 优化、元数据访问、扫描任务规划与分布式执行。其中,FE 侧承担查询规划、分区裁剪和任务协调,BE 侧负责文件扫描、表达式计算、聚合与数据交换等执行任务。
底层湖仓存储保留京东现有的数据组织和存储体系,包括 Hive、Hudi,以及 ORC、Parquet 等数据格式,并通过适配机制接入内部存储系统。
目前,该架构已承载日均百万级查询,日均数据扫描量达 PB 级,Agent 智能体查询占比已提升至 20%,成功扛住了 7×24 小时全天候的复杂混合负载。
三、 核心技术实践:从查询规划到分布式执行的全链路优化
对于 PB 级数据扫描场景,查询性能瓶颈并不只存在于数据计算阶段。在复杂湖仓环境中,元数据获取、分区裁剪、文件枚举、扫描任务调度以及执行资源管理,都可能直接影响查询的端到端性能。
京东基于 Apache Doris 的技术架构,重点围绕四个方向开展优化。
01 调度优化:从 Pull 到 Push,降低扫描线程等待开销
在大规模湖仓扫描场景中,Doris FE 需要持续生成并分发 Split 扫描任务。在京东此前使用的 Doris 实现中,BE 采用按需拉取的 Pull 模式获取任务。当当前批次任务耗尽时,扫描线程可能因等待 FE 返回而阻塞,尤其在元数据访问抖动时,容易增加扫描资源的无效占用。
为此,京东团队重构了 Doris FE Coordinator 与 BE Scanner 之间的调度协议,改造为 Push 模式。在该模式下,Doris FE 异步主动推送 Split 任务,BE 端维护有界队列。当本地无就绪任务时,扫描线程自动挂起让出 CPU 资源,待新任务到达后被唤醒。同时,系统结合容量与消费反馈动态调节供给节奏。
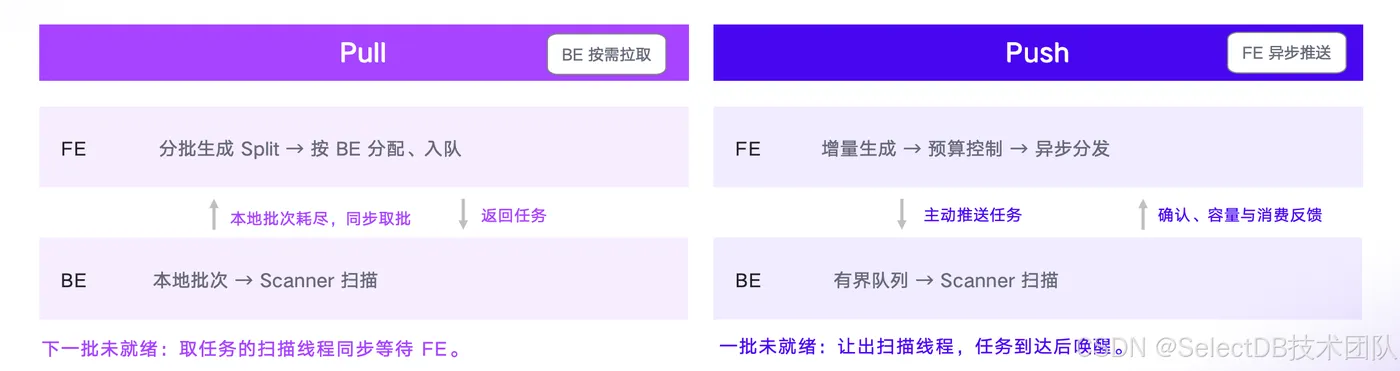
Push 模式的核心收益可以总结为:
释放扫描线程:挂起等待任务的 Scanner,减少元数据等待对扫描资源的占用,更适合高并发文件枚举或元数据抖动场景。
控制任务积压:容量不足时暂停供给,把反压传递到生产侧,约束大规模 Split 带来的缓冲区增长,更适合海量文件多分区大规模扫描。
感知消费差异:结合 BE 的排队与运行状态分配新 Split,优先避开已满队列,缓解由于 BE 消费速度不同导致的任务分配倾斜与拖尾。
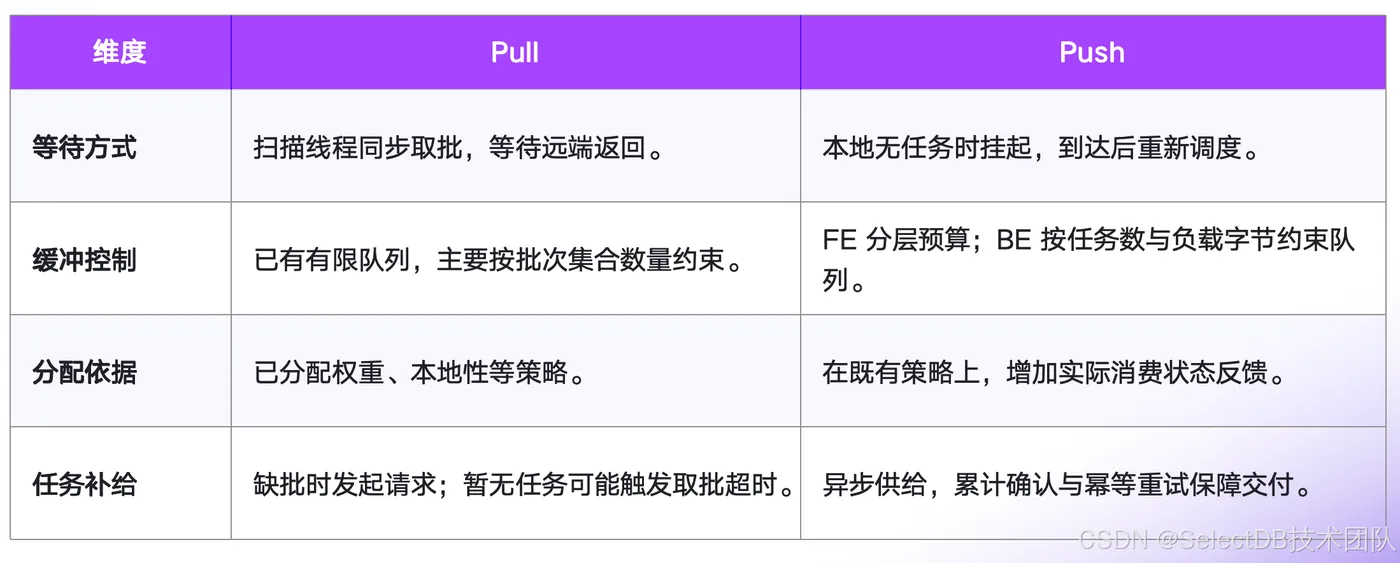
这一实践说明在面向大规模湖仓场景时,不仅要提高任务执行速度,还要减少任务准备与等待过程对计算资源的占用。
02 规划优化:精确分区裁剪,减少无效元数据访问
在大规模湖仓场景中,查询性能不仅取决于数据扫描速度,也受到元数据访问与查询规划效率的影响。尤其对于分区数量庞大的 Hive 表,冷缓存下获取大量分区元数据,可能导致查询尚未进入执行阶段,就已经产生较高的规划开销。
针对这一问题,京东基于 Doris Nereids 优化器框架,优化了分区裁剪流程,将查询谓词前移至候选分区获取阶段,实现按需获取分区、尽早过滤无关数据。
具体而言,团队增强了复杂谓词的推导能力:
对于
date_trunc等函数条件,在满足语义约束时将其转换为分区列的范围条件;针对超长
IN列表,先利用 Range 条件进行候选分区预筛,再由 FE 保留原始条件进行精确过滤。通过常量折叠等机制,尽可能在规划早期简化表达式,减少无效分区进入后续处理流程。
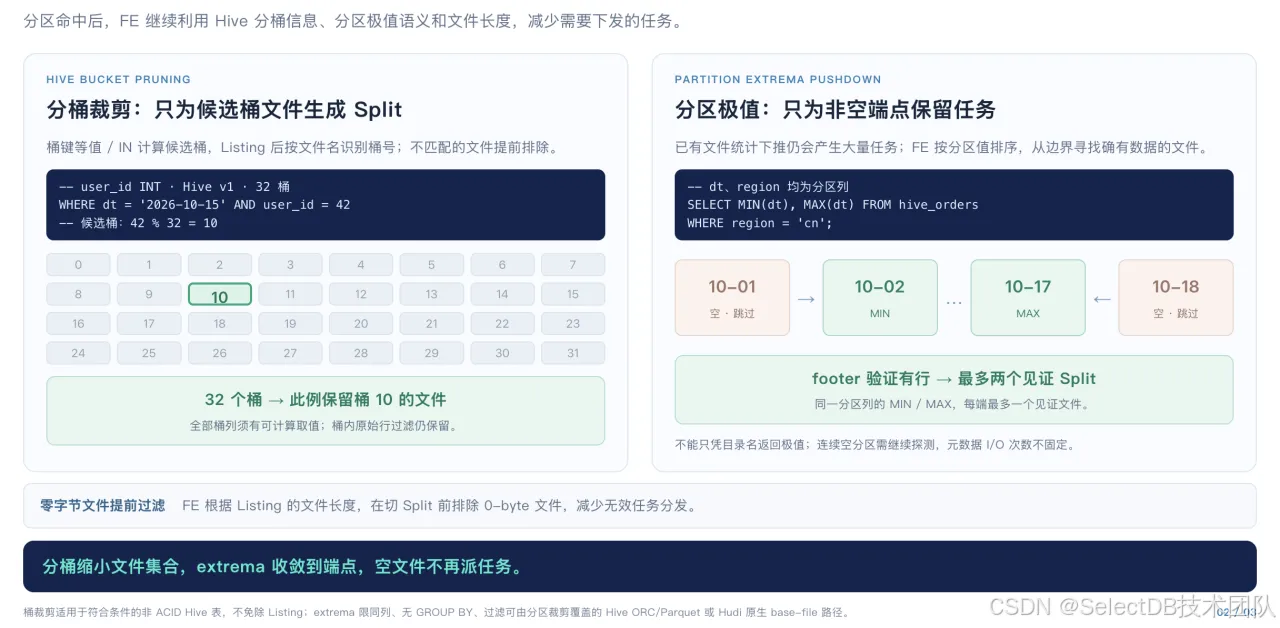
在此基础上,针对湖仓场景下 File Listing 与 CBO 统计信息采集剥离导致的规划缓慢问题,团队实现了“一处准备、多处复用”。
精细裁剪后的分区集合仅执行一次 File Listing,其共享的文件信息既作为 CBO 成本估算的决策基础,又同时用于生成扫描 Split。在同一次查询内,同表、同分区范围可直接复用枚举结果。在估算数据规模时,优先使用选中分区的有效统计信息,缺失时则通过文件总大小、压缩恢复系数与行宽进行推算,减少对逐列获取 MetaStore 统计信息的依赖,兼顾了规划效率与计划质量。
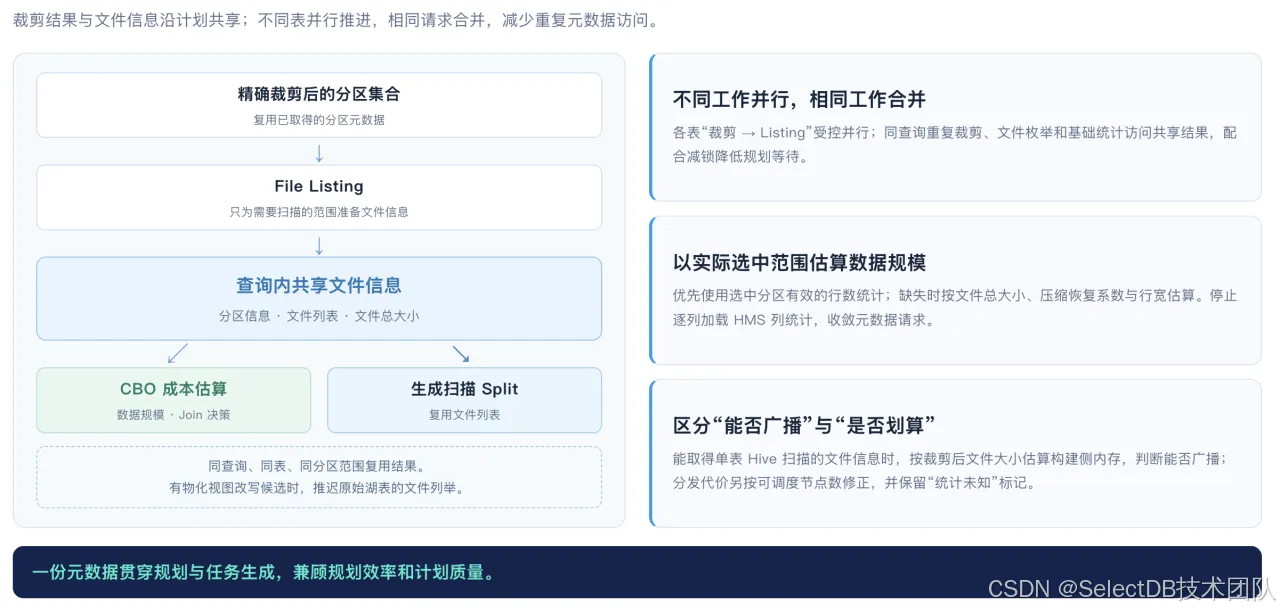
通过将分区裁剪、文件枚举与扫描任务规划协同起来,京东将优化从单纯的 SQL 规划延伸至整个查询准备阶段,为大规模湖仓查询减少不必要的元数据访问与任务生成开销。
03 执行优化:基于 Doris 向量化引擎提升扫描与计算效率
在完成查询规划后,数据读取与算子执行效率直接决定大规模湖仓查询的吞吐能力。京东依托 Apache Doris 的向量化执行框架,针对实际生产环境中的复杂谓词、多格式文件和高频表达式计算,进一步优化 BE 执行路径。
表达式计算方面,团队通过公共子表达式消除(CSE)减少重复计算,结合谓词代价与过滤效果优化执行顺序,并根据运行时反馈动态调整部分谓词的执行策略。同时,对包含常量参数的高频函数进行结果复用,降低重复求值开销。
文件读取方面,针对 ORC、Parquet、Hive Text/LZO 等数据格式,团队从读取上下文复用、按需读取列数据、减少随机访问及优化解压解析等方面入手,降低文件初始化、数据读取与格式解析的额外成本,并通过并发文件打开和 HDFS 连接复用改善大规模文件扫描效率。
过滤与聚合方面,对满足适用条件的 COUNT(*)、MIN/MAX 等查询,充分利用文件统计信息减少不必要的数据读取;针对部分函数谓词,将其转换为可下推的列范围,尽可能在 Row Group 等更细粒度的数据读取阶段过滤无关数据。对于无法精确改写的条件,则保留原始谓词进行精确过滤。
此外,团队还通过自适应 Batch 大小、基于字节量的 Shuffle 流控,以及聚合状态和内存管理优化,降低宽行数据处理时的缓冲与内存压力,提升复杂混合负载下的执行效率与稳定性。
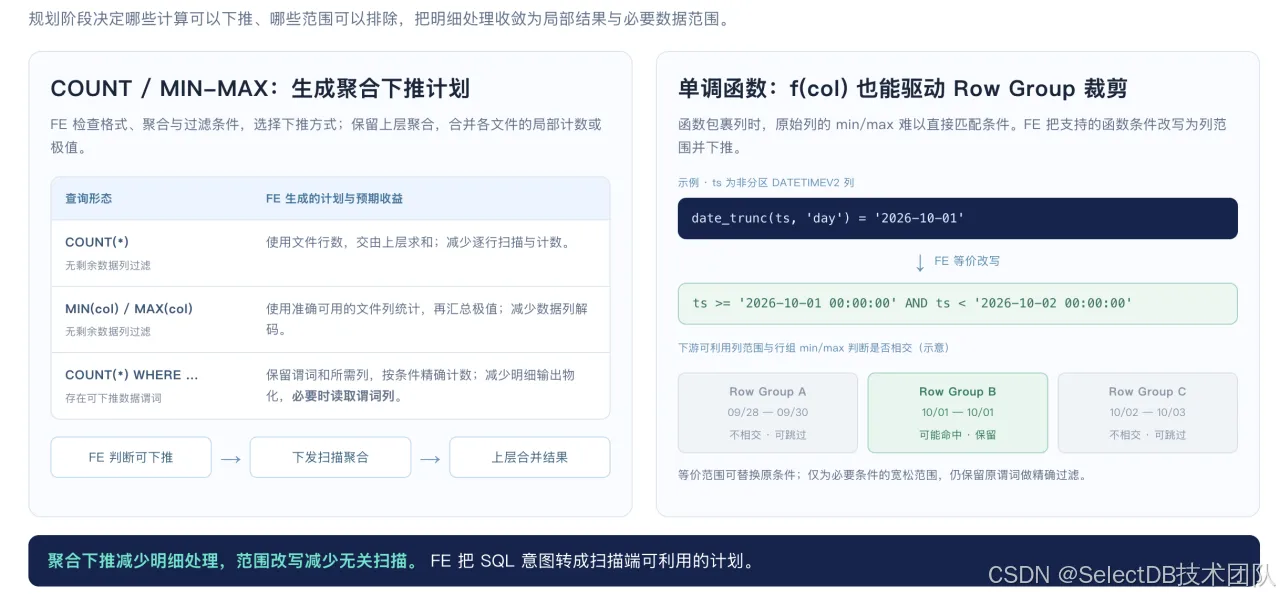
从 FE 查询规划到 BE 分布式执行,京东围绕大规模湖仓查询中的任务等待、元数据访问、文件扫描与计算开销进行了系统性优化。这些实践不仅增强了 Doris 对复杂湖仓负载的适应能力,也为统一分析引擎承载 BI、数据质量和 Agent 等多样化业务场景提供了技术支撑。
四、 生态兼容与安全治理:降低迁移成本,保障统一访问
对于大型企业而言,统一查询引擎不仅需要具备高性能,还必须兼容复杂的历史数据生态,并满足企业级安全治理要求。在推进 Apache Doris 统一湖仓架构的过程中,京东围绕 SQL 方言、存储格式和权限管理开展了进一步适配。
多 SQL 方言兼容层面,系统实现了外层 SQL 与外部视图 SQL 根据指定 Dialect(如 Spark SQL、Presto SQL)自动转换为 Doris 原生 SQL,再进行统一的查询规划与执行,使用户能够在既定兼容范围内保留原有 SQL 使用习惯,降低迁移成本。
存储生态扩展层面,京东深度适配了自研 Hudi 的 LSM-Tree 读取架构,支持按 Commit 时间区间查询增量数据,并完善了 Schema 演进兼容;补齐了 Hive RCFile 和 SequenceFile 存量文件格式的读取能力;同时接入 ChubaoFS 原生文件读取,覆盖了 ORC/Parquet 及使用的 Hudi 原生扫描路径
安全合规维度,将业务身份、请求来源与大数据账号等信息关联至湖仓查询链路,并通过统一认证、凭据管理与权限校验机制,实现数据访问过程的安全管控。系统支持行级、列级权限控制与数据脱敏,并针对 Hive View 场景完善视图授权逻辑,使用户能够在符合权限规则的前提下访问授权视图。通过关联上层业务请求与底层数据访问记录,进一步增强查询链路的可追溯性与审计能力。
五、 未来展望:面向 AI Agent 的下一代湖仓分析架构
京东逐步从 Presto、StarRocks 等多引擎并行,演进至以 Apache Doris 为核心的统一湖仓分析架构。依托 Apache Doris 的 Multi-Catalog、Nereids 优化器与向量化执行能力,京东在保留现有湖仓数据体系的基础上,逐步实现查询计算能力收敛,并通过面向自身大规模生产场景的深度优化,进一步提升统一引擎对复杂查询和混合负载的适应能力。
未来,面向 AI 时代,京东基于 Apache Doris 的湖仓一体架构规划了四大演进方向:
Agent 主导的负载优化:针对 Agent 多步骤、小查询为主导的负载特征,建设会话级缓存与元数据快路径,确保智能体任务的端到端时延与成本可控;
主动式预测加速:结合“双峰潮汐”与 Agent 行为的可预测性,开展查询结果预热与执行计划跨查询复用;
弹性湖仓架构:在 Agent 7×24 小时平滑负载的新画像下,基于 Doris 存算分离架构与快速扩缩容能力承接流量高峰,推动容量规划从按峰值堆资源转向按负载曲线动态调度;
统一语义入口协同:推动 Doris 引擎与 Text-to-SQL 语义层深度协同,提供 Schema 感知的 SQL 生成与校验,使湖仓引擎升级为 AI 分析时代值得信赖的数据底座。
