目前生成式AI已经从简单问答对话,进化为可以处理超长文档、图文音视频混合输入、自主拆解目标完成多步骤业务的通用智能底座。通义千问Qwen3.8完整家族形成了分层能力矩阵,覆盖旗舰推理、均衡通用、高速高吞吐、原生全模态视听、专项编程多类基座,既可以普通用户网页端直接交互体验,也可以通过百炼平台API集成进业务系统,同时开放开源权重,支持本地私有化部署,覆盖个人创作者、独立开发者、中小企业、大型政企的差异化诉求。
很多业务团队在落地过程中,会遇到模型选型混淆、百万上下文使用误区、Agent工具调用不稳定、多模态解析异常、成本不可控、私有化硬件评估不到位等问题。本文完整梳理Qwen3.8家族各模型定位、五大核心技术能力、平台配套开发工具,提供可直接复制运行的curl、Python调用代码,区分网页体验、API集成、私有化部署三种使用路径,梳理选型标准、计费规则以及生产环境高频坑点,帮助不同规模业务完成从原型验证到正式业务上线的全流程落地。详情👉访问阿里云百炼大模型服务平台页面 了解。
一、Qwen3.8家族完整模型矩阵
整个产品家族按照能力定位分为五大系列,不同模型上下文上限、模态支持、推理强度、成本差异明显,业务选型优先匹配场景,不要一味追求最高规格。
- Qwen3.8‑Max旗舰MoE模型:总参数量2.4万亿,推理按需激活95B有效参数,支持百万Token上下文,原生图文视频多模态,可调深度思考模式。擅长法律合同审查、大型代码仓库解析、长周期多轮Agent、科研推演等高复杂度任务。调用ID:
qwen3.8‑max;快照锁定版本:qwen3.8‑max‑0902,生产业务优先快照版本,规避模型迭代带来输出漂移。 - Qwen3.8‑Flash高速轻量模型:主打低延迟高吞吐,百万上下文,支持图文视频输入,工具调用、代码辅助能力完备。适合高并发线上对话、知识库RAG、批量文档预处理、轻量智能体,综合性价比突出。
- Qwen3.7系列(Max/Plus/Flash):上一代成熟基座,能力均衡,存量业务大量使用,适合存量系统维持不变的业务,新业务优先评估3.8版本。
- Qwen3‑Omni原生全模态模型:同时支持文本、图片、音频、视频输入输出,实现视听图文一体化,可解析长时间录音、短视频素材,适合多媒体内容分析、语音对话类业务。
- 专项模型:Coder编程系列、VL视觉系列。Coder面向软件开发做专项优化,擅长项目重构、单元测试生成;VL视觉语言模型聚焦图片、图纸、报表解析,适合图表识别、OCR增强场景。
选型总原则:复杂深度推理选Max;高并发、大批量简单业务选Flash;音视频混合交互选Omni;纯代码开发优先Coder;仅图片解析任务选用VL。详情👉访问阿里云百炼大模型服务平台页面 了解。
二、五大核心技术能力深度解读
1、百万级超长上下文处理能力
全系主力版本支持最高100万Token上下文,折合中文约75万字,依托优化后的混合注意力架构,缓解长文本场景信息遗忘、跨段落逻辑断裂问题。业务场景可以一次性载入整本图书、数十份合同、完整代码库、多小时会议转写文稿,完成跨文档比对、条款风险提取、项目架构梳理。
现实使用存在一个关键限制:虽然窗口上限很高,但越靠后的输入内容召回能力会衰减。业务开发时,需要把核心指令、业务约束放在Prompt靠前位置,参考资料、附件内容放在后面。网页交互界面会存在上传大小限制,超大文档处理建议通过API接口提交。平台配套隐式+显式双重上下文缓存,大量请求复用同一套system系统提示词、知识库公共前缀,缓存命中之后输入Token计费大幅下降,同时降低接口响应时延。
2、可切换混合思考模式(Thinking / Non‑Thinking)
模型支持reasoning_effort参数控制推理强度,档位包含none/minimal/low/medium/high/xhigh。开启高等级思考档位,模型会输出完整内部思维推导链路,思维链全部计入输出Token,消耗更多开销,但是复杂任务准确度明显提升;关闭思考模式,模型直接输出最终结果,延迟更低、Token消耗更少,适配简单问答、摘要生成。详情👉访问阿里云百炼大模型服务平台页面 了解。
搭建Agent智能体场景,多轮工具调用时,需要把上一轮返回的reasoning_content思考内容回传给模型,保障后续任务推理连贯性。离线批量业务可以灵活切换档位,线上业务建议做分层路由,简单任务关闭深度思考。
3、原生一体化多模态理解能力
不再需要外挂第三方视觉组件,原生支持图片、截图、工程图纸、扫描报表、音频、短视频输入。图像场景可以识别合并单元格的复杂表格、手写笔记、UI草图,草图直接生成前端代码;音频支持区分多说话人,输出结构化会议纪要;短视频可以解析镜头事件、提炼脚本。
重要注意事项:图片、视频资源链接需要公网可访问,内网存储素材需要开放外网访问权限,否则模型无法拉取媒体文件,直接调用报错。
4、增强版Function Calling与自主Agent智能体
完整支持Function Calling工具调用框架,可以自定义工具对接自有业务接口,同时内置网页检索、代码解释器、网页抓取工具,不用额外开发就可以完成资料检索、数据运算。面对复杂任务,模型可以自主完成“目标拆解→选择工具调用→接收返回结果→迭代修正”完整闭环,适配调研分析、业务自动化、代码工程开发。
即便Max版本工具调用稳定性大幅提升,线上业务依旧要增加JSON解析异常捕获、重试、降级逻辑,不能完全信任模型输出的工具参数格式。平台同时提供零代码智能体工作台,可以可视化编排工作流、配置知识库、绑定工具集,降低企业搭建业务智能体的门槛。
5、企业全套配套开发能力
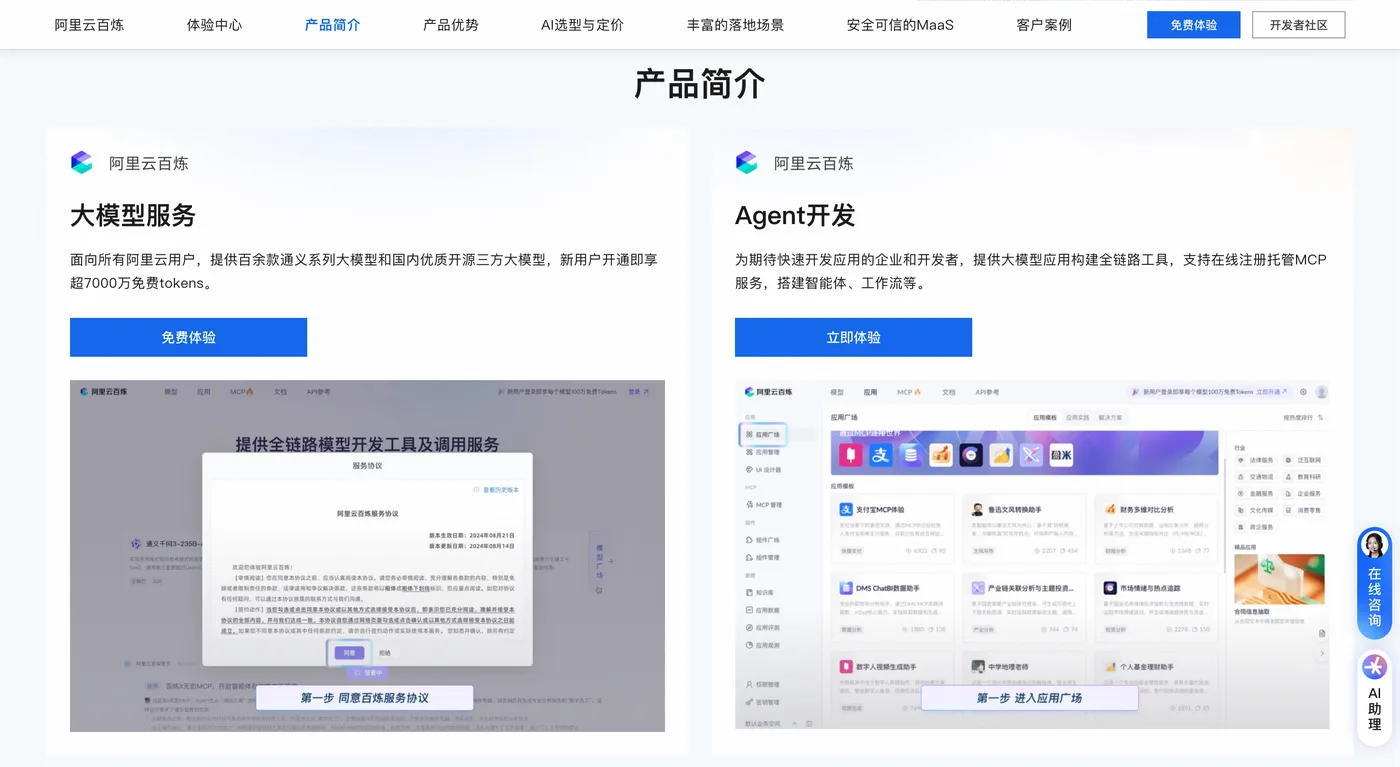
百炼平台提供一整套企业级工具链,赋能大模型业务落地。
- RAG检索增强:上传企业私有文档,基于自有知识库回答,降低模型幻觉;
- 模型微调:使用自有业务标注数据对齐基座,适配行业术语与输出格式;
- Batch批量异步推理:大批量文档离线处理,享受折扣计价,不适合面向用户实时接口;
- 强制结构化JSON输出,便于程序直接解析返回结果;
- 联网搜索,获取实时外部信息,弥补模型知识截止局限;
- 安全审计、RAM权限管控、VPC内网调用,业务数据不会被用于基座训练,传输存储全程加密,满足政企合规监管要求。
三、三种使用路径:网页端体验、API接口集成、私有化部署
网页端交互
普通用户直接网页访问,无需写代码,支持上传PDF、图片、音频,手动切换思考模式,完成写作、文档分析、办公辅助。个人免费版本开放绝大多数基础能力,Pro会员提升单文件上限、多模态额度、响应优先级,适合重度个人使用者。网页端适合做效果验证,不适合大规模自动化业务调用。
API接口集成(开发者/中小企业主流选择)
支持DashScope原生SDK、OpenAI兼容接口两套调用方式,原有OpenAI体系开发的业务,仅替换API‑Key与base_url,改动很小即可迁移。支持按量付费、Token Plan个人版、Token Plan团队版,新人免费额度仅华北2(北京)地域生效。
安全规范:密钥禁止硬编码写进源码,优先操作系统环境变量、密钥管理服务保存凭证。
Linux/macOS环境变量配置:
export DASHSCOPE_API_KEY="sk-xxxxxxxxxxxxxxxxxxxxxxxxxxxx"
export BAILIAN_COMPAT_URL="https://dashscope.aliyuncs.com/compatible-mode/v1"
echo $DASHSCOPE_API_KEY
Windows PowerShell配置:
$env:DASHSCOPE_API_KEY="sk-xxxxxxxxxxxxxxxxxxxxxxxxxxxx"
$env:BAILIAN_COMPAT_URL="https://dashscope.aliyuncs.com/compatible-mode/v1"
curl命令行调用示例,开启深度思考:
curl $BAILIAN_COMPAT_URL/chat/completions \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H "Content‑Type: application/json" \
-d '{
"model":"qwen3.8‑max",
"messages":[
{"role":"system","content":"你是法务分析助手,输出结构化markdown风险清单"},
{"role":"user","content":"简述商业合同审核需要重点核查的核心风险点"}
],
"extra_body":{"reasoning_effort":"high"},
"temperature":0.6,
"max_tokens":8192
}'
Python基础同步调用示例,先安装依赖:
pip install dashscope openai -U
import os
from dashscope import Generation

dashscope.api_key = os.getenv("DASHSCOPE_API_KEY")

resp = Generation.call(
    model="qwen3.8‑max",
    messages=[
        {
   "role":"system","content":"你是专业业务分析助手,回答严谨简洁。"},
        {
   "role":"user","content":"简述企业搭建Agent智能体的关键落地步骤"}
    ],
    result_format="message"
)

if resp.status_code == 200:
    print(resp.output.choices[0].message.content)
else:
    print(f"调用失败,错误码:{resp.code},错误信息:{resp.message}")
Python流式输出示例,适合前端交互场景,边生成边返回片段:
import os
from dashscope import Generation
from http import HTTPStatus

dashscope.api_key = os.getenv("DASHSCOPE_API_KEY")

responses = Generation.call(
    model="qwen3.8‑flash",
    messages=[
        {
   "role":"system","content":"你是Python编程助手"},
        {
   "role":"user","content":"写一段读取csv文件的简易示例代码"}
    ],
    stream=True,
    incremental_output=True,
    result_format="message"
)

for r in responses:
    if r.status_code == HTTPStatus.OK:
        chunk = r.output.choices[0].message.content
        print(chunk, end="", flush=True)
    else:
        print(f"\n请求异常 {r.code}:{r.message}")
多模态图片解析调用示例:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get("DASHSCOPE_API_KEY"),
    base_url=os.environ.get("BAILIAN_COMPAT_URL")
)

resp = client.chat.completions.create(
    model="qwen3.8‑max",
    messages=[
        {

            "role":"user",
            "content":[
                {
   "type":"text","text":"解析这张报表截图,输出markdown表格提取数据"},
                {
   "type":"image_url","image_url":{
   "url":"https://demo‑report‑sample.jpg"}}
            ]
        }
    ],
    max_tokens=12288,
    extra_body={
   "reasoning_effort":"medium"}
)
print(resp.choices[0].message.content)
私有化开源部署
Qwen系列开放开源权重,对数据隔离、内网闭环有极高要求的政企,可以下载权重在自有硬件部署。注意大参数量模型对显存、算力硬件门槛很高,消费级显卡很难完整跑通Max规格,需要提前做硬件规格评估;私有化部署不享受平台计费、缓存、监控等托管能力,运维成本更高。
四、计费模式梳理
- 按量付费:输入、输出Token分开计价,缓存命中输入享受折扣;Max系列拥有NightPlan夜间折扣,Flash不参与夜间优惠;Batch批量异步推理有离线折扣。新人免费额度仅限华北2(北京),快照版本同样可以消耗免费Tokens。
- Token Plan个人版:面向个人开发者,Credits统一抵扣,额度仅限单账号,不可拆分多子账号。
- Token Plan团队版:面向企业,多子账号共享Credits资源池,配套用量审计、成员权限管控。
重要风险点:Credits全部耗尽不会阻断业务,会自动切换至按量付费,必须配置用量告警阈值,防止产生高额账单。
五、业务选型判断标准
✅ 优先选择Qwen3.8‑Max
法律金融合同深度审查、大型项目工程开发、几十轮长周期Agent任务、百万字长文档比对、长视频深度解析、复杂数理科研推导。
✅ 优先选择Qwen3.8‑Flash
高并发在线问答、知识库RAG、批量文档预处理、轻量工具调用Agent、简单图文识别,追求控制调用成本。
✅ 优先选择Qwen3‑Omni
需要同时处理文本、长音频、短视频,做多媒体内容分析、语音交互业务。
✅ 优先选择开源私有化部署
强数据隔离要求,所有业务数据不流出内网,愿意承担硬件、运维成本。
企业线上业务推荐分层路由架构:业务网关判断任务复杂度,简单请求路由Flash,中等复杂度路由Plus,高难度复杂推理才分发至Max,兼顾业务效果与整体成本。
六、生产环境高频踩坑与避坑指南
百万上下文不等于无限记忆
输入文档越长,文档靠后部分召回能力衰减。核心业务指令、约束条件写在Prompt靠前位置;超大规模任务不要全部塞进单次请求,合理做任务拆分。深度思考档位带来成本失控
reasoning_effort默认高档位,思维链全部计入输出Token。不要全局无脑开启xhigh,业务代码根据任务难度动态切换档位,简单任务关闭思考模式。缓存不是万能优化手段
缓存收益来自大量请求复用相同system提示、公共知识库前缀;如果每次请求内容全部动态变化,缓存很难命中,开启缓存反而带来额外创建开销。以控制台账单缓存计费明细判断是否真正命中缓存,不要只看接口返回字段。模型幻觉风险不可忽视
即使新版本基座,依旧存在虚构事实现象。金融、法务等高风险业务,模型输出不能直接交付给用户,业务层必须增加校验、复核逻辑。地域与密钥隔离
不同地域API‑Key互相独立,密钥不可以跨地域复用;新人免费额度仅华北2(北京)地域生效。密钥安全风险
严禁硬编码密钥写入代码,禁止提交Git仓库;闲置不用的API‑Key及时删除。私有化部署硬件门槛
Max大参数量模型,普通显卡硬件资源不足以支撑,部署前做好算力、显存评估,私有化会缺失托管平台的监控、缓存、告警全套能力。Token Plan额度耗尽自动切按量
不会返回报错阻断请求,一定要开启用量告警,定期监控Credits消耗。
七、落地最佳实践总结
通义千问Qwen3.8家族构建起完整分层大模型能力体系,覆盖旗舰复杂推理、高速高吞吐、原生全模态视听、专项编程多类基座。拥有百万级超长上下文、可调深度思考模式、原生多模态理解、增强Agent工具调用,搭配RAG知识库、微调、批量异步推理等全套企业开发工具。详情👉访问阿里云百炼大模型服务平台页面 了解。
使用者分为网页快速体验、API托管调用、开源私有化部署三条路径,绝大多数个人、中小企业优先选择百炼平台API托管服务,省去底层硬件运维。生产业务优先使用快照版本锁定模型输出行为,线上业务搭建分层路由策略,按照任务难度分配不同模型,控制整体调用成本。
开发过程中合理使用上下文缓存优化重复请求,对Agent工具调用增加JSON解析异常捕获与重试降级;上线前配置用量告警,规避Credits耗尽自动切换按量付费带来的账单风险;高风险业务增加人工或者业务侧校验,规避模型幻觉带来业务错误。
选型的核心逻辑不是一味选择最高规格旗舰模型,而是结合业务任务难度、并发规模、数据合规诉求,匹配对应的基座与部署方式,把大模型能力真正和自身业务流程结合,把重复人工工作交由AI完成,释放人力投入更高价值的业务创造。