<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-strict.dtd"> <html><head><meta http-equiv="Cont

简介:       前段时间公司hadoop集群宕机,发现是namenode磁盘满了, 清理出部分空间后,重启集群时,重启失败。又发现集群Secondary namenode 服务也恰恰坏掉,导致所有的操作log持续写入edits.new 文件,等集群宕机的时候文件大小已经达到了丧心病狂的70G+..重启集群报错 加载edits文件失败。

      前段时间公司hadoop集群宕机,发现是namenode磁盘满了, 清理出部分空间后,重启集群时,重启失败。

又发现集群Secondary namenode 服务也恰恰坏掉,导致所有的操作log持续写入edits.new 文件,等集群宕机的时候文件大小已经达到了丧心病狂的70G+..重启集群报错 加载edits文件失败。分析加载文件报错原因是磁盘不足导致最后写入的log只写入一半就宕机了。由于log不完整,hadoop再次启动加载edits文件时读取文件报错。由于edits.new 文件过大,存储了好多操作log,所以必须要对其进行修复。

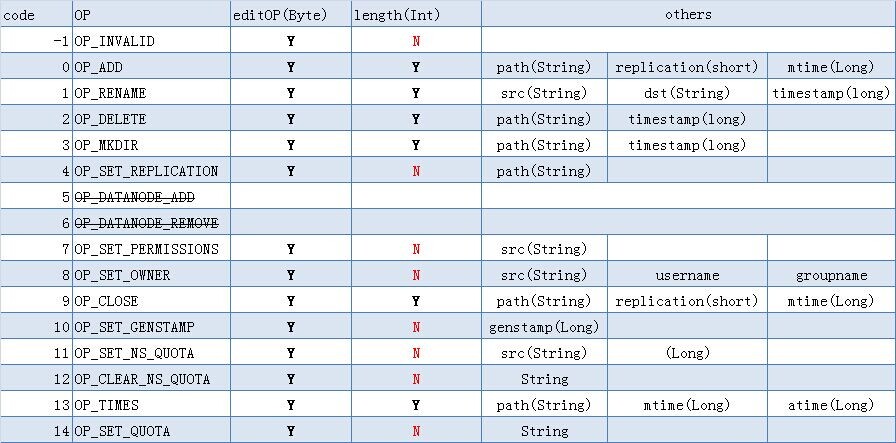
        尝试删除文件的最后几行,结果还是报错。于是查看源码对edits 文件结构进行分析发现是二进制格式,首行为版本号,然后是hadoop运行过程中的log记录内容,由操作码 +长度(非必须)+其他项组成。

edits文件格式分析图
解决办法

报错位置在源码中的方法为org.apache.hadoop.hdfs.server.namenode.FSEditLog.loadFSEdits(EditLogInputStream edits)方法中读取文件最后位置时因为缺少部分数据报错, 所以把这部分代码单独拿出来,去掉业务操作部分,只留读取过程,记录异常之前的文件长度len,然后将0到len 这部分的内容复制出来成新的edits文件。启动hadoop集群,成功!

NameNode启动加载元数据流程

  • NameNode函数里调用FSNamesystemm读取dfs.namenode.name.dir和dfs.namenode.edits.dir构建FSDirectory。

  • FSImage类recoverTransitionRead和saveNameSpace分别实现了元数据的检查、加载、内存合并和元数据的持久化存储。

  • saveNameSpace将元数据写入到磁盘,具体操作步骤:首先将current目录重命名为lastcheckpoint.tmp;然后在创建新的current目录,并保存文件;最后将lastcheckpoint.tmp重命名为privios.checkpoint.

  • checkPoint的过程:Secondary NameNode会通知nameNode产生一个edit log文件edits.new,之后所有的日志操作写入到edits.new文件中。接下来Secondary NameNode会从namenode下载fsimage和edits文件,进行合并产生新的fsimage.ckpt;然后Secondary会将fsimage.ckpt文件上传到namenode。最后namenode会重命名fsimage.ckpt为fsimage,edtis.new为edits;

目录
相关文章
|
Web App开发 前端开发
|
Web App开发 监控 前端开发
|
Web App开发 前端开发 算法
<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-strict.dtd"> <html><head><meta http-equiv="Cont
基于大数据的精准营销与应用场景 2015年08月11日 大数据 大数据营销时代来临营销学领域过去半个多世纪的发展让我们见证了从“以产品为中心”到“以客户为中心”的转变。
1194 0
|
SQL Web App开发 前端开发
<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-strict.dtd"> <html><head><meta http-equiv="Cont
     如果在INSERT语句末尾指定了ON DUPLICATE KEY UPDATE,并且插入行后会导致在一个UNIQUE索引或PRIMARY KEY中出现重复值,则在出现重复值的行执行UPDATE;如果不会导致唯一值列重复的问题,则插入新行。
1048 0
|
Web App开发 前端开发
|
数据库
<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-strict.dtd"> <html><head><meta http-equiv="Cont
CentOS 6.5安装配置ldap 时间:2015-07-14 00:54来源:blog.51cto.com 作者:“ly36843运维” 博客 举报 点击:274次 一.
1147 0
|
Web App开发 前端开发
<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-strict.dtd"> <html><head><meta http-equiv="Cont
原文见:http://kafka.apache.org/documentation.html#semantics kafka在生产者和消费者之间的传输是如何保证的,我们可以知道有这么几种可能提供的delivery guarantee: At most once 消息可能会丢,但绝不会重复传输 At least one 消息绝不会丢,但可能会重复传输 Exactly once 每条消息肯定会被传输一次且仅传输一次,很多时候这是用户所想要的。
1108 0
|
Web App开发 前端开发 大数据
<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-strict.dtd"> <html><head><meta http-equiv="Cont
一、概述   多维数据模型是最流行的数据仓库的数据模型,多维数据模型最典型的数据模式包括星型模式、雪花模式和事实星座模式,本文以实例方式展示三者的模式和区别。
959 0
|
Web App开发 前端开发 数据库
<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-strict.dtd"> <html><head><meta http-equiv="Cont
数据仓库建模:定义事实表的粒度Posted on 2015-08-25 09:03 xuzhengzhu 阅读(28) 评论(0) 编辑 收藏 维度建模中一个非常重要的步骤是定义事实表的粒度。
930 0
|
Web App开发 前端开发
<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-strict.dtd"> <html><head><meta http-equiv="Cont
在统计分析系统中, 维度:指人们分析事物的角度。比如,分析活跃用户,可以从时间的维度,也可以从地域的维度去看,也可以时间、地域两个维度组合去分析。
837 0

热门文章

最新文章