一个让人抓狂的现象
本地跑得好好的,测试环境也没问题。
一上线部署三个实例,接口就开始大面积报限流。
查了半天,代码一行没改——变的只是实例数量。
这就是并发控制最反直觉的地方:它是一个"局部正确、整体出错"的问题。
每个实例单独看都是对的:它遵守了"每秒不超过 N 次"的约定。但三个实例一起跑,实际请求量就是 3N——每个实例都在合规,加起来就超标了。
下面把接口并发控制里最容易踩的四个陷阱拆开讲。
陷阱一:把限流配额当成"每台机器的配额"
这是最根本的认知错误。
大多数平台给的限流额度是按应用(AppKey)维度算的,不是按机器算的。
也就是说:
场景 |
单实例 QPS |
实例数 |
实际总 QPS |
是否超标 |
本地测试 |
10 |
1 |
10 |
不超标 ✓ |
上线部署 |
10 |
3 |
30 |
严重超标 ✗ |
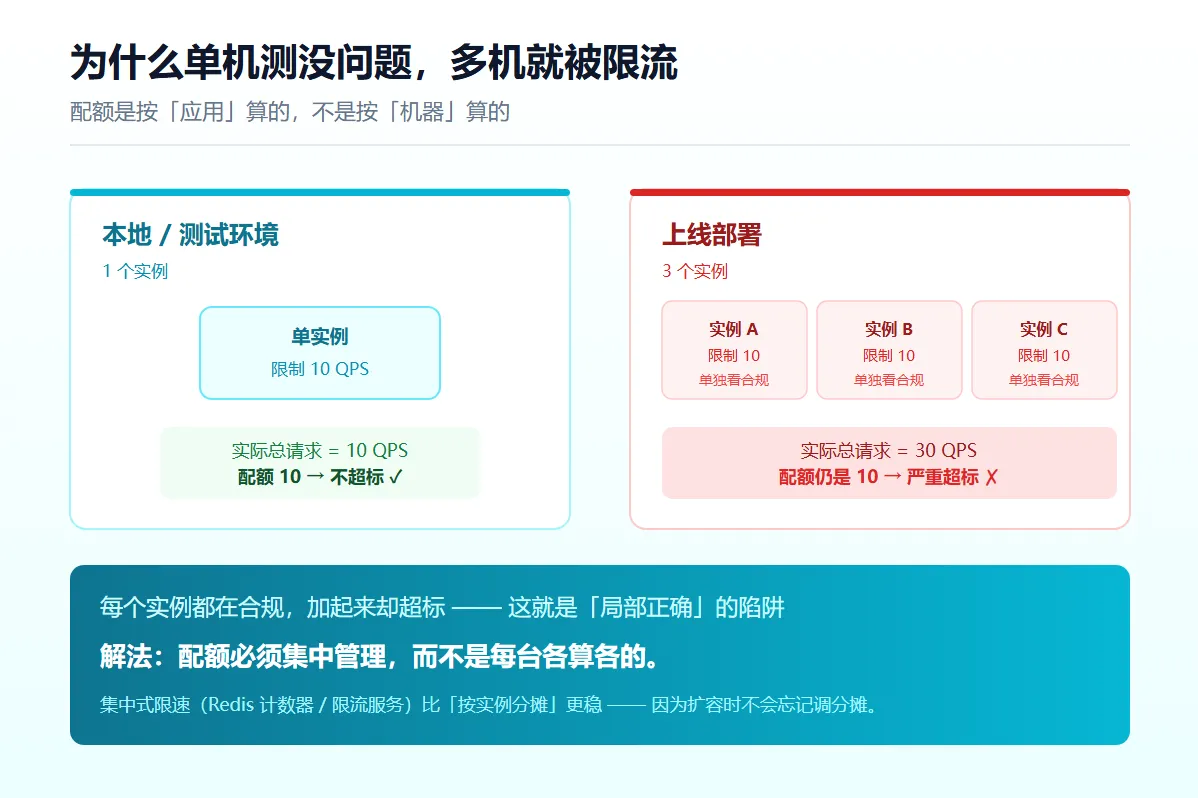
图 1 · 配额按应用维度共享,实例数一多总量就翻倍
问题在于:配额是共享的,但限速逻辑是分布式的。
如果你在每台机器上独立做了限速(比如每台限制 10 QPS),那总请求量就是实例数 × 10,配额不变的情况下必然被打爆。
正确的做法有两种:
- 集中式限速:把配额放在一个共享的地方(Redis 计数器、专门的限流服务),所有实例统一从这里取配额
- 按实例分摊:如果平台允许,把总配额除以实例数,每台机器只跑自己那份
第一种更准确,第二种更简单但鲁棒性差(实例数一变,分摊就要跟着调,扩容时很容易忘记)。
我倾向第一种,因为"扩容时忘记调分摊"这个错误几乎必然会发生一次。
陷阱二:限流后"等一会儿再试",但所有人都在等
这个陷阱很有意思,它和上一篇讲的退避策略有关联,但方向不同。
假设你做了限流保护:遇到限流就等待一秒再重试。
单实例的情况下,这个策略完全正确。
但多实例呢?三台机器在同一秒被限流,它们会在下一秒的同一时刻一起重试。
于是:
时刻 |
实例 A |
实例 B |
实例 C |
总请求 |
T |
被限流 |
被限流 |
被限流 |
— |
T+1s |
重试 |
重试 |
重试 |
3 次同时打 |
T+2s |
又限流 |
又限流 |
又限流 |
— |
它们会永远同步下去。 因为它们的等待时间是完全一样的。
这就是所谓的"重试风暴"或"共振"。
解法是加入随机抖动(jitter):
# 错误:固定等待,所有实例会同步
wait(1.0)

# 正确:基础等待 + 随机抖动
wait(1.0 + random(0, 0.5))    # 每个实例的等待时间都不同
加了抖动之后,重试时间被打散,峰值就被削平了。
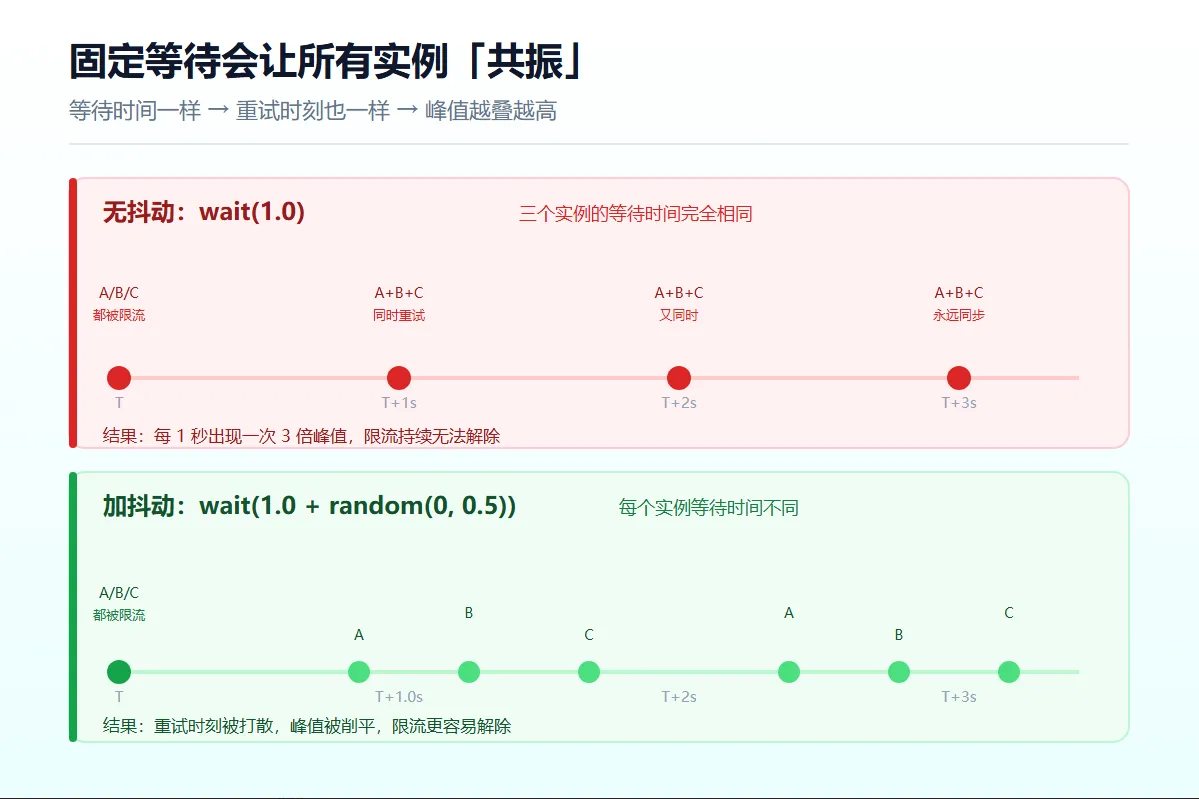
图 2 · 固定等待让三个实例永远同步重试,加抖动后峰值被削平
这条规则适用于所有"失败后等待再试"的场景,不只是限流。
陷阱三:把"限流"和"故障"当同一类错误处理
很多系统的错误处理是"一刀切"的:请求失败 → 重试。
但限流和真正的故障,处理方式完全相反。
限流 |
服务故障 |
|
含义 |
对方好的,只是你太快了 |
对方可能真的出问题了 |
错误做法 |
继续增加并发 |
继续增加并发 |
正确做法 |
降低并发,减速 |
等待恢复,不要加剧 |
短期目标 |
降速就能通过 |
减载,避免雪崩 |
关键区别在于:限流是"你做错了",不是"对方做错了"。
遇到限流还持续重试,等于在告诉对方"我要更多",结果只会被限制得更久。
正确的处理方式:
- 收到限流响应(通常是特定状态码)→ 立刻降低发送速率
- 如果是持续限流 → 进入"降级模式",只发关键请求(比如只保证订单,暂缓非关键的统计类请求)
- 不要靠重试去"撞开"限流 —— 撞不开的
if resp.status == RATE_LIMITED:
    # 关键:减速,不是重试
    current_rate = max(min_rate, current_rate * 0.5)
    sleep(backoff_with_jitter())
注意那个 max(min_rate, ...)——降速也要有下限,无限降下去最后变成完全不发,那也不对。
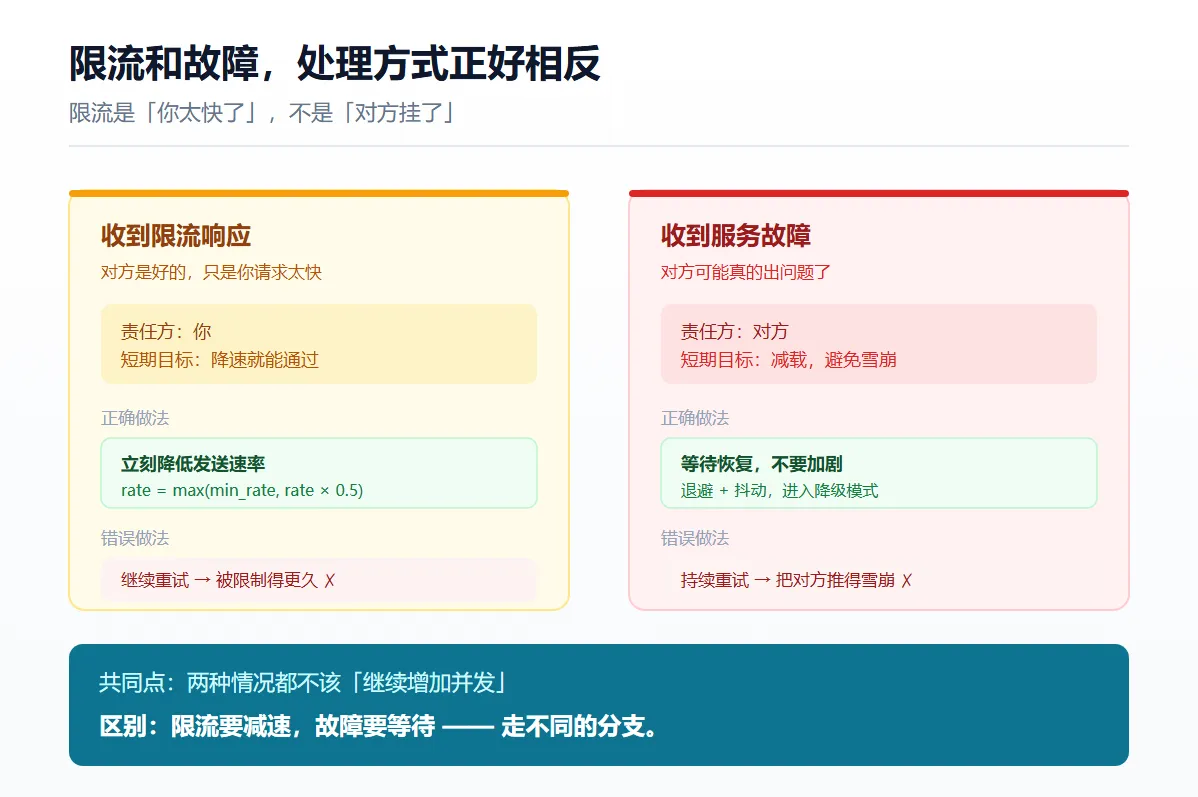
图 3 · 限流要减速,故障要等待——两者都不该增加并发
陷阱四:只做入口限流,忘了出口可能被"内部放大"
最后一个陷阱比较隐蔽:一个外部请求,可能触发多个内部请求。
比如:
- 一个"批量查询订单"的接口调用 → 内部可能拆成 20 个单条查询
- 一次"同步商品"的触发 → 内部可能拉取商品详情 + 价格 + 库存 + 图片,4 个接口
这时候,你以为自己在控制入口的 QPS,实际上出口的 QPS 被放大了好几倍。
解法是在"实际发起调用的地方"做限流,而不是在"接收请求的地方"。
用一张令牌桶(token bucket)或信号量(semaphore)来控制真实的出站请求:
# 无论谁来调用,最终都要经过这个闸门
with outbound_limiter:      # 全局信号量
    resp = call_remote_api(...)
关键点:闸门要放在真正发请求的那一层,而不是业务逻辑的入口。
很多团队把限流写在 Controller 层,但真正的请求是在异步任务、定时任务、消息消费里发出去的——这些路径完全绕过了你的限流器。
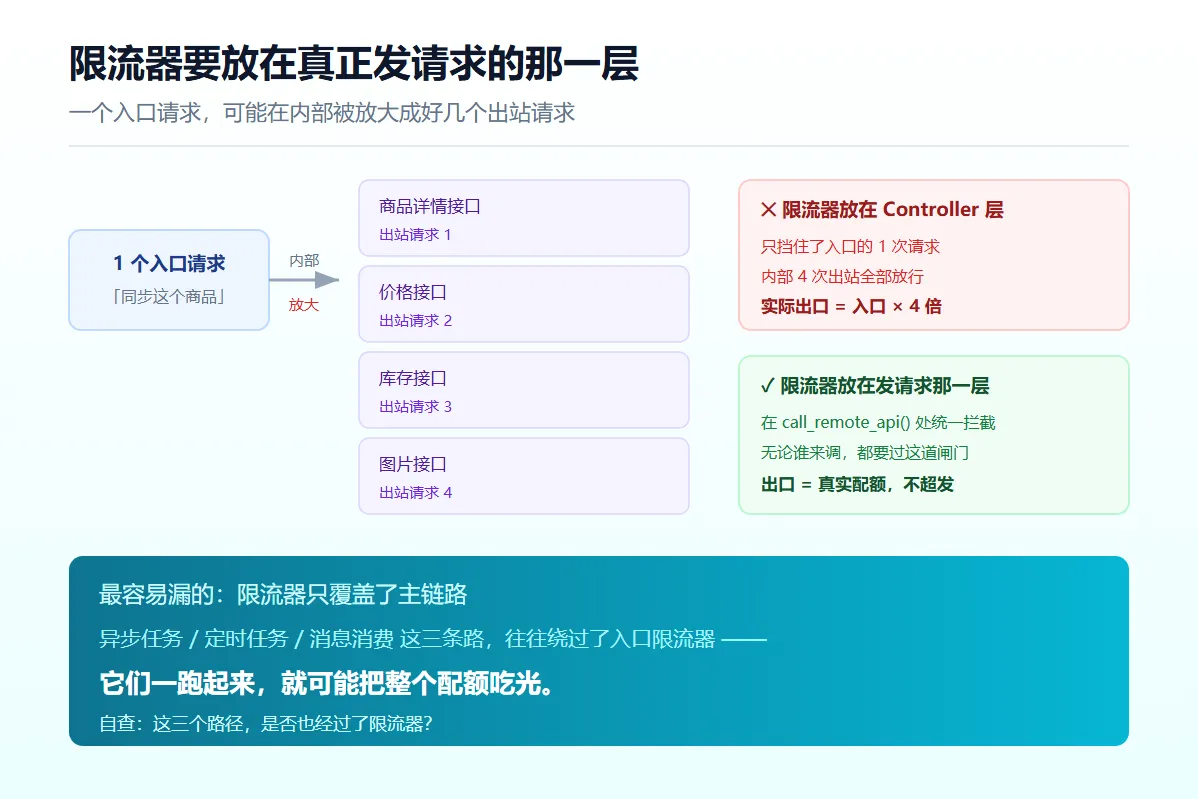
图 4 · 限流器放在 Controller 层挡不住内部的放大效应,闸门要在发请求那一层
四个陷阱的自查表
- 限流额度是按应用维度共享的,我按实例数算过总量吗?
- 多实例的限速是集中式的,还是每台各算各的?
- 等待重试时有随机抖动吗?(不是固定间隔)
- 限流的处理和故障的处理,走的是不同分支吗?
- 降速是否有下限,不会一路降到零?
- 限流器放在真正发请求的那一层了吗?
- 异步任务、定时任务、消息消费这些路径,是否也经过了限流器?
最后一条是最容易漏的——限流器写了,但只覆盖了主链路。后台任务那条路没有闸门,一跑起来就把整个配额吃光了。
小结
回到开头那个现象。
单机没问题,多机就被限流——问题的本质不是"你的限速写错了",而是:
你假设了"我的应用只在一台机器上",但现实是多台机器共享同一个配额。
分布式系统里,很多"局部正确"的逻辑,在放大到多实例之后都会失效:
- 本地计数器 → 多实例不同步
- 本地锁 → 跨进程无效
- 本地限速 → 配额被超发
所以真正的判断标准不是"这段代码对不对",而是"这段代码在几个实例上跑,还对不对"。
设计并发控制时,先问一句:这个状态,是我自己独占的,还是大家共享的?
答案决定你的实现方式。