自动化操作的留痕要做到什么程度-四个对象留存周期与异步旁路

简介: 自动化需留痕,否则追责无据。关键在“四全”:谁发起、依何数据、执行何动作、结果如何,并绑定业务单据。按风险分级留存(5年/3年/180天),异步旁路不阻塞主流程,确保可追溯、可验证。

自动化跑得快,但如果没人能说清某一步是谁做的、依据是什么,出问题时就答不上来。留痕这件事,往往是在首次被问之后才开始补。

一、先给结论

结论是:留痕要覆盖四个对象——谁发起、依据哪份数据、执行了什么、结果如何。四个都记全,事后还原就够用。留痕的难点不在记录,在于记录结构要与业务单据绑定,而不是单独存一份日志。企业级智能体自动化引入机器执行之后,操作主体从单一自然人变成了人与系统两类。

二、四种留痕缺一不可

主体留痕:发起人与执行主体。系统执行时要带一个可识别的系统标识,而不是笼统写"系统"。

依据留痕:本次执行用到的数据快照标识。同一批数据在不同日期执行结果可能不同,必须能取回当时的快照。

动作留痕:具体执行了哪些操作,改了哪些字段,改动前后分别是什么。

结果留痕:成功、失败、转人工三种结局,以及失败原因。

这四种分开存会让还原变困难,建议以业务单据为主键串起来。串起来之后,一次追溯的动线是:从单据查执行记录,从记录取数据快照,从快照还原当时口径。

三、留存周期按风险定,不按习惯定

不同操作的留存时长应当不同。涉及资金、合同、个人信息的操作留存期长一些,常规查询类的短一些。我们按三类分别设定:资金与合同类 5 年,个人信息与权限类 3 年,常规查询类 180 天。周期定下来之后,归档与清理才有依据,不至于一次性把该留的也清掉。

四、留痕不能阻塞主流程

留痕失败如果阻塞业务,这套机制很快会被当成负担。我们的做法是留痕走旁路:主流程执行完成后异步写痕,写失败进留痕队列单独补。这样即使留痕侧出问题,业务仍然可以正常完成,只是事后补记会慢一些。补记由后台任务按批次追平,每批不超过 200 条,确保留痕到位的时点是可预期的。

五、我们踩过的三个具体坑

只记操作不记依据。事后无法还原当时用的是哪份数据,结论无法复核。补上快照标识才解决。

留痕与主流程同步写。留痕侧抖动直接拖慢业务,一度被当成性能瓶颈。改成异步旁路之后,主流程耗时明显下降。

清理规则一刀切。统一按一个周期清理,把仍在保留期内的权限类记录也清掉了。按风险分级之后问题消失。

六、行业里已经跑到什么规模

受监管行业的留痕要求更明确。某轴承企业的银行资金场景公开覆盖 14 类、日均 2000 笔以上;某金融集团公开的业务场景数量达到 220 个以上。操作量到了这个级别,靠人工翻台账核对已经不现实。

七、怎么验证这套机制真的生效

留痕完整率:四个对象齐全的记录占比。

追溯耗时:从提问到给出完整还原的平均时长。

补记滞后时长:异步补记的平均延迟。

留痕失败量:进留痕队列等待补写的记录数。

这四项里,追溯耗时直观反映留痕串得是否通顺。

检查清单

是否记全发起人、执行主体、数据快照、动作与结果。

留存周期是否按资金、个人信息、常规查询三类分别设定。

留痕是否走异步旁路,不阻塞主流程。

追溯时能否按业务单据主键串起完整链条。

归档清理是否有明确的周期依据。

相关文章
|
2月前
|
网络协议 数据建模 应用服务中间件
免费SSL证书只有90天了:2026年阿里云个人测试证书申请与部署全流程
免费SSL证书有效期已缩至90天、每年限领20张。本文讲清个人测试证书免费版/Pro/正式证书怎么选,附申请、Nginx部署全流程和续期自动化思路。
|
2月前
|
存储 JSON API
百炼声景模型新成员实测:Qwen-Audio-3.1-TTS-Next 的调用路径、时序控制与成本边界
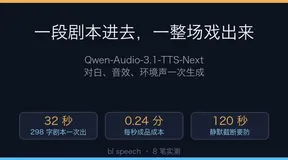
阿里百炼新推Qwen-Audio-3.1-TTS-Next(9月21日上线),支持文本一键生成含人声、音效、环境声的时序化声景,告别单音色朗读。实测覆盖接口调用、时序控制与成本核算,提示词≤3000字符,成品≤120秒,输出200 token/秒,约0.24分/秒。
百炼声景模型新成员实测:Qwen-Audio-3.1-TTS-Next 的调用路径、时序控制与成本边界
|
2月前
|
JSON 人工智能 测试技术
Agent Skills、MCP、Function Calling 到底啥区别?一文讲透
本文厘清AI Agent三大核心概念:Function Calling(模型调用工具的“嘴”,负责结构化指令)、MCP(标准化连接协议, akin “插座”,解耦模型与工具)、Agent Skills(封装业务逻辑的“经验包”,含流程、异常处理与复用能力)。三者呈层级协作关系,非替代关系,共同构建可落地的自动化测试体系。
批量任务中断之后怎么续跑-分片幂等与失败重试的三条分级
批量任务最危险的不是跑不动,而是“跑一半中断”。本文直击痛点,提出“分片+幂等+断点记录”三支柱方案:按业务主键切片、先落状态再执行、失败三级分类重试,并附可落地的检查清单与验证指标。
|
2月前
|
人工智能 前端开发 安全
Java 后端如何驯服会幻觉的 Agent?用 n8n 打造确定性工作流,Token 直降 80%
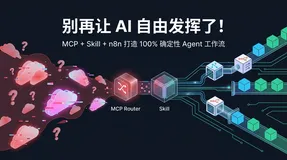
本文揭秘企业级AI Agent落地痛点:幻觉、高Token成本、流程不可控。提出“AI管意图,n8n管执行”架构,融合MCP协议、Skill路由与n8n工作流,实现零幻觉、省80% Token、凭证隔离、全流程可视化——让大模型专注理解,工程系统保障确定性。
217 0
Java 后端如何驯服会幻觉的 Agent?用 n8n 打造确定性工作流,Token 直降 80%
专利年费与知识产权台账怎么做稳-八字段三道校验与分档预警
专利年费管理关键在结构化台账与三重校验:覆盖8项核心字段,自动校验完整性、连续性及主体一致性,分档预警(30/60/90天+当日),杜绝漏缴。低频高风险事务,自动化拦截远胜人工提醒。
|
2月前
|
存储 关系型数据库 分布式数据库
阿里云数据库PolarDB和RDS架构有什区别?区别对比及选型指南
阿里云PolarDB与RDS核心区别在于架构:PolarDB采用计算存储分离的云原生架构,支持100TB存储、分钟级弹性扩缩、RPO=0强一致;RDS为传统主备架构,容量限2–3TB,扩展较慢。选型建议:高并发、大容量选PolarDB;小规模稳态业务选RDS。(239字)
|
2月前
|
人工智能 知识图谱 SEO
在GEO公司干了一个月,才知道,企业AI获客就靠这6张表就够了
本文揭秘GEO(生成式搜索引擎优化)底层逻辑:非传统SEO,核心是让AI用你的话回答问题。聚焦三大关键——构建知识图谱实体、建立AI信任三关、结构化信源建设,强调“讲得清、结构对”才是被AI识别与推荐的根本。
146 1
|
2月前
|
机器人
大模型接入之后的执行编排怎么设计-拆分归一与三种结局
大模型接入后效果不稳定?问题常出在编排而非模型本身。本文系统提出企业级智能体稳定落地的四大关键:按可验证性拆分任务、多轮结果结构化归一、预设三类失败结局(重试/转人工/中止告警)、规避三大典型坑(直落库、硬编码提示词、无降级)。强调编排决定效果上限。
|
2月前
|
测试技术
场景上线前的验收闸门怎么设-三道检查与灰度放量的节奏
场景上线需设三道闸门:数据闸门验字段与历史覆盖,边界闸门测异常处理能力,灰度闸门控放量节奏。三关全过方可全量推广,确保智能体场景增量可控、问题可溯、回滚有据。