前言
通过阅读本书,大家能建立自己的大数据开发知识体系和图谱,掌握数据开发的各种技术(包括有关概念 原理、架构以及实际的开发和优化技巧等),并能对实际项目中的数据开发提供指导和参考,个人觉得邦中老师的这本书还是有很精彩的,值得一读 ( •̀ ω •́ )✧

接下来,我会从离线数据处理技术、实时数据处理技术、数据开发优化、大数据建模、数据分层体系建设等角度进行总结学习。
数据大图
主要是从数据整体角度,结合数据从采集到消费的四大流程,对相关的数据技术进行介绍和刻画。
数据是原油,数据是生产资料,数据和技术驱动,人类正从 IT 时代走向 DT 时代,数据的战略性日渐得到认可,越来越多的公司、机构和组织,尤其是互联网公司,纷纷搭建了自己的数据平台。
不管是基于开源技术自研、自建还是购买成熟的商业解决方案,不管是在私有的数据中心还是在公有云端,不管是自建团队还是服务外包,一个个数据平台纷纷被搭建,这些数据平台不但物理上承载了所有的数据资产,也成为数据开发工程师、数据分析师、算法工程师、业务分析人员和其他相关数据人员日常的工作平台和环境。
所以说数据平台是一个公司 机构或组织内“看数据”和“用数据”的关键基础设施,已像水电煤一样不可或缺,正是它们的存在才使得数据变现成为可能。
一、数据流程
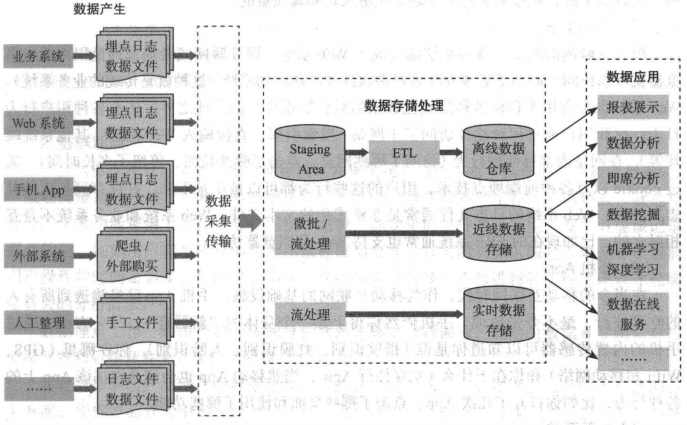
不管是时髦的大数据还是之前传统的数据仓库,不管是目前应用最为广泛的离线数据还是越来越得到重视的实时数据,其端到端流程都包含:数据产生、数据采集和传输、 数据存储处理、数据应用四大过程,具体的数据流程图及其包含的关键环节如图所示。
1.1 数据产生
数据产生是数据平台的源头,根据源头系统的类型不同,我们可以把数据产生的来源分为以下几种。
( 1 )业务系统
业务系统指的是企业核心业务的或者企业内部人员使用的 保证企业正常运转的 IT系统, 比如超市的 POS 销售系统、订单/库存/供应链管理的 ERP 系统、客户关系管理的 CRM 系统、 财务系统 各种行政系统等 不管何种系统,后台的数据一般都存在后台数据库内。
( 2) Web 系统
Web 系统也会有用于存储各种格式化数据的后台数据库,但除此之外,还有各种用户行为日志,比如用户通过何种途径访问了本网站(搜索引擎、直接输入 Web 网址 、其他系统跳转等),在网站内都有何种行为(访问了哪些网页、点击了哪些按钮、停留了多长时间) 。通过 cookie 以及各种前端埋点技术,用户的这些行为都可以被记录下来,并保存到相应的日志文件内。
( 3 )手机 App 、外部系统、人工整理等等
1.2 数据采集和传输
业务系统 Web 系统、手 App 等产生的数据文件、日志文件和埋点日志分散于各个系统与服务器上,必须通过数据采集传输工具和系统的帮助,才能汇总到 个集中的区域进行关联和分析。
我们需要关注这其中的时效性,毫不夸张地说,数据采集传输工具和系统已是大数据时代的关键基础设施。
1.3 数据存储处理
数据采集同步后的数据是原始的和杂乱的,必须经过专门的清洗、关联、规范化和精心的组织建模,而且要通过数据质量检测后才能进行后续的数据分析或用于提供数据服务而这就是数据平台构建的第三个关键关节一一数据存储处理。
这也是数据领域最为激动人心和百花齐放的领域,各种开源技术框架和创新层出不穷,但是万变不离其宗,根据下游数据使用方的时效性,我们可以把数据存储处理工具和技术分为离线处理、近线处理和实时处理,处理后的数据也相应地存储于离线数据仓库、近线数据存储区和实时数据存储区。
离线处理一般按天进行数据处理,每天凌晨等数据采集和同步的数据到位后,相关的数据处理任务会被按照预先设计的 ETL(抽取、转换、加载,一般用来泛指数据清洗、关联、规范化等数据处理过程)逻辑以及 ETL 任务之间的拓扑关系依次调用,最终的数据被写入离线数据仓库中。离线数据仓库中的数据通常是按照某种建模思想(最常用的是维度建模思想)精心组织的,这样既可以使下游用户非常直观和方便地使用,又可以使数据处理过程很方便地扩展和修改。
随着着 Google 关于分布式计算三篇论文的发表和基于此开源的Hadoop 生态系统(分别对应 Google 三篇论文一 HDFS, MapReduce, HBase)兴起,大数据时代真正到来。
现在,大数据时代对于数据的使用已经不限于离线数据的分析,实时数据正变得越来越重要,而这必须借助专业的流计算工具和框架才能实现。目前,最为流行和使用广泛的是 Spark Streaming 和 Flink 。
国内外大厂在使用这些开源框架的同时,还结合自身的使用实践对这些流计算框架从不同层面进行改进和创新,如稳定性、可扩展性、性能等。但是作者认为这其中最具革命性的是 SQL 抽象层的出现,SQL 抽象层使得实时开发用户不必写 Java 或者其他编程语言来开发实时处理逻辑,不但大大加快了实时开发的效率,而且大大降低了实时开发的门槛。
1.4 数据应用
数据的精心埋点、海量离线数据同步和毫秒级的实时数据采集、繁琐的数据处理和精心的数据建模,这些都为数据使用奠定了坚实的基础,但是数据最终发挥价值依赖于数据应用环节。
数据应用最广泛的方式是“看”,比如决策层和管理人员定时查看的公司/部门业务日报、业务周报和业务月报,一线运营人员查看的运营指标和报表,分析师给业务决策和业务运营参考的数据分析报告,还有分析人员和业务人员不定时的即席分析等。
这些数据报表帮助企业管理人员、产品和项目管理人员及一线运营人员定位企业 产品和项目中的问题、隐患和发力方向,并及早采取措施修正方向或者看到正确趋势后加大投入 可以毫不夸张地说,一个企业“看”数据的能力代表了这个企业的数据应用能力水平,也是其核心竞争力之一。
随着大数据时代和人工智能热潮的到来,数据已经不仅局限于“看” Google 的超级搜索框、淘宝的“千人千面”个性化推荐系统、新闻聚合推荐 App 今日 头条都代表着数据和算法结合的成功。也彰显着数据+算法的威力 借助数据挖掘 机器学习算法和深度习算法以及在线数据服务等技术,数据已经成为在线生产系统的一部分。
二、数据技术
主要从数据平台的角度对离线和实时数据平台架构以及相关的各项技术进行介绍。
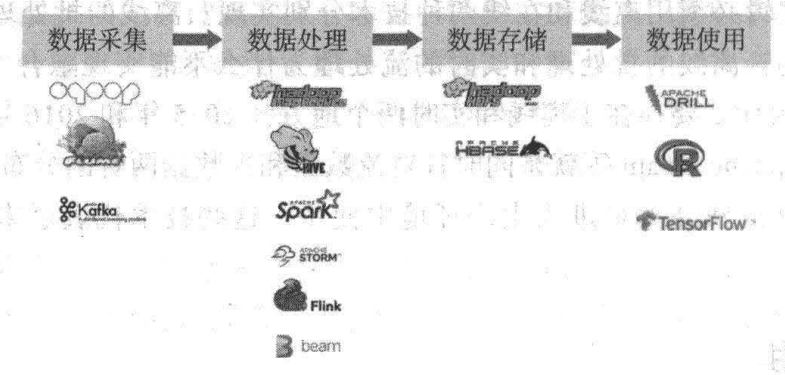
目前大数据相关的技术可以说是蓬勃发展 百花齐放,但是万变不离其宗,不管这些技术如何变化、名词如何新颖,它们都属于前面提到的某个具体流程和环节,还有很多其他的开源技术框架,就不一一赘述。
但正是这些所有的数据技术一起构成了目前大数据的生态系统,各种技术你中有我,我中有你 ,互相借鉴,互相启发。实际上很多技术甚至其基本原理都是类似的,只是由商业的、社区的或者甚至私人的各种原因,它们才独立出来,也许正是这样,才促成了目前大数据整个生态圈的繁荣和欣欣向上,正如一句诗所言:“ 一花独放不是春,万紫千红春满园”。
2.1 数据采集传输主要技术
数据采集传输工具和技术主要分为两大类:离线批处理和实时数据采集和传输。顾名思义,离线批处理主要是批量一次性采集和导出数据。离线批处理目前比较有名和常用的工具是 Sqoop ,下游的用户主要是离线数据处理平台(如 Hive 等)。 实时数据采集和传输最为常用的则是 Flume 和 Kafka ,其下游用户一般是实时流处理平台,如 Storm、Spark、Flink。
( 1 ) Sqoop
Sqoop 作为一款开源的离线数据传输工具,主要用于 Hadoop ( Hive )与传统数据库( MySQL PostgreSQL 等)间的数据传递。
( 2 )Flume
Flume Cloudera 提供的一个高可用、高可靠、分布式的海量日志采集、聚合和传输的系统,目前已经是 Apache 的顶级子项目 使用 Flume 可以收集诸如日志、时间等数据,并将这些数据资源集中存储起来供下游使用(尤其是流处理框架,例如 Storm )。
( 3 ) Kafka
通常来说 Flume 采集数据的速度和下游处理的速度通常不同步,因此实时平台架构都会用一个消息中间件来缓冲,而这方面最为流行和应用最为广泛的无疑是 Kafka 。
Kafka 是由 Linkedln 开发的一个分布式消息系统,以其可以水平扩展和高吞吐率而被广泛使用,目前主流的开源分布式处理系统(如 Storm Spark 等)都支持与 Kafka 集成。
2.2 数据处理主要技术
数据处理是数据开源技术最为百花齐放的领域,离线和准实时的工具主要包括 MapReduce、Hive、Spark ,流处理的工具主要包含 Storm ,还有最近较为火爆的 Flink、Beam。
( 1 ) MapReduce
MapReduce 是 Google 司的核心计算模型,它将运行于大规模集群上的复杂并行计算过程高度抽象为两个函数: map 和 reduce 。MapReduce 最伟大之处在于其将处理大数据能力赋予了普通开发人员,以至于开发人员即使不会任何的分布式编程知识,也能将自己的程序运行在分布式系统上处理海量数据。
( 2) Hive
Hive 是由 Facebook 开发并贡献给 Hadoop 开源社区的,是一个建立在 Hadoop 体系结构上的一层 SQL 抽象。
Hive 目前仍然是包括国际大厂(如 Facebook 国内 BAT )在内的互联网公司所使用的
主流离线数据处理工具。
( 3) Spark
尽管 MapReduce Hive 完成海量数据的大多数批处理工作,并且在大数据时代成为企业大数据处理的首选技术,但是其数据查询的延迟一直被诣病,而且也非常不适合迭代计算和 DAG (有向无环图)计算 。由于 Spark 具有可伸缩、基于内存计算等特点,且可以直接读写 Hadoop 上任何格式的数据,较好地满足了数据即时查询和迭代分析的需求,因此变得越来越流行。
( 4) Flink
在数据处理领域,批处理任务与实时流计算任务一般被认为是两种不同的任务,一个数据项目一般会被设计为只能处理其中一 种任务,例如 Storm 只支持流处理任务,而 MapReduce、Hive 只支持批处理任务。那么两者能够统 用一种技术框架来完成吗?批处理是流处理的特例吗?
Apache Flink 是一个同时面向分布式实时流处理和批量数据处理的开源计算平台,它能够基于同一个 Flink 运行时( Flink Runtime ),提供支持流处理和批处理两种类型应用的功能,Flink 完全支持流处理,批处理被作为一种特殊的流处理,只是它的输入数据流被定义为有界的而已。
2.3 数据存储主要技术
( 1 ) HDFS
Hadoop Distributed File System ,简称 HDFS ,是一个分布式文件系统。它是谷歌的
Google File System ( GFS )提出之后, Doug Cutting 受 Google 启发而开发的一种类 GFS 文件系统 。它有一定高度的容错性,而且提供了高吞吐量的数据访问,非常适合大规模数据集上的应用。 HDFS 提供了一个高容错性和高吞吐量的海量数据存储解决方案。
( 2) HBase
HBase 是一种构建在 HDFS 之上的分布式、面向列族的存储系统。在需要实时读写并随机访问超大规模数据集等场景下, HBase 目前是市场上主流的技术选择。
实际上,传统的数据库解决方案,尤其是关系型数据库也可以通过复制和分区的方法来提高单点性能极限,但这些都是后知后觉的,安装和维护都非常复杂。而 HBase 从另一个角度处理伸缩性问题, 即通过线性方式从下到上增加节点来进行扩展。
HBase 不是关系型数据库,也不支持 SQL ,其中的表一般有这样的特点:
大: 个表可以有上亿行、上百万列
面向列:面向列表(簇)的存储和权限控制,列(簇)独立检索
稀疏:为空(NULL )的列并不占用存储空间,因此表可以设计得非常稀疏
无模式:每一行都有一个可以排序的主键和任意多的列。 列可以根据需要动态增加,表中不同的行可以有截然不同的列
数据多版本: 每个单元中的数据可以有多个版本,默认情况下,版本号自动分配,它是单元格插入时的时间戳
数据类型单一: HBase 中的数据都是字符串,没有类型
2.4 数据应用主要技术
数据有多种应用方式 如固定报表、即时分析、数据服务、数据分析、数据挖掘和机器学习等 。
三、小结
本章主要从整体上对数据进行了概述,包括数据从产生到消费的四大过程 :数据产生、 数据采集和传输、数据存储处理以及数据应用,每一个过程都涉及很多的技术、开源框架、工具和平台。
比如离线的主要数据处理技术是基于 Hadoop MapReduce 的 Hive ,而 Hive 是一种 SQL on Hadoop 的技术,但类似的 SQL on Hadoop 技术和框架还有很多,比如 Cloudera 的 Impala ,Apache Druid 以及 Presto、Shark 等,初学者应该以一种技术为主,辅助了解其他相关的技术,否则容易失去重点 ,从而不知所措。