《Hadoop MapReduce性能优化》一2.2 Hadoop MapReduce性能指标

简介:

本节书摘来异步社区《Hadoop MapReduce性能优化》一书中的第2章,第2.2节,作者: 【法】Khaled Tannir 译者: 范欢动 责编: 杨海玲,更多章节内容可以访问云栖社区“异步社区”公众号查看。

2.2 Hadoop MapReduce性能指标

Hadoop MapReduce性能优化
由于规模以及分布性的原因,诊断Hadoop程序的性能问题和监测Hadoop系统有着特有的难度。尽管Hadoop系统对外公开了原始指标(metric)和日志(log),但这些都难于解释,并不能被很多程序员完全理解。

当前,Hadoop通过日志和指标API报告整体系统的粗略性能指标。但是,缺少了每个作业或者每个任务层面的重要指标,比如磁盘与网络I/O利用情况。在Hadoop系统上运行多个作业时,还缺乏反映每个任务的集群资源利用情况的性能指标。对集群管理员来说,这不仅会给测量集群利用情况带来困难,也不利于正确配置Hadoop系统。

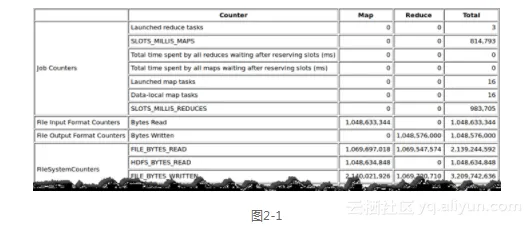
而且,Hadoop产生的日志非常庞大,手工处理极其困难,以至于难以回答诸如“为什么特定数量的mapper/reducer没有达到最优的吞吐量?”这种简单的问题。图2-1所示的截屏反映了某一段Hadoop作业的历史细节。
2

相关文章
|
分布式计算 资源调度 Hadoop
大数据-80 Spark 简要概述 系统架构 部署模式 与Hadoop MapReduce对比
640 2
|
数据采集 分布式计算 Hadoop
使用Hadoop MapReduce进行大规模数据爬取
|
分布式计算 资源调度 Hadoop
Hadoop-10-HDFS集群 Java实现MapReduce WordCount计算 Hadoop序列化 编写Mapper和Reducer和Driver 附带POM 详细代码 图文等内容
510 3
|
分布式计算 资源调度 数据可视化
Hadoop-06-Hadoop集群 历史服务器配置 超详细 执行任务记录 JobHistoryServer MapReduce执行记录 日志聚合结果可视化查看
611 1
|
SQL 分布式计算 关系型数据库
Hadoop-24 Sqoop迁移 MySQL到Hive 与 Hive到MySQL SQL生成数据 HDFS集群 Sqoop import jdbc ETL MapReduce
538 0
|
SQL 分布式计算 关系型数据库
Hadoop-23 Sqoop 数据MySQL到HDFS(部分) SQL生成数据 HDFS集群 Sqoop import jdbc ETL MapReduce
365 0
|
SQL 分布式计算 关系型数据库
Hadoop-22 Sqoop 数据MySQL到HDFS(全量) SQL生成数据 HDFS集群 Sqoop import jdbc ETL MapReduce
461 0
|
分布式计算 Kubernetes Hadoop
大数据-82 Spark 集群模式启动、集群架构、集群管理器 Spark的HelloWorld + Hadoop + HDFS
1307 6
|
存储 分布式计算 Hadoop
从“笨重大象”到“敏捷火花”:Hadoop与Spark的大数据技术进化之路
899 79
|
存储 分布式计算 大数据
Flume+Hadoop:打造你的大数据处理流水线
本文介绍了如何使用Apache Flume采集日志数据并上传至Hadoop分布式文件系统(HDFS)。Flume是一个高可用、可靠的分布式系统,适用于大规模日志数据的采集和传输。文章详细描述了Flume的安装、配置及启动过程,并通过具体示例展示了如何将本地日志数据实时传输到HDFS中。同时,还提供了验证步骤,确保数据成功上传。最后,补充说明了使用文件模式作为channel以避免数据丢失的方法。
1119 4

热门文章

最新文章

相关实验场景

更多