【Druid】(九)E-MapReduce Druid 集群集成 Superset(数据探查与可视化平台 )2

简介: 【Druid】(九)E-MapReduce Druid 集群集成 Superset(数据探查与可视化平台 )2


四、使用Superset


1.登录Superset。


在浏览器地址栏中输入http://emr-header-1:18088,按回车,打开Superset登录界面,默认用户名和密码均为admin,请您登录后及时修改密码。


2.添加E-MapReduce Druid集群。


登录后默认为英文界面,可单击右上角的国旗图标选择合适的语言。接下来在上方菜单栏中依次选择数据源 > Druid 集群来添加一个E-MapReduce Druid集群。


配置好协调机(Coordinator)和代理机(Broker)的地址,注意E-MapReduce中默认端口均为相应的开源端口前加数字1,例如开源Broker 端口为8082,E-MapReduce中为18082。


3.刷新或者添加新数据源。


添加好E-MapReduce Druid集群之后,您可以单击数据源 > 扫描新的数据源,这时E-MapReduce Druid集群上的数据源(datasource)就可以自动被加载进来。


您也可以在界面上单击数据源 > Druid 数据源自定义新的数据源(其操作等同于写一个data source ingestion的json文件),步骤如下。
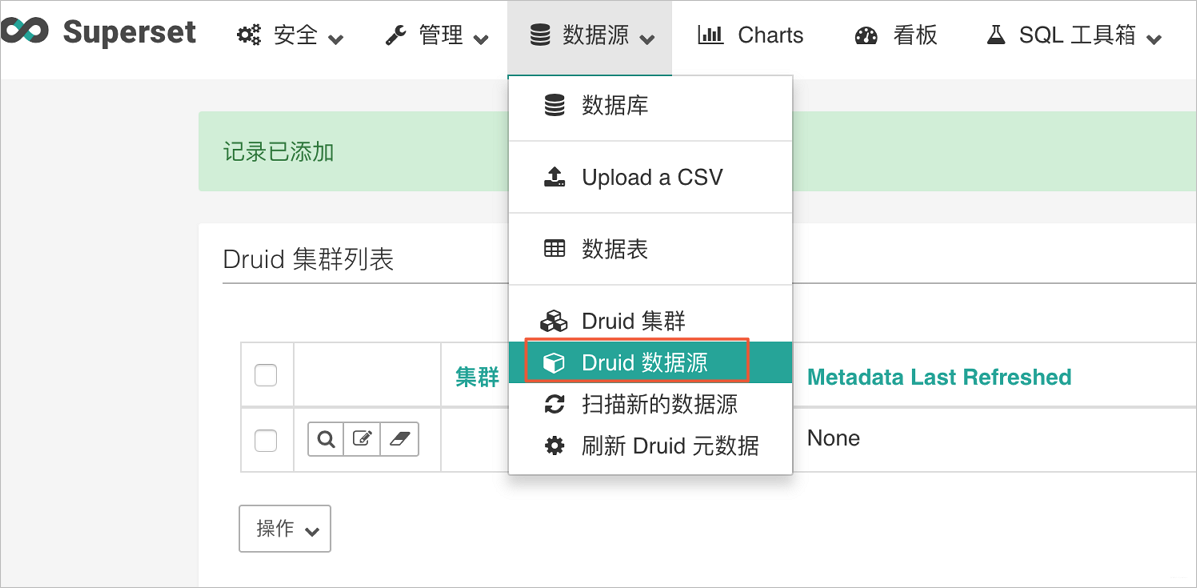


自定义数据源时需要填写必要的信息,然后保存。


保存之后单击左侧set,编辑该数据源,填写相应的维度列与指标列等信息。


4. 查询E-MapReduce Druid。


数据源添加成功后,单击数据源名称,进入查询页面进行查询。


5.(可选)将E-MapReduce Druid作为E-MapReduce Druid数据库使用。


Superset提供了SQLAlchemy以多种方言支持各种各样的数据库,其支持的数据库类型如下表所示。、
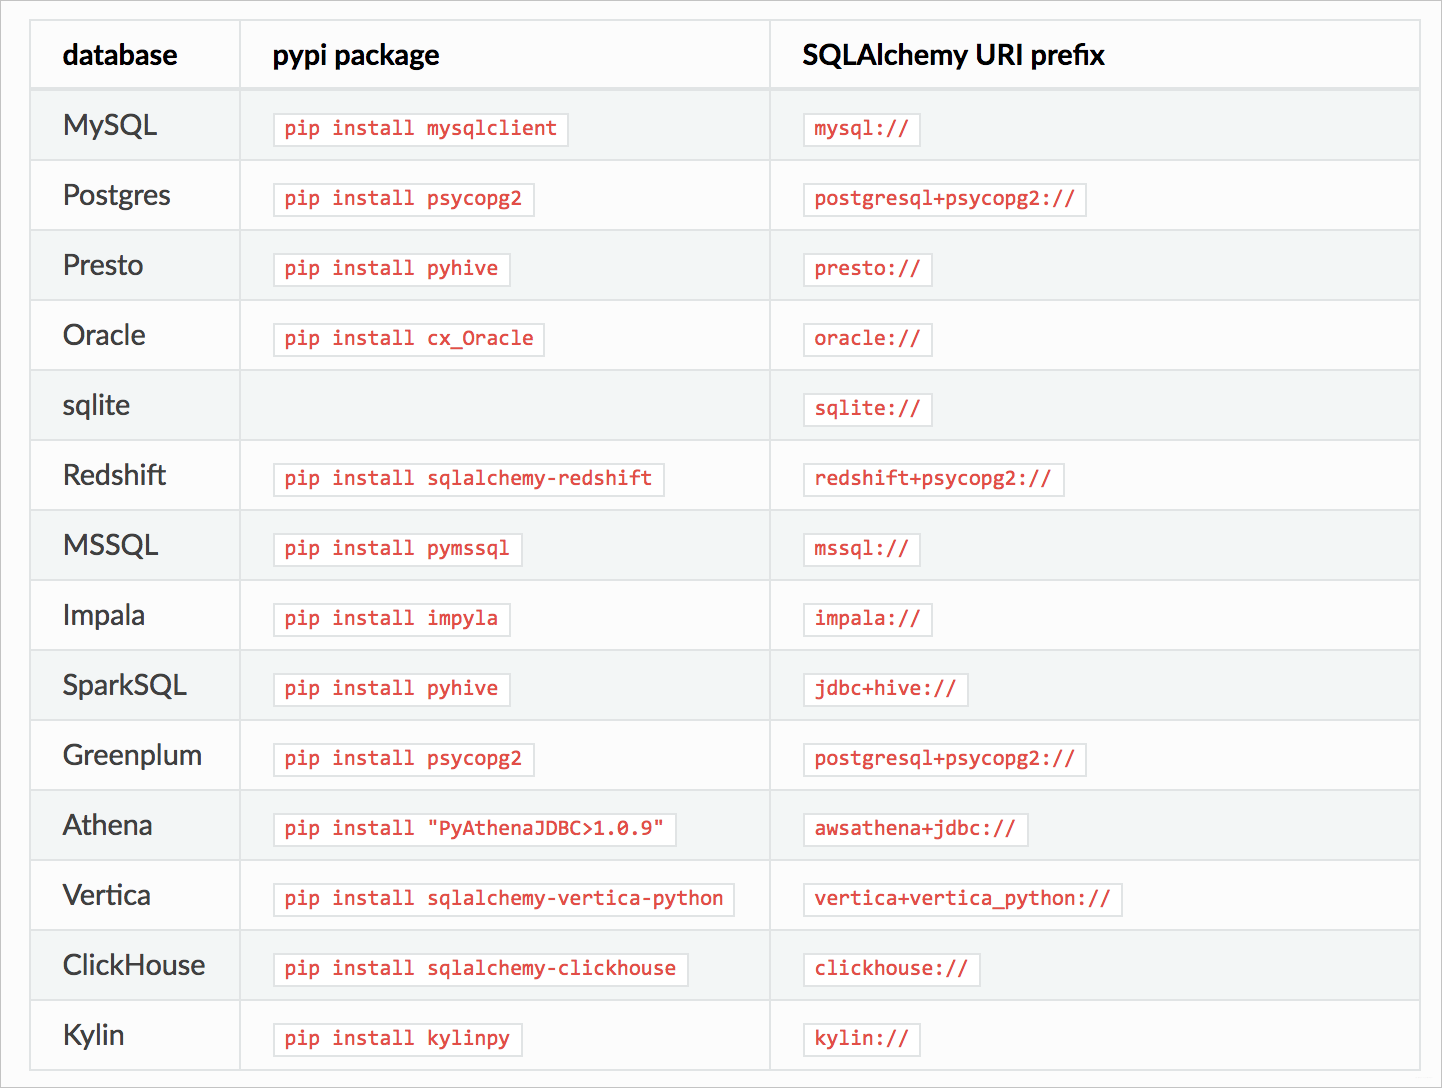


Superset亦支持该方式访问E-MapReduce Druid,E-MapReduce Druid对应的 SQLAlchemy URI为druid://emr-header-1:18082/druid/v2/sql,如下图所示,将E-MapReduce Druid作为一个数据库添加。
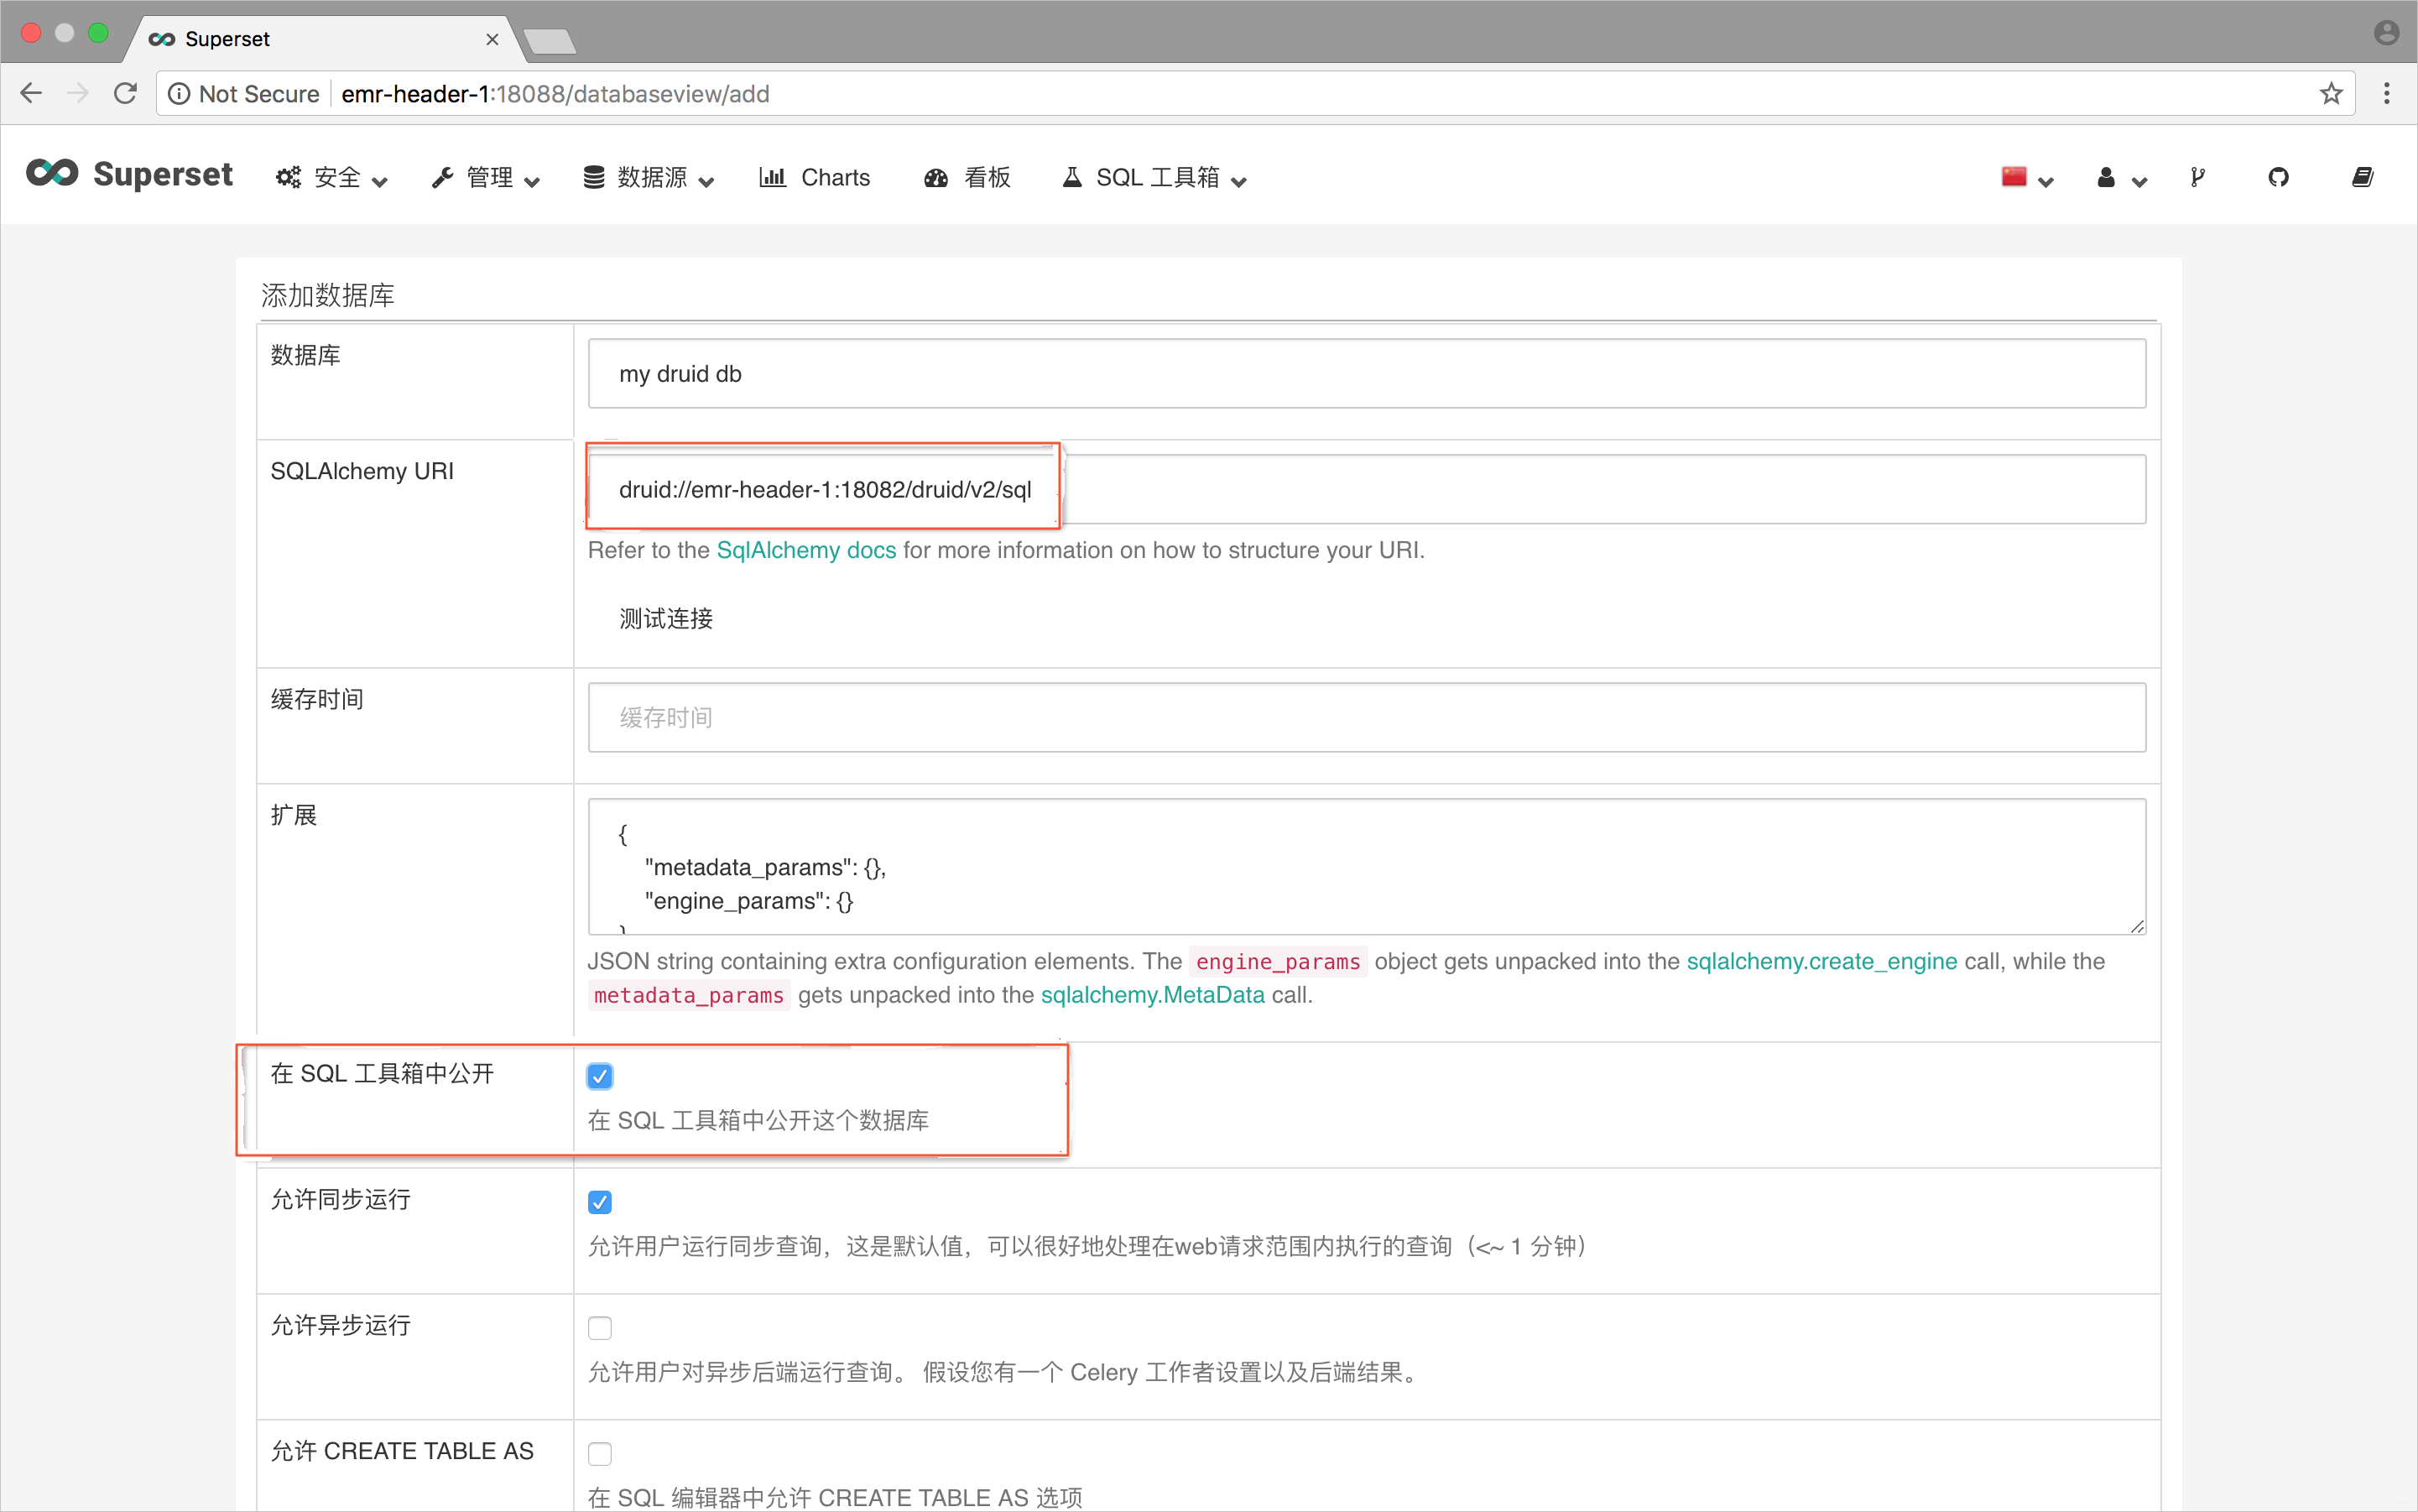


接下来就可以在SQL工具箱里用SQL进行查询了。


目录
相关文章
|
SQL 人工智能 JSON
Flink 2.1 SQL:解锁实时数据与AI集成,实现可扩展流处理
简介:本文整理自阿里云高级技术专家李麟在Flink Forward Asia 2025新加坡站的分享,介绍了Flink 2.1 SQL在实时数据处理与AI融合方面的关键进展,包括AI函数集成、Join优化及未来发展方向,助力构建高效实时AI管道。
1463 43
|
SQL 人工智能 JSON
Flink 2.1 SQL:解锁实时数据与AI集成,实现可扩展流处理
本文整理自阿里云的高级技术专家、Apache Flink PMC 成员李麟老师在 Flink Forward Asia 2025 新加坡[1]站 —— 实时 AI 专场中的分享。将带来关于 Flink 2.1 版本中 SQL 在实时数据处理和 AI 方面进展的话题。
754 0
Flink 2.1 SQL:解锁实时数据与AI集成,实现可扩展流处理
|
SQL 关系型数据库 Apache
从 Flink 到 Doris 的实时数据写入实践 —— 基于 Flink CDC 构建更实时高效的数据集成链路
本文将深入解析 Flink-Doris-Connector 三大典型场景中的设计与实现,并结合 Flink CDC 详细介绍了整库同步的解决方案,助力构建更加高效、稳定的实时数据处理体系。
4196 0
从 Flink 到 Doris 的实时数据写入实践 —— 基于 Flink CDC 构建更实时高效的数据集成链路
|
容灾 安全 关系型数据库
数据传输服务DTS:敏捷弹性构建企业数据容灾和集成
数据传输服务DTS提供全球覆盖、企业级跨境数据传输和智能化服务,助力企业敏捷构建数据容灾与集成。DTS支持35种数据源,实现全球化数据托管与安全传输,帮助企业快速出海并高效运营。瑶池数据库的全球容灾、多活及集成方案,结合DTS的Serverless和Insight功能,大幅提升数据传输效率与智能管理水平。特邀客户稿定分享了使用DTS加速全球业务布局的成功经验,展示DTS在数据分发、容灾多活等方面的优势。
709 0
|
人工智能 安全 Dubbo
Spring AI 智能体通过 MCP 集成本地文件数据
MCP 作为一款开放协议,直接规范了应用程序如何向 LLM 提供上下文。MCP 就像是面向 AI 应用程序的 USB-C 端口,正如 USB-C 提供了一种将设备连接到各种外围设备和配件的标准化方式一样,MCP 提供了一个将 AI 模型连接到不同数据源和工具的标准化方法。
10518 129
|
机器学习/深度学习 SQL 大数据
什么是数据集成?和数据融合有什么区别?
在大数据领域,“数据集成”与“数据融合”常被混淆。数据集成关注数据的物理集中,解决“数据从哪来”的问题;数据融合则侧重逻辑协同,解决“数据怎么用”的问题。两者相辅相成,集成是基础,融合是价值提升的关键。理解其差异,有助于企业释放数据潜力,避免“数据堆积”或“盲目融合”的误区,实现数据从成本到生产力的转变。
什么是数据集成?和数据融合有什么区别?
|
Java 关系型数据库 MySQL
SpringBoot 通过集成 Flink CDC 来实时追踪 MySql 数据变动
通过详细的步骤和示例代码,您可以在 SpringBoot 项目中成功集成 Flink CDC,并实时追踪 MySQL 数据库的变动。
3789 45
|
机器学习/深度学习 PyTorch 测试技术
LossVal:一种集成于损失函数的高效数据价值评估方法
LossVal是一种创新的机器学习方法,通过在损失函数中引入实例级权重,直接在训练过程中评估数据点的重要性,避免了传统方法中反复重训练模型的高计算成本。该方法适用于回归和分类任务,利用最优传输距离优化权重,确保模型更多地从高质量数据中学习。实验表明,LossVal在噪声样本检测和高价值数据点移除等任务上表现优异,具有更低的时间复杂度和更稳定的性能。论文及代码已开源,为数据价值评估提供了高效的新途径。
561 13
LossVal:一种集成于损失函数的高效数据价值评估方法
|
运维 安全 数据管理
Dataphin V5.1 企业级发布:全球数据无缝集成,指标管理全新升级!
企业数据管理难题?Dataphin 5.1版来解决!聚焦跨云数据、研发效率、指标管理和平台运维四大场景,助力数据团队轻松应对挑战。无论是统一指标标准、快速定位问题,还是提升管理安全性,Dataphin都能提供强大支持。3分钟了解新版本亮点,让数据治理更高效!
265 0
|
存储 人工智能 NoSQL
Airweave:快速集成应用数据打造AI知识库的开源平台,支持多源整合和自动同步数据
Airweave 是一个开源工具,能够将应用程序的数据同步到图数据库和向量数据库中,实现智能代理检索。它支持无代码集成、多租户支持和自动同步等功能。
1077 14

热门文章

最新文章