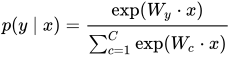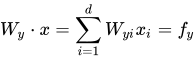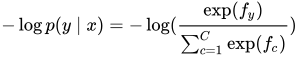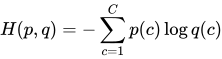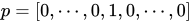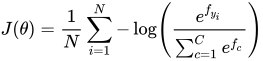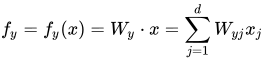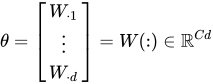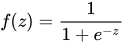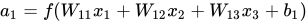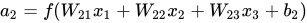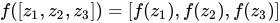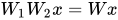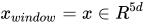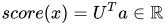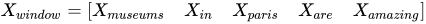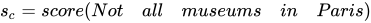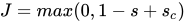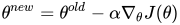斯坦福NLP课程 | 第3讲 - 神经网络知识回顾

简介: NLP课程第3讲主要内容是回顾神经网络知识,并基于NLP场景讲解命名实体识别、基于窗口数据的预测、基于pytorch实现的分类器等。

ShowMeAI研究中心

作者:韩信子@ShowMeAI,路遥@ShowMeAI,奇异果@ShowMeAI
教程地址:http://www.showmeai.tech/tutorials/36
本文地址:http://www.showmeai.tech/article-detail/235
声明:版权所有,转载请联系平台与作者并注明出处

收藏ShowMeAI查看更多精彩内容


神经网络知识回顾
ShowMeAI为斯坦福CS224n《自然语言处理与深度学习(Natural Language Processing with Deep Learning)》课程的全部课件,做了中文翻译和注释,并制作成了GIF动图!

神经网络与反向传播
本讲内容的深度总结教程可以在这里 查看。视频和课件等资料的获取方式见文末。


引言

Word Window Classification, Neural Networks, and PyTorch

CS224n是顶级院校斯坦福出品的深度学习与自然语言处理方向专业课程。核心内容覆盖RNN、LSTM、CNN、transformer、bert、问答、摘要、文本生成、语言模型、阅读理解等前沿内容。

本篇是ShowMeAI对第3课的内容梳理,内容主要是对神经网络知识回顾,会基于NLP的场景做一点结合讲解。

本篇内容覆盖

Word Window Classification, Neural Networks, and PyTorch

  • 神经网络基础
  • 命名实体识别
  • 基于窗口数据的预测
  • 基于pytorch实现的分类器

1. 神经网络基础

1.1 分类问题基础

分类问题基础

对于分类问题,我们有训练数据集:它由一些样本组成

equation?tex=%5C%7Bx_i%2C%20y_i%5C%7D_%7Bi%3D1%7D%5E%7BN%7D

equation?tex=%5C%7Bx_i%2C%20y_i%5C%7D_%7Bi%3D1%7D%5E%7BN%7D

  • equation?tex=x_i 是输入,例如单词(索引或是向量),句子,文档等等(维度为 equation?tex=d )
  • equation?tex=y_i 是我们尝试预测的标签( equation?tex=C 个类别中的一个),例如:

    • 类别:感情,命名实体,购买/售出的决定
    • 其他单词
    • 多词序列(之后会提到)

1.2 分类问题直观理解

分类问题直观理解

训练数据 equation?tex=%5C%7Bx_i%2C%20y_i%5C%7D_%7Bi%3D1%7D%5E%7BN%7D

  • 用一个最简单的2维词向量分类问题作为案例

    • 使用softmax / logistic回归
    • 构建线性决策边界
  • 传统的机器学习/统计学方法:假设 equation?tex=x_i 是固定的,训练 softmax/logistic 回归的权重 equation?tex=W%20%5Cin%20R%5E%7BC%20%5Ctimes%20d%7D 来决定决定边界(超平面)
  • 预测阶段,对每个 equation?tex=x,预测:

equation?tex=p%28y%20%5Cmid%20x%29%3D%5Cfrac%7B%5Cexp%20%28W_y%20%5Ccdot%20x%29%7D%7B%5Csum_%7Bc%3D1%7D%5E%7BC%7D%20%5Cexp%20%28W_c%20%5Ccdot%20x%29%7D

1.3 softmax分类器的细节

softmax分类器的细节

我们可以将预测函数分为两个步骤:

$$1$$. 将 equation?tex=W 的 equation?tex=y%5E%7Bth%7D 行和 equation?tex=x 中的对应行相乘得到分数:

equation?tex=W_%7By%7D%20%5Ccdot%20x%3D%5Csum_%7Bi%3D1%7D%5E%7Bd%7D%20W_%7By%20i%7D%20x_%7Bi%7D%3Df_%7By%7D

- 对 <img src="https://www.zhihu.com/equation?tex=c%3D1%2C%20%5Ccdots%20%2CC">,计算 <img src="https://www.zhihu.com/equation?tex=f_c">

$$2$$. 使用softmax函数获得归一化的概率:
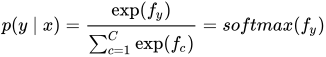
equation?tex=p%28y%20%5Cmid%20x%29%3D%5Cfrac%7B%5Cexp%20%28f_y%29%7D%7B%5Csum_%7Bc%3D1%7D%5E%7BC%7D%20%5Cexp%20%28f_c%29%7D%3Dsoftmax%28f_y%29

1.4 softmax和交叉熵损失

softmax和交叉熵损失

在softmax分类器中最常用到交叉熵损失,也是负对数概率形态。

对于每个训练样本 equation?tex=%28x%2Cy%29,我们的目标是最大化正确类 equation?tex=y 的概率,或者我们可以最小化该类的负对数概率

equation?tex=-%5Clog%20p%28y%20%5Cmid%20x%29%3D-%5Clog%20%28%5Cfrac%7B%5Cexp%28f_y%29%7D%7B%5Csum_%7Bc%3D1%7D%5E%7BC%7D%20%5Cexp%20%28f_c%29%7D%29

使用对数概率将我们的目标函数转换为求和形态,这更容易在推导和应用中使用。

1.5 交叉熵损失理解

交叉熵损失理解

  • 交叉熵的概念来源于信息论,衡量两个分布之间的差异
  • 令真实概率分布为 equation?tex=p,我们计算的模型概率分布为 equation?tex=q
  • 交叉熵为

equation?tex=H%28p%2C%20q%29%3D-%5Csum_%7Bc%3D1%7D%5E%7BC%7D%20p%28c%29%20%5Clog%20q%28c%29

  • 假设标准答案的概率分布是,在正确的类上为 equation?tex=1,在其他类别上为 equation?tex=0 :

equation?tex=p%3D%5B0%2C%20%5Ccdots%20%2C0%2C1%2C0%2C%20%5Ccdots%20%2C0%5D

  • 因为 equation?tex=p 是独热向量,所以唯一剩下的项是真实类的负对数概率。

1.6 完整数据集上的分类

完整数据集上的分类

在整个数据集 equation?tex=%5C%7Bx_i%20%2C%20y_i%20%5C%7D_%7B%28i%3D1%29%7D%5EN 上的交叉熵损失函数,是所有样本的交叉熵的均值

equation?tex=J%28%5Ctheta%29%3D%5Cfrac%7B1%7D%7BN%7D%20%5Csum_%7Bi%3D1%7D%5E%7BN%7D-%5Clog%20%5Cleft%28%5Cfrac%7Be%5E%7Bf_%7By_%7Bi%7D%7D%7D%7D%7B%5Csum_%7Bc%3D1%7D%5E%7BC%7D%20e%5E%7Bf_%7Bc%7D%7D%7D%5Cright%29

不使用 equation?tex=f_y%3Df_y%28x%29%3DW_y%20%5Ccdot%20x%3D%5Csum_%7Bj%3D1%7D%5E%7Bd%7D%20W_%7Byj%7D%20x_j

而是使用向量化的形态,基于矩阵来表示 equation?tex=f%3Af%3DWx

1.7 传统的机器学习优化算法

传统的机器学习优化算法

对于传统的机器学习算法(如逻辑回归)来说,一般机器学习的参数 equation?tex=%5Ctheta 通常只由 equation?tex=W 的列组成

equation?tex=%5Ctheta%3D%5Cleft%5B%5Cbegin%7Barray%7D%7Bc%7D%7BW_%7B%5Ccdot%201%7D%7D%20%5C%5C%20%7B%5Cvdots%7D%20%5C%5C%20%7BW_%7B%5Ccdot%20d%7D%7D%5Cend%7Barray%7D%5Cright%5D%3DW%28%20%3A%29%20%5Cin%20%5Cmathbb%7BR%7D%5E%7BC%20d%7D

因此,我们只通过以下方式更新决策边界

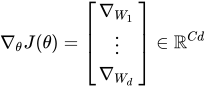
equation?tex=%5Cnabla_%7B%5Ctheta%7D%20J%28%5Ctheta%29%3D%5Cleft%5B%5Cbegin%7Barray%7D%7Bc%7D%7B%5Cnabla_%7BW_%7B1%7D%7D%7D%20%5C%5C%20%7B%5Cvdots%7D%20%5C%5C%20%7B%5Cnabla_%7BW_%7Bd%7D%7D%7D%5Cend%7Barray%7D%5Cright%5D%20%5Cin%20%5Cmathbb%7BR%7D%5E%7BC%20d%7D

1.8 神经网络分类器

神经网络分类器

  • 单独使用线性分类器Softmax( ≈ logistic回归)并不十分强大
  • 如上图所示,Softmax得到的是线性决策边界

    • 对于复杂问题来说,它的表达能力是有限的
    • 有一些分错的点,需要更强的非线性表达能力来区分

1.9 神经网络非线性切分

神经网络非线性切分

  • 神经网络可以学习更复杂的函数和非线性决策边界
  • tip :更高级的分类需要

    • 词向量
    • 更深层次的深层神经网络

1.10 基于词向量的分类差异

基于词向量的分类差异

  • 一般在NLP深度学习中:

    • 我们学习了矩阵 equation?tex=W 和词向量 equation?tex=x。
    • 我们学习传统参数和表示。
    • 词向量是对独热向量的重新表示——在中间层向量空间中移动它们——以便 (线性)softmax分类器可以更好地分类。
  • 即将词向量理解为一层神经网络,输入单词的独热向量并获得单词的词向量表示,并且我们需要对其进行更新。
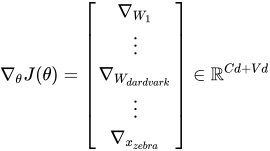
equation?tex=%5Cnabla_%7B%5Ctheta%7D%20J%28%5Ctheta%29%3D%5Cleft%5B%5Cbegin%7Barray%7D%7Bc%7D%7B%5Cnabla_%7BW_%7B1%7D%7D%7D%20%5C%5C%20%7B%5Cvdots%7D%20%5C%5C%20%7B%5Cnabla_%7BW_%7Bd%20a%20r%20d%20v%20a%20r%20k%7D%7D%7D%20%5C%5C%20%7B%5Cvdots%7D%20%5C%5C%20%7B%5Cnabla_%7Bx_%7Bz%20e%20b%20r%20a%7D%7D%7D%5Cend%7Barray%7D%5Cright%5D%20%5Cin%20%5Cmathbb%7BR%7D%5E%7BC%20d%20%2B%20V%20d%7D

  • 其中, equation?tex=Vd 是数量很大的参数。

1.11 神经计算

神经计算

  • An artificial neuron

    • 神经网络有自己的术语包
    • 但如果你了解 softmax 模型是如何工作的,那么你就可以很容易地理解神经元的操作
  • Neural computation:神经计算
  • Neural selectivity:神经选择性
  • Hierarchy of neural processing:神经处理层次

1.12 单个神经元:可视作二元逻辑回归单元

单个神经元:可视作二元逻辑回归单元

equation?tex=h_%7Bw%2C%20b%7D%28x%29%3Df%28w%5E%7BT%7Dx%2Bb%29equation?tex=f%28z%29%3D%5Cfrac%7B1%7D%7B1%2Be%5E%7B-z%7D%7D

  • equation?tex=b :我们可以有一个“总是打开”的特性,它给出一个先验类,或者将它作为一个偏向项分离出来。
  • equation?tex=w , equation?tex=b 是神经元的参数。

1.13 一个神经网络:多个逻辑回归组合

一个神经网络:多个逻辑回归组合

  • 如果我们输入一个向量通过一系列逻辑回归函数,那么我们得到一个输出向量。
  • 但是我们不需要提前决定这些逻辑回归试图预测的变量是什么。


一个神经网络:多个逻辑回归组合

  • 我们可以输入另一个logistic回归函数。
  • 损失函数将指导中间隐藏变量应该是什么,以便更好地预测下一层的目标。


一个神经网络:多个逻辑回归组合

我们添加更多层的神经网络,就得到了多层感知器。

1.14 单层神经网络的矩阵形态表示

单层神经网络的矩阵形态表示

equation?tex=a_%7B1%7D%3Df%28W_%7B11%7D%20x_%7B1%7D%2BW_%7B12%7D%20x_%7B2%7D%2BW_%7B13%7D%20x_%7B3%7D%2Bb_%7B1%7D%29

equation?tex=a_%7B2%7D%3Df%28W_%7B21%7D%20x_%7B1%7D%2BW_%7B22%7D%20x_%7B2%7D%2BW_%7B23%7D%20x_%7B3%7D%2Bb_%7B2%7D%29

equation?tex=z%3DWx%2Bb

equation?tex=a%3Df%28z%29

equation?tex=f%28%5Bz_%7B1%7D%2C%20z_%7B2%7D%2C%20z_%7B3%7D%5D%29%3D%5Bf%28z_%7B1%7D%29%2C%20f%28z_%7B2%7D%29%2C%20f%28z_%7B3%7D%29%5D

  • equation?tex=f%28x%29 在运算时是 element-wise 逐元素的

1.15 非线性变换的必要性

非线性变换的必要性

  • 例如:函数近似,如回归或分类

    • 没有非线性,深度神经网络只能做线性变换
    • 多个线性变换,也还是组成一个线性变换 equation?tex=W_1%20W_2%20x%3DWx
  • 因为线性变换是以某种方式旋转和拉伸空间,多次的旋转和拉伸可以融合为一次线性变换
  • 对于非线性函数而言,使用更多的层,他们可以近似更复杂的函数

2.命名实体识别

2.1 命名实体识别(NER)

命名实体识别(NER)

  • 可能的用途

    • 跟踪文档中提到的特定实体(组织、个人、地点、歌曲名、电影名等)
    • 对于问题回答,答案通常是命名实体
    • 许多需要的信息实际上是命名实体之间的关联
    • 同样的技术可以扩展到其他 slot-filling 槽填充分类
  • 通常后面是命名实体链接/规范化到知识库

2.2 句子中的命名实体识别

句子中的命名实体识别

我们通过在上下文中对单词进行分类,然后将实体提取为单词子序列来预测实体。

2.3 NER的难点

NER的难点

  • 很难计算出实体的边界

    • 第一个实体是 “First National Bank” 还是 “National Bank”
  • 很难知道某物是否是一个实体

    • 是一所名为“Future School” 的学校,还是这是一所未来的学校?
  • 很难知道未知/新奇实体的类别

    • “Zig Ziglar” ? 一个人
  • 实体类是模糊的,依赖于上下文

    • 这里的“Charles Schwab” 是 PER 不是 ORG

3.基于窗口数据的分类预测

3.1. 词-窗分类

词-窗分类

  • 思路:为在上下文中的语言构建分类器

    • 一般来说,很少对单个单词进行分类
  • 例如,上下文中一个单词的命名实体分类

    • 人、地点、组织、没有
  • 在上下文中对单词进行分类的一个简单方法,可能是对窗口中的单词向量进行平均,并对平均向量进行分类

    • 问题:这会丢失位置信息

3.2 窗口分类器:softmax

窗口分类器:softmax

  • 训练softmax分类器对中心词进行分类,方法是在一个窗口内将中心词周围的词向量串联起来
  • 例子:在这句话的上下文中对“Paris”进行分类,窗口长度为2
  • 结果向量 equation?tex=x_%7Bwindow%7D%3Dx%20%5Cin%20R%5E%7B5d%7D 是一个列向量

3.3 最简单的窗口分类器:Softmax

最简单的窗口分类器:Softmax

对于 equation?tex=x%3Dx_%7Bwindow%7D,我们可以使用与之前相同的softmax分类器

如何更新向量?

  • 简而言之:就像之前讲的那样,求导和优化

3.4 稍微复杂一点:多层感知器

稍微复杂一点:多层感知器

  • 假设我们要对中心词是否为一个地点,进行分类
  • 与word2vec类似,我们将遍历语料库中的所有位置。但这一次,它将受到监督,只有一些位置能够得到高分。

    • 例如,在他们的中心有一个实际的NER Location的位置是“真实的”位置会获得高分

3.5 神经网络前馈计算

神经网络前馈计算

使用神经激活 equation?tex=a 简单地给出一个非标准化的分数

equation?tex=score%28x%29%3DU%5E%7BT%7D%20a%20%5Cin%20%5Cmathbb%7BR%7D

我们用一个三层神经网络计算一个窗口的得分

s = score("museums in Paris are amazing”)

  • equation?tex=x%20%5Cin%20%5Cmathbb%7BR%7D%5E%7B20%20%5Ctimes%201%7D
  • equation?tex=W%20%5Cin%20%5Cmathbb%7BR%7D%5E%7B8%20%5Ctimes%2020%7D
  • equation?tex=U%20%5Cin%20%5Cmathbb%7BR%7D%5E%7B8%20%5Ctimes%201%7D

之前的例子

equation?tex=X_%7Bwindow%7D%20%3D%20%5BX_%7Bmuseums%7D%20%5Cquad%20X_%7Bin%7D%20%5Cquad%20X_%7Bparis%7D%20%5Cquad%20X_%7Bare%7D%20%5Cquad%20X_%7Bamazing%7D%5D

3.6 附加层

附加层

中间层学习输入词向量之间的非线性交互

equation?tex=X_%7Bwindow%7D%20%3D%20%5BX_%7Bmuseums%7D%20%5Cquad%20X_%7Bin%7D%20%5Cquad%20X_%7Bparis%7D%20%5Cquad%20X_%7Bare%7D%20%5Cquad%20X_%7Bamazing%7D%5D

例如:只有当“museum”是第一个向量时,“in”放在第二个位置才重要

4.基于pytorch实现的分类器

4.1 使用合页损失替换

使用合页损失替换


使用合页损失替换

关于训练目标的想法:让真实窗口的得分更高,而其他窗口的得分更低(直到足够好为止)
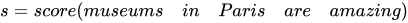
equation?tex=s%20%3D%20score%28museums%20%5Cquad%20in%20%5Cquad%20Paris%20%5Cquad%20are%20%5Cquad%20amazing%29

equation?tex=s_c%20%3D%20score%28Not%20%5Cquad%20all%20%5Cquad%20museums%20%5Cquad%20in%20%5Cquad%20Paris%29

最小化:

equation?tex=J%3Dmax%280%2C1-s%2Bs_c%29

这是不可微的,但它是连续的 → 我们可以用SGD

补充解析

  • 单窗口的目标函数为 equation?tex=J%3Dmax%280%2C1-s%2Bs_c%29
  • 每个中心有NER位置的窗口的得分应该比中心没有位置的窗口高1分
  • 要获得完整的目标函数:为每个真窗口采样几个损坏的窗口。对所有训练样本窗口求和
  • 类似于word2vec中的负抽样

4.2 随机梯度下降

随机梯度下降使用SGD更新参数

equation?tex=%5Ctheta%20%5E%7Bnew%7D%3D%20%5Ctheta%20%5E%7Bold%7D-%5Calpha%20%5Cnabla_%7B%5Ctheta%7D%20J%28%5Ctheta%29

  • equation?tex=%5Calpha 是步长或是学习率

4.3 课堂手推

Gradients,Jacobian Matrix: Generalization of the Gradient

Chain Rule,Example Jacobian: Elementwise activation Function

Other Jacobians,Back to our Neural Net!,Break up equations into simple pieces

Apply the chain rule

Derivative with respect to Matrix: Output shape,Derivative with respect to Matrix

Why the Transposes?,What shape should derivatives be?

反向传播

5.视频教程

可以点击 B站 查看视频的【双语字幕】版本

6.参考资料

ShowMeAI 系列教程推荐

自然语言处理(NLP)系列教程

斯坦福 CS224n 课程带学详解

ShowMeAI用知识加速每一次技术成长

目录
相关文章
|
机器学习/深度学习 自然语言处理 数据可视化
基于图神经网络的自然语言处理:融合LangGraph与大型概念模型的情感分析实践
本文探讨了在企业数字化转型中,大型概念模型(LCMs)与图神经网络结合处理非结构化文本数据的技术方案。LCMs突破传统词汇级处理局限,以概念级语义理解为核心,增强情感分析、实体识别和主题建模能力。通过构建基于LangGraph的混合符号-语义处理管道,整合符号方法的结构化优势与语义方法的理解深度,实现精准的文本分析。具体应用中,该架构通过预处理、图构建、嵌入生成及GNN推理等模块,完成客户反馈的情感分类与主题聚类。最终,LangGraph工作流编排确保各模块高效协作,为企业提供可解释性强、业务价值高的分析结果。此技术融合为挖掘非结构化数据价值、支持数据驱动决策提供了创新路径。
949 6
基于图神经网络的自然语言处理:融合LangGraph与大型概念模型的情感分析实践
基于python的网络课程在线学习交流系统
本研究聚焦网络课程在线学习交流系统,从社会、技术、教育三方面探讨其发展背景与意义。系统借助Java、Spring Boot、MySQL、Vue等技术实现,融合云计算、大数据与人工智能,推动教育公平与教学模式创新,具有重要理论价值与实践意义。
|
机器学习/深度学习 自然语言处理 算法
【从零开始学习深度学习】49.Pytorch_NLP项目实战:文本情感分类---使用循环神经网络RNN
|
机器学习/深度学习 人工智能 自然语言处理
7.1 NLP经典神经网络 RNN LSTM
该文章介绍了自然语言处理中的情感分析任务,探讨了如何使用深度神经网络,特别是循环神经网络(RNN)和长短时记忆网络(LSTM),来处理和分析文本数据中的复杂情感倾向。
|
机器学习/深度学习 算法 PyTorch
【从零开始学习深度学习】50.Pytorch_NLP项目实战:卷积神经网络textCNN在文本情感分类的运用
|
SQL 监控 安全
网络安全与信息安全:漏洞、加密与安全意识
随着互联网的迅猛发展,网络安全和信息安全问题日益受到关注。本文深入探讨了网络安全漏洞、加密技术以及提高个人和组织的安全意识的重要性。通过分析常见的网络攻击手段如缓冲区溢出、SQL注入等,揭示了计算机系统中存在的缺陷及其潜在威胁。同时,详细介绍了对称加密和非对称加密算法的原理及应用场景,强调了数字签名和数字证书在验证信息完整性中的关键作用。此外,还讨论了培养良好上网习惯、定期备份数据等提升安全意识的方法,旨在帮助读者更好地理解和应对复杂的网络安全挑战。
|
SQL 安全 网络安全
网络安全与信息安全:知识分享####
【10月更文挑战第21天】 随着数字化时代的快速发展,网络安全和信息安全已成为个人和企业不可忽视的关键问题。本文将探讨网络安全漏洞、加密技术以及安全意识的重要性,并提供一些实用的建议,帮助读者提高自身的网络安全防护能力。 ####
735 17
|
SQL 安全 网络安全
网络安全与信息安全:关于网络安全漏洞、加密技术、安全意识等方面的知识分享
随着互联网的普及,网络安全问题日益突出。本文将从网络安全漏洞、加密技术和安全意识三个方面进行探讨,旨在提高读者对网络安全的认识和防范能力。通过分析常见的网络安全漏洞,介绍加密技术的基本原理和应用,以及强调安全意识的重要性,帮助读者更好地保护自己的网络信息安全。
543 10
|
SQL 安全 网络安全
网络安全与信息安全:关于网络安全漏洞、加密技术、安全意识等方面的知识分享
在数字化时代,网络安全和信息安全已成为我们生活中不可或缺的一部分。本文将介绍网络安全漏洞、加密技术和安全意识等方面的内容,并提供一些实用的代码示例。通过阅读本文,您将了解到如何保护自己的网络安全,以及如何提高自己的信息安全意识。
494 10
|
存储 SQL 安全
网络安全与信息安全:关于网络安全漏洞、加密技术、安全意识等方面的知识分享
随着互联网的普及,网络安全问题日益突出。本文将介绍网络安全的重要性,分析常见的网络安全漏洞及其危害,探讨加密技术在保障网络安全中的作用,并强调提高安全意识的必要性。通过本文的学习,读者将了解网络安全的基本概念和应对策略,提升个人和组织的网络安全防护能力。

热门文章

最新文章