《深入浅出DPDK》—第1章1.3节解读数据包处理能力

简介: 不管什么样的硬件平台,对于包处理都有最基本的性能诉求。一般常被提到的有吞吐、延迟、丢包率、抖动等。对于转发,常会以包转发率(pps,每秒包转发率)而不是比特率(bit/s,每秒比特转发率)来衡量转发能力,这跟包在网络中传输的方式有关。

本节书摘来自华章出版社《深入浅出DPDK》一书中的第1章,第1.3节解读数据包处理能力,作者朱河清,梁存铭,胡雪焜,曹水 等,更多章节内容可以访问云栖社区“华章计算机”公众号查看。

1.3 解读数据包处理能力
不管什么样的硬件平台,对于包处理都有最基本的性能诉求。一般常被提到的有吞吐、延迟、丢包率、抖动等。对于转发,常会以包转发率(pps,每秒包转发率)而不是比特率(bit/s,每秒比特转发率)来衡量转发能力,这跟包在网络中传输的方式有关。不同大小的包对存储转发的能力要求不尽相同。让我们先来温习一下有效带宽和包转发率概念。
线速(Wire Speed)是线缆中流过的帧理论上支持的最大帧数。
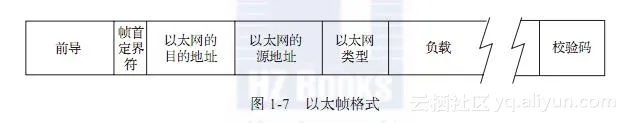
我们用以太网(Ethernet)为例,一般所说的接口带宽,1Gbit/s、10Gbit/s、25Gbit/s、40Gbit/s、100Gbit/s,代表以太接口线路上所能承载的最高传输比特率,其单位是bit/s(bit per second,位/秒)。实际上,不可能每个比特都传输有效数据。以太网每个帧之间会有帧间距(Inter-Packet Gap,IPG),默认帧间距大小为12字节。每个帧还有7个字节的前导(Preamble),和1个字节的帧首定界符(Start Frame Delimiter,SFD)。具体帧格式如图1-7所示,有效内容主要是以太网的目的地址、源地址、以太网类型、负载。报文尾部是校验码。

88048cfab7fc1e5f13f5ef839e915167f5c62150

所以,通常意义上的满速带宽能跑有效数据的吞吐可以由如下公式得到理论帧转发率:
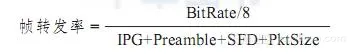
91336338b93c3c730ca799fcdae0e4f071466ae5

而这个最大理论帧转发率的倒数表示了线速情况下先后两个包到达的时间间隔。
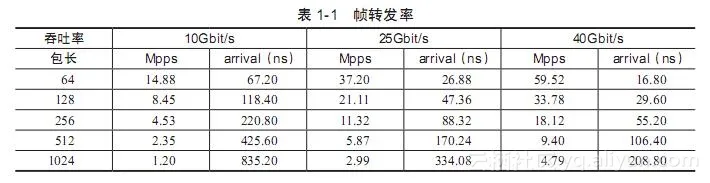
按照这个公式,将不同包长按照特定的速率计算可得到一个以太帧转发率,如表1-1所示。如果仔细观察,可以发现在相同带宽速率下,包长越小的包,转发率越高,帧间延迟也越小。
271183dcdcaccda70ab2b311643d75ad70b58c3f

满足什么条件才能达到无阻塞转发的理论上限呢?如果我们把处理一个数据包的整个生命周期看做是工厂的生产流水线,那么就要保证在这个流水线上,不能有任何一级流水处理的延迟超过此时间间隔。理解了这一点,对照表1-1,就很容易发现,对任何一个数据包处理流水线来说,越小的数据包,挑战总是越大。这样的红线对任何一个硬件平台,对任何一个在硬件平台上设计整体流水线的设计师来说都是无法逃避并需要积极面对的。

相关文章
|
移动开发 监控 小程序
钉钉工作台开放能力建设阶段性总结
工作台的平台化开放能力建设已经走了近3年的时间,包括定制工作台的开放、工作台模板的开放、工作台组件的开放等等。本文主要是对过程中一些关键能力的总结和思考,欢迎交流。工作台的类型工作台作为企业业务数字化的统一门户,是组织用于提升管理效率、实现业务在线的平台。工作台的组织就是钉钉上的组织,针对不同的组织规模,提供了多种类型工作台:角色工作台、行业工作台和自定义工作台。角色工作台是对不同的角色,例如财务
1804 0
钉钉工作台开放能力建设阶段性总结
|
安全 Shell Linux
【Shell 命令集合 系统管理 】⭐⭐⭐Linux 重启 reboot命令 使用指南
1911 0
|
SQL 分布式计算 HIVE
pyspark笔记(RDD,DataFrame和Spark SQL)1
pyspark笔记(RDD,DataFrame和Spark SQL)
675 1
|
6月前
|
人工智能 自然语言处理 安全
OpenClaw与QQ深度集成:打造智能对话机器人的全链路实践指南
本文以OpenClaw与QQ机器人集成为例,详解AI服务嵌入即时通讯的落地路径:涵盖轻量服务器一键部署、动态端口安全加固、双模式API计费配置、QQ通道对接及闭环验证方法,提供可复用的智能对话系统构建范式。
544 1
|
程序员 数据处理 Go
Python 3.14发布:多解释器让性能飙升300%,GIL时代即将终结!
程序员晚枫实测Python 3.14多解释器,突破GIL限制,性能提升287%!CPU利用率拉满,数据处理、科学计算迎来并发新时代。新特性实操分享,助力开发者高效编程。
641 18
|
11月前
|
人工智能 移动开发 自然语言处理
2025 AI 数字人应用典型案例 TOP5:多场景实战范本与价值解析
AI数字人迈向规模化应用,2025年落地政务、国企、文旅、医疗、职教五大领域。世优波塔五大案例展现跨行业实践:北京丰台智慧政务、陕建集团智能供应链、伊犁将军府沉浸导览、南阳医院智慧导诊、天津轻工“鲁班工坊”多语接待,构建可复制的数字化转型新范式。
1489 0
2025 AI 数字人应用典型案例 TOP5:多场景实战范本与价值解析
|
数据采集 人工智能 搜索推荐
完蛋啦,爆火Github项目,用微信聊天记录打造专属AI数字分身,我都不敢相信!!
WeClone 是一个基于微信或 Telegram 聊天记录微调大语言模型的开源项目,可打造专属 AI 数字分身。支持文本、图片等多模态数据,具备语言风格迁移和语音克隆功能,实现“说话像你”的AI角色。项目提供完整训练流程,支持本地部署,保护隐私,适用于个人数字分身、纪念机器人、客服助手等场景。
2467 0
|
存储 JSON 数据格式
什么情况,一夜之间冲上热搜,狂揽29.6k星,再见吧SQLite!这个嵌入式分析引擎实在太香了
DuckDB是一款嵌入式OLAP数据库,专为高效分析型查询设计,被誉为“分析型SQLite”。它采用列式存储和向量化查询引擎,显著提升分析任务性能。无需独立服务器,支持Python、R、Java等语言,安装简单,5分钟即可上手。DuckDB可直接查询CSV、JSON、Parquet文件,支持Pandas零拷贝交互,优化SQL语法简化复杂查询。适用于探索性数据分析、数据湖ETL流水线及边缘设备实时分析等场景,是数据科学家和开发者的理想工具。项目地址:https://github.com/duckdb/duckdb
1682 4
|
消息中间件 存储 NoSQL
MQ的顺序性保证:顺序队列、消息编号、分布式锁,一文全掌握!
【8月更文挑战第24天】消息队列(MQ)是分布式系统的关键组件,用于实现系统解耦、提升可扩展性和可用性。保证消息顺序性是其重要挑战之一。本文介绍三种常用策略:顺序队列、消息编号与分布式锁,通过示例展示如何确保消息按需排序。这些方法各有优势,可根据实际场景灵活选用。提供的Java示例有助于加深理解与实践应用。
1366 2
|
算法 数据挖掘 Shell
「毅硕|生信教程」 micromamba:mamba的C++实现,超越conda
还在为生信软件的安装配置而烦恼?micromamba(micromamba是mamba包管理器的小型版本,采用C++实现,具有mamba的核心功能,且体积更小,可以脱离conda独立运行,更易于部署)帮你解决!
1087 1