需求:从中国天气网爬取北京近七天的天气状况。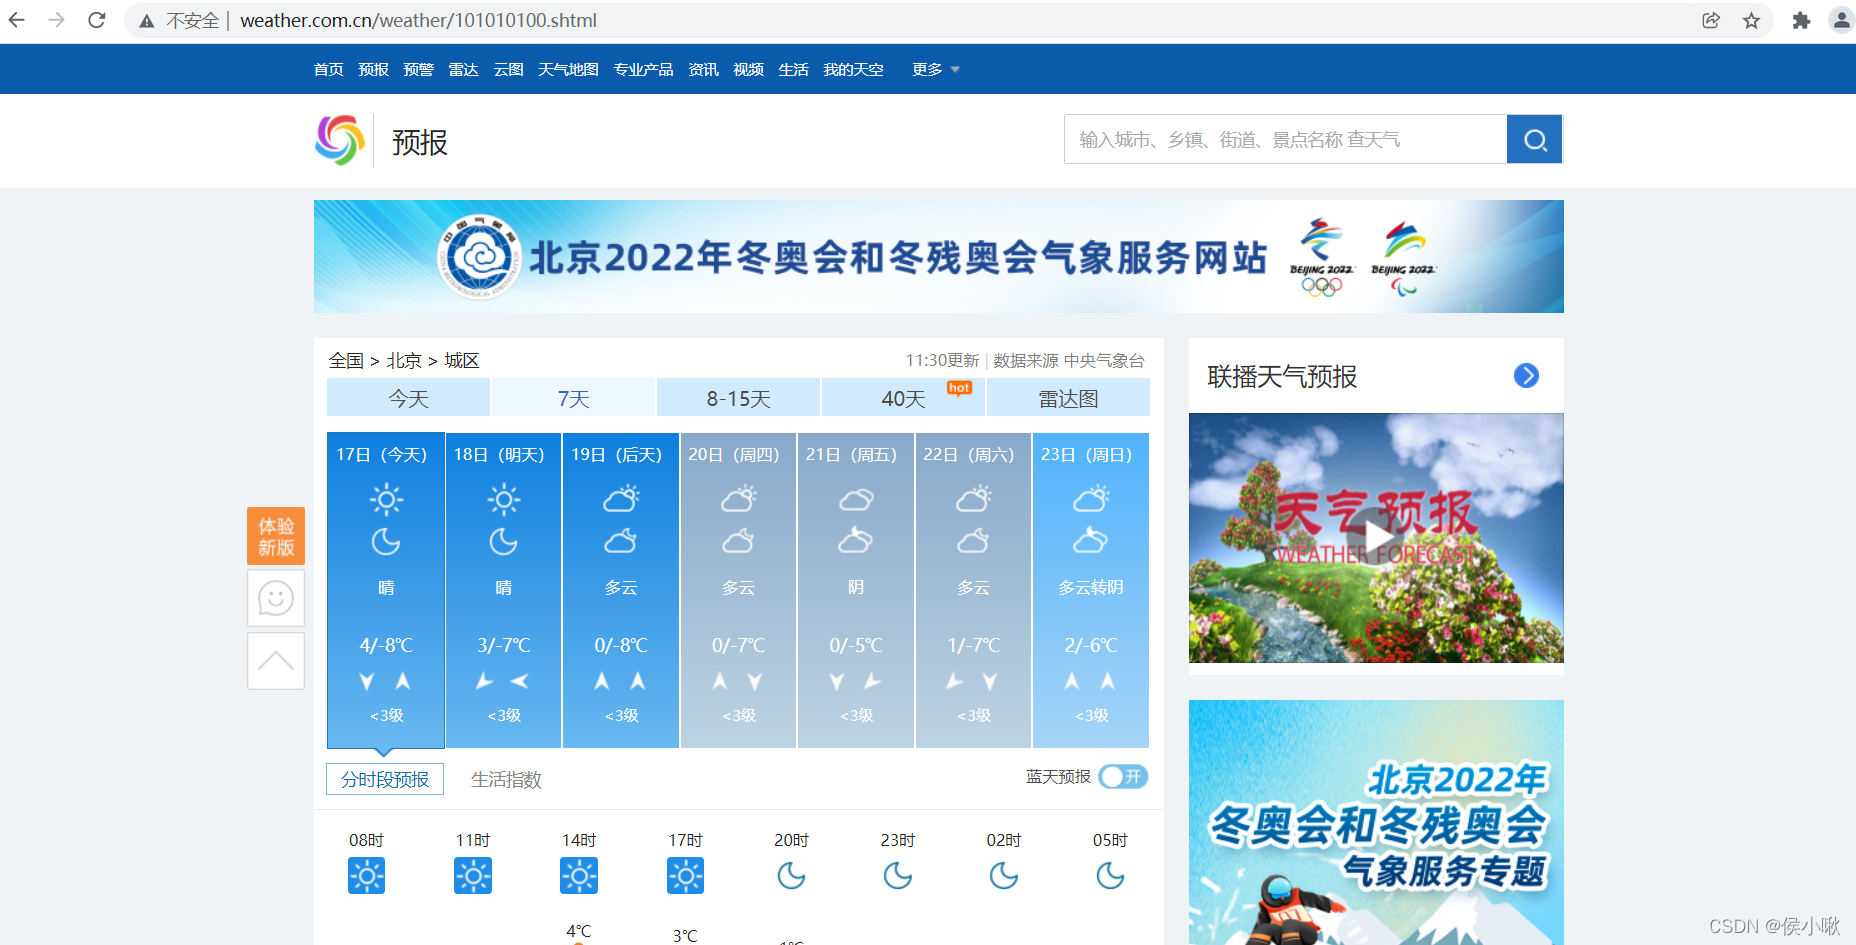
首先要进行网页分析
如图可以看到北京最近7天天气,明天为晴,温度为-7℃到3℃,风力为<3级。
查看网页源码,发现可以从中找到这一数据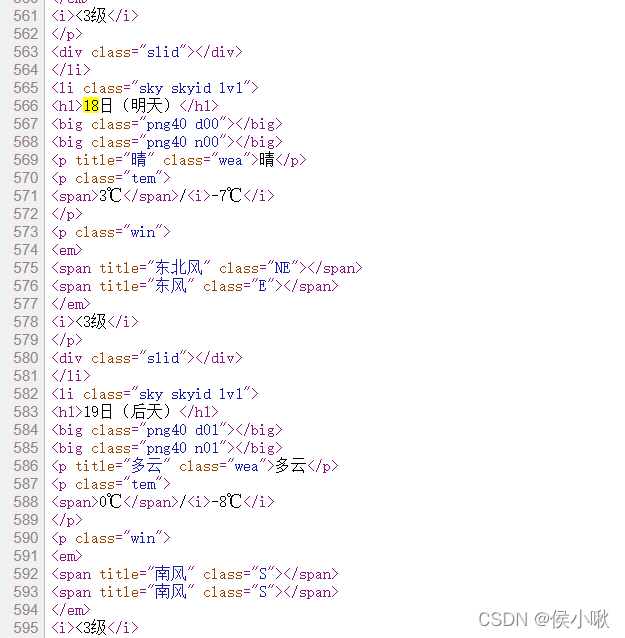
于是可以确定,此网页上方的url
http://www.weather.com.cn/weather/101010100.shtml
即为我们要访问的目标url。
然后对该url发起请求。并对得到的源码进行解析。
def get_Source(self):
    url = "http://www.weather.com.cn/weather/101180101.shtml"
    headers = {

            'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/96.0.4664.45 Safari/537.36',
       }
    response = requests.get(url, headers=headers)
    return response.content.decode('utf-8')

content = self.get_Source()
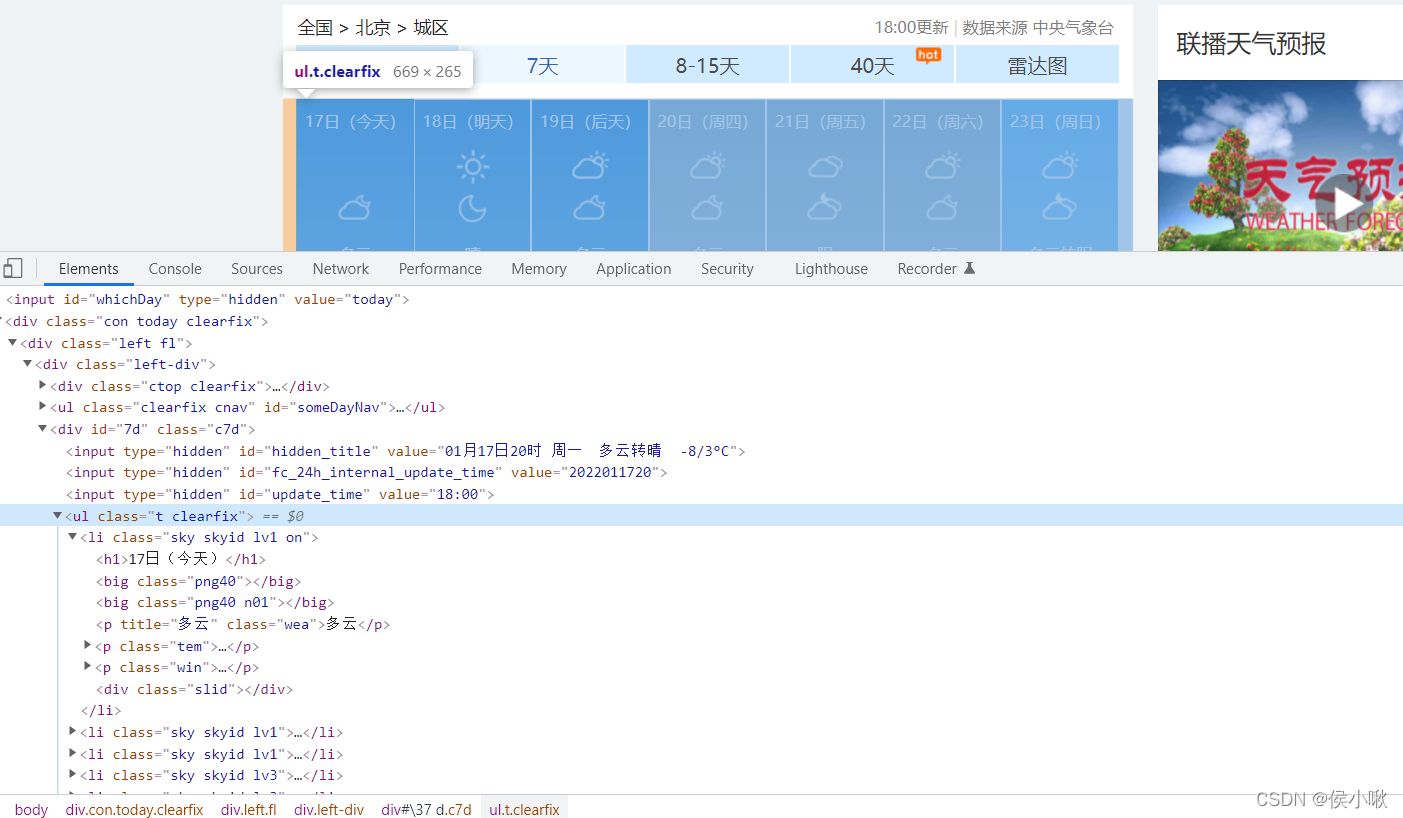
如图可以看出,需要的数据在
- 与
则正则表达式写为:
result = re.match(r'.*?(<ul class="t clearfix">.*?</ul>).*?', content, re.S)
ul = result.group(1)
re.S必须要有,表示使用点(.)字符匹配时匹配所有字符,包括换行符。没有的这个参数话则只会从第一行中匹配。
与括号内匹配的内容,是我们需要的内容。也是该行代码返回的内容。
取出<ul>后,可以看出七天的天气分别分布在7个<li>标签里。遂使用findall()方法将其全部取出。
写正则表达式:
lis = re.findall(r'<li.*?>.*?</li>', ul, re.S)
for li in lis:
    print('-'*100)
    print(li)
输出结果如下: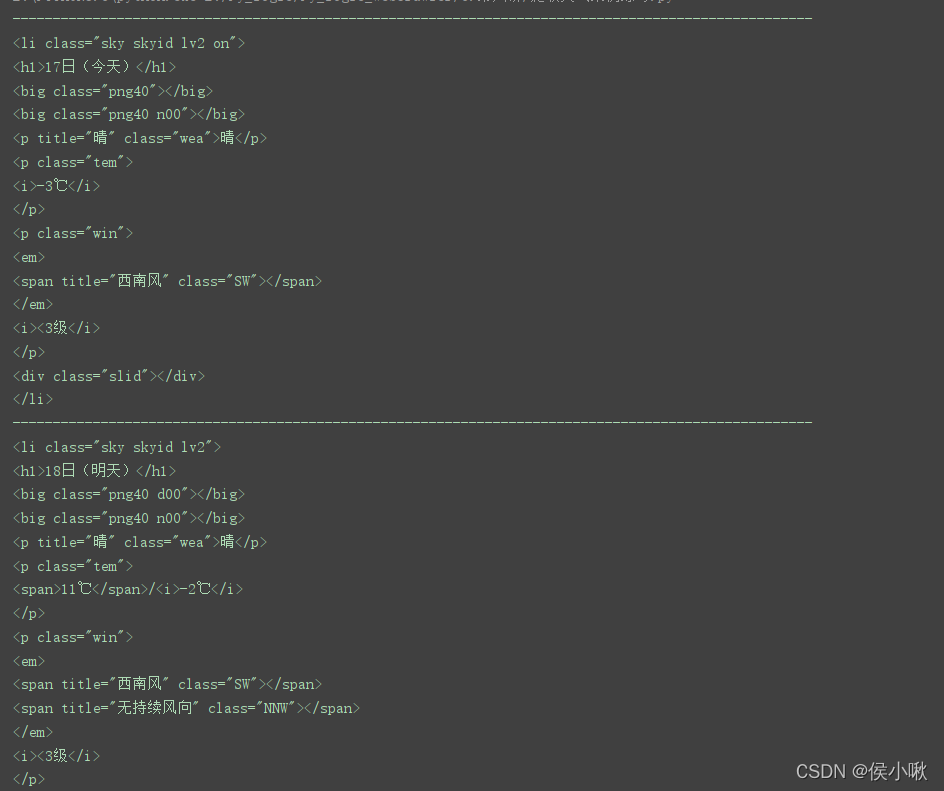
再进一步解析
不过是需要的内容,还是不需要的不确定的无规律内容,都有点星问表示。
pattern = re.compile(r'<li.*?>.*?<h1>(.*?)</h1>.*?<p.*?>(.*?)</p>.*?<i>(.*?)</i>.*?<i>(.*?)</i>.*?</li>', re.S)
for li in lis:
    r = pattern.match(li)
    print(r.group(1), end='')
    print(r.group(2), end='')
    print(r.group(3), end='')
    print(r.group(4), end='')
    print()
细节:此处第二个点星问表示匹配换行,不能忽略。虽然
- 与
之间容易觉得没有任何内容。
程序运行结果如下:
-
(其中,print()后边的end参数社会空字符表示不换行,下边的print()里边什么也不放表示换行。)
最后,外加存储过程,一起写为面向对象形式为:
import requests
import csv
import re


class WeatherSpider():

    # 发送请求函数
    def get_Source(self):
        url = "http://www.weather.com.cn/weather/101180101.shtml"
        headers = {

                'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/96.0.4664.45 Safari/537.36',
           }
        response = requests.get(url, headers=headers)
        return response.content.decode('utf-8')

    # 解析数据函数
    def parse_Source(self):
        content = self.get_Source()
        # 经过分析 需要获取到目标ul标签
        result = re.match(r'.*?(<ul class="t clearfix">.*?</ul>).*?', content, re.S)
        ul = result.group(1)
        # 获取li标签
        lis = re.findall(r'<li.*?">.*?</li>', ul, re.S)
        pattern = re.compile(r'<li.*?>.*?<h1>(.*?)</h1>.*?<p.*?>(.*?)</p>.*?<i>(.*?)</i>.*?<i>(.*?)</i>.*?</li>', re.S)   # 第二个 .*? 表示换行了。
        lst_all = []  # 保存所有的天气
        # 解析li的数据
        for li in lis:
            # print('-'*100)
            # print(li)
            r = pattern.match(li)
            # print(r.group(1), end='')
            # print(r.group(2), end='')
            # print(r.group(3), end='')
            # print(r.group(4), end='')
            # print()
            lst_one = [r.group(1), r.group(2), r.group(3), r.group(4)]
            lst_all.append(lst_one)
        return lst_all

    # 保存文件
    def saveDate(self):
        # 获取数据
        content = self.parse_Source()
        with open('weather.csv', 'w', encoding='utf-8', newline='') as f:
            writer = csv.writer(f)
            writer.writerow(['日期', '天气', '温度', '风度'])
            writer.writerows(content)


def main():
    weather = WeatherSpider()
    weather.saveDate()


if __name__ == '__main__':
    main()