教你如何一步步分析Redis的架构设计

简介: 构造Redis 这种 KV DB,首要考虑:数据模型能存什么数据?如用户信息(用户ID、name、age、sex等),通常用 MySQL,在一个用户ID对应一个用户信息集合的场景下,就是KV DB的数据模型之一,也能满足这类存储需求。操作接口可以怎么操作数据?如计算多个用户的avg年龄,KV DB则无法胜任。因其只提供了简单的操作接口,并不支持复杂聚合计算。所以,先搞懂数据模型和操作接口,才能物尽其用。

Redis本身内容繁杂,要是上来就研究一细节点,如连接池、数据结构,虽可直接学到某个点的详尽源码内容,甚至尽快解决一些事故,但容易溺死在细节汪洋,无法整体把控Redis。


最好是先建立起“架构”。想精通Redis,须能领略其总体架构,再深入具体技术点。


构造Redis 这种 KV DB,首要考虑:

  • 数据模型
    能存什么数据?如用户信息(用户ID、name、age、sex等),通常用 MySQL,在一个用户ID对应一个用户信息集合的场景下,就是KV DB的数据模型之一,也能满足这类存储需求。
  • 操作接口
    可以怎么操作数据?如计算多个用户的avg年龄,KV DB则无法胜任。因其只提供了简单的操作接口,并不支持复杂聚合计算。

所以,先搞懂数据模型和操作接口,才能物尽其用。

数据模型

KV DB,最基本数据模型就是KV模型。选型KV DB时,一大因素就是其支持的V类型:

  • Memcached仅支持String V类型
  • 而Redis支持的V类型还包括hash、list、set等

所以Redis能被更广泛应用。

对 crud boy来说,不同V类型就意味着能支持多种业务的数据需求。

===

操作接口

无论什么DB,基本操作都逃不开 crud:

  • PUT:新写入或更新一个KV对
  • GET:根据一个key读取相应的V值
  • DELETE:根据一个key删除整个KV对
  • SCAN操作:根据一段K范围,返回相应V值

内存 or 外存?

  • 在内存,读写快,百ns级。风险是一旦掉电,会丢失所有数据
  • 在外存,虽可避免数据丢失,但受限于磁盘慢速读写(几ms级别),KV DB整体性能会被拉低。

因此,需根据KV DB应用场景来选型。

如缓存场景下的数据需要能快速访问但允许丢失,则采用内存保存KV数据。

访问模式选型

  • 通过函数库调用供外部使用
    如libsimplekv.so,就是以动态链接库的形式链接到我们自己的程序,提供KV存储功能,如RocksDB。
  • 通过网络框架,以Socket通信对外提供KV对操作,可提供广泛的KV存储服务
    如Memcached和Redis。

通过网络框架提供KV存储服务:

  • 扩大了KV DB的生态
  • 给KV DB的性能、运行模型提供了不同选型,带来潜在问题

比如,当客户端发送如下命令,该命令会被封装在网络包中发送给KV DB:

PUT java edge

KV DB网络框架接收到网络包,并按照相应的协议进行解析后,可知客户端想写入一个键值对,并开始实际写入。

I/O模型设计

网络连接的处理、解析客户端的请求及数据存取的处理,应该选择怎样的线程模型?

  • 一个线程,既要处理网络连接、解析请求,又要完成数据存取,一旦某一步操作发生阻塞,整个线程就会阻塞住,这就降低了系统响应速度
  • 多线程处理不同操作,则某个线程被阻塞时,其他线程还能正常运行。但不同线程间如果需要访问共享资源,又会产生线程竞争,影响系统效率

所以,这里也还需精心设计。

KV对的定位

知道了要进行的KV对操作,就得查找所要操作的KV对是否存在,这就依赖KV DB的索引模块:让KV DB据key找到相应V的存储位置。

不同KV DB采用的索引:

  • Memcached、Redis采用哈希表
  • RocksDB采用跳表

一般内存KV DB(如Redis)采用哈希表作为索引,主要因其KV基本都保存在内存,而内存高性能随机访问特性与哈希表O(1)复杂度匹配。

Redis的V支持多种类型,当通过索引找到一个K所对应V,仍需从V的复杂结构(如set或list)中进一步找到想要数据,该操作的效率本身就依赖其实现结构。而Redis便采用一些高效的索引结构作为某些V类型的底层数据结构。


各操作的具体逻辑

不同操作找到V的存储位置后的操作:

  • GET/SCAN
    根据V的存储位置返回V值
  • PUT
    为该KV对分配内存空间
  • DELETE
    删除KV对,并释放内存空间,该过程由分配器完成

重启后快速提供服务

KV DB的KV对大小不一,分配器在处理随机的大小内存块分配时,表现不好的话,一旦KV对数据规模过大,可能导致严重内存碎片。

所以分配器是KV DB中的关键。对内存存储为主的Redis更重要。Redis的内存分配器提供了多种选择,分配效率也不同。


KV DB虽依赖内存保存数据,提供快速访问,但也希望KV DB重启后能快速重新提供服务,所以,在其存储模块增加持久化功能。


因为磁盘管理比内存管理复杂,KV DB直接采用文件形式,将KV数据通过调用本地文件系统的操作接口保存在磁盘。

此时,KV DB只需考虑何时将内存中的KV数据保存到文件:

  • 每个KV对都落盘保存,这虽然让数据更可靠,但每次都写盘,性能受大影响
  • 周期性把内存中的KV对保存到文件,避免频繁写盘。但数据有丢失风险

所以,Redis提供了持久化功能,还有多种执行机制和性能优化点。

KV DB - Redis 架构
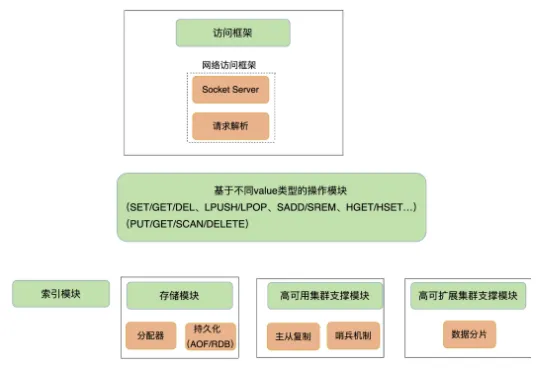
image.png

目录
相关文章
|
人工智能 API 数据安全/隐私保护
Apifox 与 Apipost 的 API 文档引擎对比:底层架构、性能与可扩展性分析
深入探索市场上两大主流API工具——Apifox和Apipost的文档能力时,发现了令人惊讶的差距。这不仅仅是功能多寡的问题,更关乎开发效率与团队协作的质变。
|
人工智能 自然语言处理 数据可视化
两大 智能体框架 Dify vs Langchain 的全面分析,该怎么选?资深架构师 做一个彻底的解密
|
12月前
|
NoSQL 算法 Redis
【Docker】(3)学习Docker中 镜像与容器数据卷、映射关系!手把手带你安装 MySql主从同步 和 Redis三主三从集群!并且进行主从切换与扩容操作,还有分析 哈希分区 等知识点!
Union文件系统(UnionFS)是一种**分层、轻量级并且高性能的文件系统**,它支持对文件系统的修改作为一次提交来一层层的叠加,同时可以将不同目录挂载到同一个虚拟文件系统下(unite several directories into a single virtual filesystem) Union 文件系统是 Docker 镜像的基础。 镜像可以通过分层来进行继承,基于基础镜像(没有父镜像),可以制作各种具体的应用镜像。
1049 6
|
缓存 运维 监控
Redis 7.0 高性能缓存架构设计与优化
🌟蒋星熠Jaxonic,技术宇宙中的星际旅人。深耕Redis 7.0高性能缓存架构,探索函数化编程、多层缓存、集群优化与分片消息系统,用代码在二进制星河中谱写极客诗篇。
1978 3
|
存储 监控 NoSQL
Redis高可用架构全解析:从主从复制到集群方案
Redis高可用确保服务持续稳定,避免单点故障导致数据丢失或业务中断。通过主从复制实现数据冗余,哨兵模式支持自动故障转移,Cluster集群则提供分布式数据分片与水平扩展,三者层层递进,保障读写分离、容灾切换与大规模数据存储,构建高性能、高可靠的Redis架构体系。
|
Java API 开发工具
灵码产品演示:软件工程架构分析
本演示展示灵码对复杂软件项目的架构分析与文档生成能力。通过Qwen3模型,结合PlantUML,自动生成系统架构图、微服务时序图,并提取API接口文档,实现高效、智能的代码理解与文档输出。
695 5
|
存储 JSON 数据处理
ClkLog埋点与用户行为分析系统:架构升级与性能全面提升
随着越来越多企业在实际业务中使用 ClkLog,数据规模和分析需求也不断提升,部分用户日活已经超过10万,为了顺应这一趋势,ClkLog 秉持 “开放透明、持续演进”的理念,推出了迄今为止最重要的一次性能优化升级。新版本在大规模数据处理与复杂查询场景中,性能表现实现了跨越式提升。经过多轮研发与严格测试,新版本现已正式上线:在原有付费版 1.0 的基础上架构全面升级,并同步发布全新的 2.0 版本。为用户带来更强的性能与更广的适用场景。
|
机器学习/深度学习 人工智能 算法
大型多模态推理模型技术演进综述:从模块化架构到原生推理能力的综合分析
该研究系统梳理了大型多模态推理模型(LMRMs)的技术发展,从早期模块化架构到统一的语言中心框架,提出原生LMRMs(N-LMRMs)的前沿概念。论文划分三个技术演进阶段及一个前瞻性范式,深入探讨关键挑战与评估基准,为构建复杂动态环境中的稳健AI系统提供理论框架。未来方向聚焦全模态泛化、深度推理与智能体行为,推动跨模态融合与自主交互能力的发展。
1174 13
大型多模态推理模型技术演进综述:从模块化架构到原生推理能力的综合分析
|
存储 NoSQL 算法
Redis的集群架构与使用经验
本文介绍了Redis的集群架构与使用经验,包括主从复制、哨兵集群及Cluster分片集群的应用场景与实现原理。内容涵盖Redis主从同步机制、数据分片存储方式、事务支持及与Memcached的区别,并讨论了Redis内存用尽时的处理策略。适用于了解Redis高可用与性能优化方案。
|
存储 前端开发 JavaScript
如何开发设备管理系统中的经验分析报表板块 ?(附架构图+流程图+代码参考)
设备管理系统(EMS)助力企业高效管理设备生命周期,涵盖采购、维护到报废全流程。本文详解经验分析报表模块设计与开发,涵盖动态看板、点检、巡检、维修、保养及库存统计功能,提供代码示例与架构设计建议,提升设备管理效率与决策水平。