- 互联网应用常规流程、
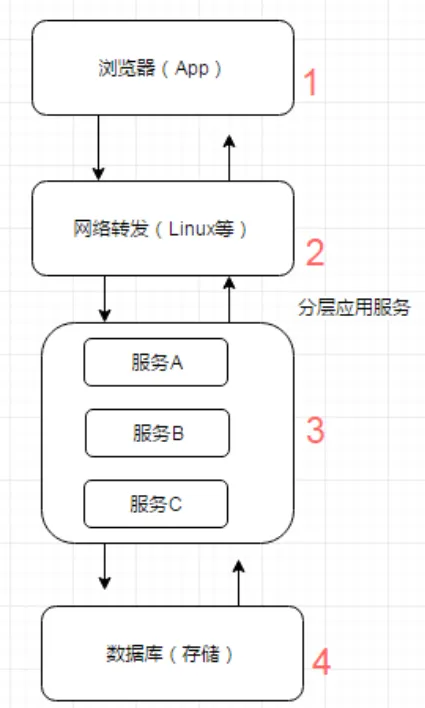
缓存可使用在1~4的各个环节中,每个环节的缓存方案与使用各有特点。
1 缓存特征
数据分类
按使用频率和方式:
- 静态数据
一般不变,类似于字典表 - 准静态数据
变化频率很低,部门结构设置,全国行政区划数据等 - 中间状态数据
一些计算的可复用中间数据,变量副本,配置中心的本地副本 - 热数据
使用频率高 - 读写比较大
读的频率 >> 写的频率
这些数据适合于使用缓存的方式访问
- 广义,为了加速数据处理,让业务更快访问的临时存放的冗余数据
- 狭义,在分布式系统里把缓存到内存的数据,也就是 Redis
缓存是一个数据模型对象,有它的一些特征
1.1 命中率
命中率=返回正确结果数/请求缓存次数
命中率问题是缓存中的一个非常重要的问题,它是衡量缓存有效性的重要指标。命中率越高,表明缓存的使用率越高。
1.2 最大元素(或最大空间)
缓存中可以存放的最大元素的数量,一旦缓存中元素数量超过这个值(或者缓存数据所占空间超过其最大支持空间)
那么将会触发缓存启动清空策略,根据不同的场景合理的设置最大元素值往往可以一定程度上提高缓存的命中率,从而更有效的使用缓存
1.3 清除策略
缓存的存储空间有限制,当缓存空间被用满时,如何保证在稳定服务的同时有效提升命中率?
这就由缓存清空策略来处理
常见的一般策略有:
- FIFO(first in first out)
最先进入缓存的数据在缓存空间不够的情况下(超出最大元素限制)会被优先被清除掉,以腾出新的空间接受新的数据
策略算法主要比较缓存元素的创建时间。在数据实效性要求场景下可选择该类策略,优先保障最新数据可用
- LFU(less frequently used)
无论是否过期,根据元素的被使用次数判断,清除使用次数较少的元素释放空间
策略算法主要比较元素的hitCount(命中次数)。在保证高频数据有效性场景下,可选择这类策略
- LRU(least recently used)
无论是否过期,根据元素最后一次被使用的时间戳,清除最远使用时间戳的元素释放空间
策略算法主要比较元素最近一次被get使用时间。在热点数据场景下较适用,优先保证热点数据的有效性
除此之外,还有一些简单策略比如:
- 根据过期时间判断,清理过期时间最长的元素
- 根据过期时间判断,清理最近要过期的元素
- 随机清理
- 根据关键字(或元素内容)长短清理等
2 缓存概述
2.1 缓存本质
系统各级处理速度不匹配,导致利用空间换时间。缓存是提升系统性能的一个简单有效的办法。
2.2 缓存加载时机
启动全量加载
全局有效,使用简单,但导致启动慢。
懒加载
同步使用加载
- 先看缓存是否有数据,没有则从数据库读取
- 读取的数据,先放入
延迟异步加载
从缓存获取数据,不管是否为空直接返回,有如下两种策略:
- 异步,如果为空,则发起一个异步加载的线程,负责加载数据
- 解耦,异步线程负责维护缓存的数据,定期或根据条件触发更新
2.3 缓存的有效性
- 变动频、一致性要求高的数据,不适合用缓存
变化大,意味着内存缓存数据和原始数据库数据之间一直有差异;
一致性要求高,意味着只有使用原始数据,甚至加了事务,才稳妥。
缓存的有效性度量
- 读写比
对数据的写操作导致数据变动,意味着维护成本。N :1。 - 命中率
命中缓存意味着缓存数据被使用,意味着有价值。90%+
计算机科学只存在两个难题:缓存失效和命名。
- Phil Karlton
所以必须综合衡量数据一致性,性能,成本来决定是否引入缓存。
2 缓存介质
从硬件介质上来看,内存和硬盘
从技术上,可以分成内存、硬盘文件、数据库
- 内存
将缓存存储于内存中是最快的选择,无需额外的I/O开销,但是内存的缺点是没有持久化落地物理磁盘,一旦应用异常break down而重新启动,数据很难或者无法复原
- 硬盘
一般来说,很多缓存框架会结合使用内存和硬盘,在内存分配空间满了或是在异常的情况下,可以被动或主动的将内存空间数据持久化到硬盘中,达到释放空间或备份数据的目的。
- 数据库
增加缓存的策略的目的之一就是为了减少数据库的I/O压力。现在使用数据库做缓存介质是不是又回到了老问题上了?其实,数据库也有很多种类型,像那些不支持SQL,只是简单的key-value存储结构的特殊数据库(如BerkeleyDB和Redis),响应速度和吞吐量都远远高于我们常用的关系型数据库等。
3 缓存分类和应用场景
根据缓存与应用的藕合度,分为local cache(本地缓存)和remote cache(分布式缓存)
本地缓存
在业务系统应用中的缓存组件:
- 最大的优点
应用和cache是在同一个JVM进程,请求缓存非常快速,没有过多网络开销(请求 redis 服务器)等,在单体应用不需集群或集群下各节点无需互相通知的数据强一致场景下使用本地缓存较合适
- 缺点
应为缓存跟应用程序耦合,多个应用程序无法直接的共享缓存,各应用或集群的各节点都需要维护自己的单独缓存,对内存是一种浪费。
分布式缓存
与应用分离的缓存组件或服务,其最大的优点是自身就是一个独立的应用,与本地应用隔离,多个应用可直接的共享缓存
3.1 本地缓存
3.1.1 编程直接实现缓存
有的场景只需简单的缓存数据的功能,无需关注更多存取、清空策略等深入特性,这时直接编程实现缓存最为简单高效。
成员变量或局部变量实现
    public void UseLocalCache(){
     //一个本地的缓存变量
     Map<String, Object> localCacheStoreMap = new HashMap<String, Object>();

    List<Object> infosList = this.getInfoList();
    for(Object item:infosList){
        if(localCacheStoreMap.containsKey(item)){ //缓存命中 使用缓存数据
            // todo
        } else { // 缓存未命中  I/O获取数据,结果存入缓存
            Object valueObject = this.getInfoFromDB();
            localCacheStoreMap.put(valueObject.toString(), valueObject);

        }
    }
}
//示例
private List<Object> getInfoList(){
    return new ArrayList<Object>();
}
//示例数据库I/O获取
private Object getInfoFromDB(){
    return new Object();
}
以局部变量map结构缓存部分业务数据,减少频繁的重复数据库I/O操作。缺点仅限于类的自身作用域内,类间无法共享缓存。
静态变量实现
最常用的单例实现静态资源缓存
   public class CityUtils {
    private static final HttpClient httpClient = ServerHolder.createClientWithPool();
    private static Map<Integer, String> cityIdNameMap = new HashMap<Integer, String>();
    private static Map<Integer, String> districtIdNameMap = new HashMap<Integer, String>();

    static {
        HttpGet get = new HttpGet("http://gis-in.sankuai.com/api/location/city/all");
        BaseAuthorizationUtils.generateAuthAndDateHeader(get,
                BaseAuthorizationUtils.CLIENT_TO_REQUEST_MDC,
                BaseAuthorizationUtils.SECRET_TO_REQUEST_MDC);
        try {
            String resultStr = httpClient.execute(get, new BasicResponseHandler());
            JSONObject resultJo = new JSONObject(resultStr);
            JSONArray dataJa = resultJo.getJSONArray("data");
            for (int i = 0; i < dataJa.length(); i++) {
                JSONObject itemJo = dataJa.getJSONObject(i);
                cityIdNameMap.put(itemJo.getInt("id"), itemJo.getString("name"));
            }
        } catch (Exception e) {
            throw new RuntimeException("Init City List Error!", e);
        }
    }

    static {
        HttpGet get = new HttpGet("http://gis-in.sankuai.com/api/location/district/all");
        BaseAuthorizationUtils.generateAuthAndDateHeader(get,
                BaseAuthorizationUtils.CLIENT_TO_REQUEST_MDC,
                BaseAuthorizationUtils.SECRET_TO_REQUEST_MDC);
        try {
            String resultStr = httpClient.execute(get, new BasicResponseHandler());
            JSONObject resultJo = new JSONObject(resultStr);
            JSONArray dataJa = resultJo.getJSONArray("data");
            for (int i = 0; i < dataJa.length(); i++) {
                JSONObject itemJo = dataJa.getJSONObject(i);
                districtIdNameMap.put(itemJo.getInt("id"), itemJo.getString("name"));
            }
        } catch (Exception e) {
            throw new RuntimeException("Init District List Error!", e);
        }
    }

    public static String getCityName(int cityId) {
        String name = cityIdNameMap.get(cityId);
        if (name == null) {
            name = "未知";
        }
        return name;
    }

    public static String getDistrictName(int districtId) {
        String name = districtIdNameMap.get(districtId);
        if (name == null) {
            name = "未知";
        }
        return name;
    }
}
O2O业务中常用的城市基础基本信息判断,通过静态变量一次获取缓存内存中,减少频繁的I/O读取。
静态变量实现类间可共享,进程内可共享,缓存的实时性稍差。
缓存使用不当导致的问题
- 系统预热导致启动慢
一个系统启动需要预热半个小时。 导致系统不能做到快速应对故障宕机等问题。 - 系统内存资源耗尽
只加入数据,不能清理旧数据。 旧数据处理不及时,或者不能有效识别无用数据。
缺点:
- 并发
- 容量
- 过期策略
为了解决本地缓存数据的实时性问题,目前大量使用的是结合ZooKeeper的自动发现机制,实时变更本地静态变量缓存:
美团的基础配置组件MtConfig,采用的就是类似原理,使用静态变量缓存,结合ZooKeeper的统一管理,做到自动动态更新缓存。
- Mtconfig实现图
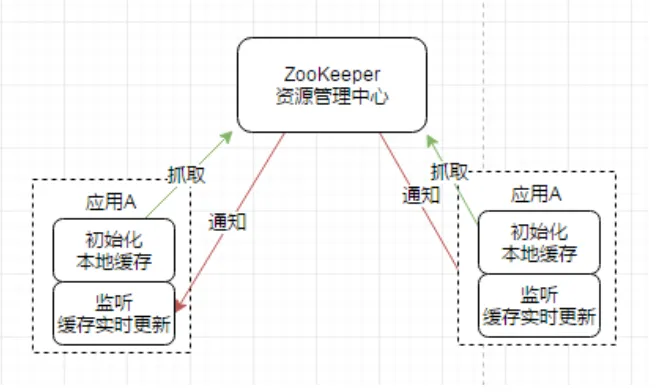
这类缓存,优点是能直接在heap区内读写,最快也最方便。
缺点同样是受heap区域影响,缓存的数据量非常有限,同时缓存时间受GC影响。
主要满足单机场景下的小数据量缓存需求,同时对缓存数据的变更无需太敏感,如一般配置管理、基础静态数据等场景。
3.1.2 Ehcache(使用度较低)
3.1.3 Guava Cache(常用)
3.1.4 Spring Cache(常用)
3.1.5 本地缓存的缺陷
- 无法在多个集群环境同步。当集群规模增大,缓存的读写放大
- 在JVM中长期占用内存,如果是堆内存,会影响GC
- 缓存数据的调度处理,影响执行业务的线程,抢资源。
所以使用集中处理缓存,单独部署管理缓存。
这也有缺点:网络请求层数增加;如果故障,缓存全部延迟或失效。不过这仍是主流的缓存方案。
3.2 分布式缓存
Memcached缓存
Redis 缓存
实际工程中,对于缓存的应用可以有多种的实战方式,包括侵入式硬编码,抽象服务化应用,以及轻量的注解式使用等。