http://pkgs.fedoraproject.org/repo/pkgs/haproxy/ ftp下载
http://cbonte.github.io/haproxy-dconv/ 官方文档
一、先来看看Haproxy的原理
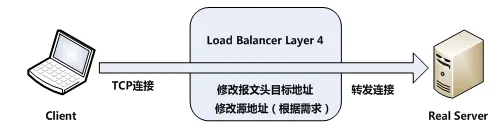
以常见的TCP应用为例,负载均衡器在接收到第一个来自客户端的SYN请求时,会通过设定的负载均衡算法选择一个最佳的后端服务器,同时将报文中目标IP地址修改为后端服务器IP,然后直接转发给该后端服务器,这样一个负载均衡请求就完成了。从这个过程来看,一个TCP连接是客户端和服务器直接建立的,而负载均衡器只不过完成了一个类似路由器的转发动作。在某些负载均衡策略中,为保证后端服务器返回的报文可以正确传递给负载均衡器,在转发报文的同时可能还会对报文原来的源地址进行修改。整个过程下图所示。
同理,七层负载均衡器也称为七层交换机,位于OSI的最高层,即应用层,此时负载均衡器支持多种应用协议,常见的有HTTP、FTP、SMTP等。七层负载均衡器可以根据报文内容,再配合负载均衡算法来选择后端服务器,因此也称为“内容交换器”。比如,对于Web服务器的负载均衡,七层负载均衡器不但可以根据“IP+端口”的方式进行负载分流,还可以根据网站的URL、访问域名、浏览器类别、语言等决定负载均衡的策略。例如,有两台Web服务器分别对应中英文两个网站,两个域名分别是A、B,要实现访问A域名时进入中文网站,访问B域名时进入英文网站,这在四层负载均衡器中几乎是无法实现的,而七层负载均衡可以根据客户端访问域名的不同选择对应的网页进行负载均衡处理。常见的七层负载均衡器有HAproxy、Nginx等。
这里仍以常见的TCP应用为例,由于负载均衡器要获取到报文的内容,因此只能先代替后端服务器和客户端建立连接,接着,才能收到客户端发送过来的报文内容,然后再根据该报文中特定字段加上负载均衡器中设置的负载均衡算法来决定最终选择的内部服务器。纵观整个过程,七层负载均衡器在这种情况下类似于一个代理服务器。整个过程如下图所示。
对比四层负载均衡和七层负载均衡运行的整个过程,可以看出,在七层负载均衡模式下,负载均衡器与客户端及后端的服务器会分别建立一次TCP连接,而在四层负载均衡模式下,仅建立一次TCP连接。由此可知,七层负载均衡对负载均衡设备的要求更高,而七层负载均衡的处理能力也必然低于四层模式的负载均衡。
二、源码编译与安装
1、tar -zxf haproxy-1.7.9.tar.gz
2、cd haproxy-1.7.9
3、make TARGET=linux2628 PREFIX=/usr/local/haproxy
TARGET应该怎么填?TARGET指定编译对应的os对应的内核版本,通过命令”uname -r”查询Linux内核版本。源文件夹readme有针对平台的定义:
- linux22     for Linux 2.2
  - linux24     for Linux 2.4 and above (default)
  - linux24e    for Linux 2.4 with support for a working epoll (> 0.21)
  - linux26     for Linux 2.6 and above
  - linux2628   for Linux 2.6.28, 3.x, and above (enables splice and tproxy)
  - solaris     for Solaris 8 or 10 (others untested)
  - freebsd     for FreeBSD 5 to 10 (others untested)
  - netbsd      for NetBSD
  - osx         for Mac OS/X
  - openbsd     for OpenBSD 5.7 and above
  - aix51       for AIX 5.1
  - aix52       for AIX 5.2
  - cygwin      for Cygwin
  - haiku       for Haiku
  - generic     for any other OS or version.
  - custom      to manually adjust every setting
4、make install PREFIX=/usr/local/haproxy
5、mkdir /usr/local/haproxy/conf
cd /usr/local/haproxy/conf
6、haproxy默认是不带配置文件的,需要自己在conf文件夹里新建和编辑配置文件
touch haproxy.cfg,内容如下
global #全局属性
    log 127.0.0.1 local0 info
    daemon  #以daemon方式在后台运行,推荐
    nbproc 1 #HAProxy启动时作为守护运行可创建的进程数,配合daemon参数使用,默认只启动一个进程,该值应小于cpu核数。
    maxconn 102400  #最大同时*连接
    pidfile /usr/local/haproxy/conf/haproxy.pid  #指定保存HAProxy进程号的文件
    stats socket /usr/local/haproxy/stats  #定义统计信息保存位置
defaults #默认参数
    mode tcp  #tcp/http模式
    retries 3
    timeout connect 5s  #连接server端超时5s
    timeout client 300s  #客户端响应超时50s
    timeout server 300s  #server端响应超时50s
    timeout check 300s   #设置对后端服务器检测超时时间,即心跳50s
frontend my-tcp-in #前端服务tcp-in
    mode tcp
    bind 0.0.0.0:1884  #监听1884端口
    log global
    default_backend my-servers  #请求转发至名为"my-servers"的后端服务
backend my-servers #后端服务servers
    balance roundrobin #使用RR负载均衡算法
    server server1 172.16.6.161:1883 maxconn 10000  #backend servers中只有一个后端服务,名字叫server1,启在本机的1883端口,HAProxy同时最多向这个服务发起?个连接
    server server2 172.16.6.161:1888 maxconn 10000
    server server3 172.16.6.162:1888 maxconn 10000 check inter 3000 rise 2 fall 3
listen admin_status #统计web页面配置, frontend和backend的组合体, 监控组的名称可按需自定义
    mode http #配置监控运行模式
    bind 0.0.0.0:1080 #配置统计页面访问端口
    maxconn 10 #统计页面默认最大连接数
    log 127.0.0.1 local0 err
    stats enable #开启统计
    stats refresh 30s #监控页面自动刷新时间
    stats uri /stats #统计页面访问url
    stats realm welcome login\ Haproxy #统计页面密码框提示文本
    stats auth admin:admin #监控页面的用户和密码:admin, 可设置多个用户名
    stats admin if TRUE #手工启动/禁用后端服务器, 可通过web管理节点
默认也没有日志文件,需要自己设置/etc/rsyslog,详情见参考文献。
Haproxy通过check可以对后端服务器定期进行“健康”检测,及时发现down掉的“机器”和重新up的“机器”。
1) 对于down掉的机器Haproxy不再对向其转发数据;
2) 对于重新up的机器Haproxy将恢复向其转发数据。
check inter 3000 rise 2 fall 3
设置检测时间为3000毫秒,如果连续2次成功则标记该机器是up的,如果连续3次失败则标记其为down。