Dataset之Pascal:Pascal竞赛及其Pascal VOC(VOC 2012、VOC 2007) 数据集的简介、下载、使用方法详细攻略(二)

简介: Dataset之Pascal:Pascal竞赛及其Pascal VOC(VOC 2012、VOC 2007) 数据集的简介、下载、使用方法详细攻略

Pascal VOC 数据集的简介


      PASCAL VOC挑战在2005年至2012年间展开。 目标检测技术的基准之一。该数据集中有20个分类。该数据集包含11530张用于训练和验证的图像, 其中感兴趣区域有27450个标定。

      PASCAL VOC为图像识别和分类提供了一整套标准化的优秀的数据集,从2005年到2012年每年都会举行一场图像识别challenge。该挑战的主要目的是识别真实场景中一些类别的物体。在该挑战中,这是一个监督学习的问题,训练集以带标签的图片的形式给出。

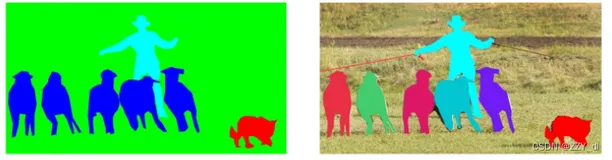
      Pascal VOC(2005~2012)竞赛的目标主要是进行图像的目标识别,其提供的数据集包含20类的物体。每张图片都有标注,标注的物体包括人、动物(如猫、狗、岛等)、交通工具(如车、船飞机等)、家具(如椅子、桌子、沙发等)在内的20个类别。每个图像平均有2.4个目标。所有的标注图片都有Detection需要的label, 但只有部分数据有Segmentation Label。


1、VOC2007和VOC2012数据集


1、VOC2007


      VOC2007:中包含9963张标注过的图片, 由train/val/test三部分组成, 共标注出24,640个物体。 VOC2007的test数据label已经公布, 之后的没有公布(只有图片,没有label)。


2、VOC2012


      VOC2012:VOC2012数据集是VOC2007数据集的升级版,一共有11530张图片。对于检测任务,VOC2012的trainval/test包含08-11年的所有对应图片。 trainval有11540张图片共27450个物体。 对于分割任务, VOC2012的trainval包含07-11年的所有对应图片, test只包含08-11。trainval有 2913张图片共6929个物体。    

     VOC2012数据集分为20类,包括背景为21类,分别如下:


人:人

动物:鸟、猫、牛、狗、马、羊

车辆:飞机、自行车、船、巴士、汽车、摩托车、火车

室内:瓶、椅子、餐桌、盆栽植物、沙发、电视/监视器

       这些物体包括20类:  

image.png


Person: person

Animal: bird, cat, cow, dog, horse, sheep

Vehicle: aeroplane, bicycle, boat, bus, car, motorbike, train

Indoor: bottle, chair, dining table, potted plant, sofa, tv/monitor


Pascal VOC 数据集的下载

1、VOC2012数据集下载地址:http://host.robots.ox.ac.uk/pascal/VOC/voc2012/VOCtrainval_11-May-2012.tar


(1)、将其转换为tfrecord格式:为了不影响代码的结构,还是在原来的object_detection 文件夹中, 再新建一个voc 文件夹,并将下载的数据集压缩包复制至voc/中。解压后,就得到一个VOCdevkit 文件夹,最终的文件夹结构应该为


Pascal VOC 数据集的使用方法


后期更新……


相关文章
|
数据处理 开发工具 git
coco2017数据集转换为yolo格式(记录过程)
最近做一个yolov5的落地应用项目,用的anylabeling打标,需要将coco2017的数据集转为yolo格式,故写下记录过程!
|
机器学习/深度学习 编解码 监控
目标检测实战(六): 使用YOLOv8完成对图像的目标检测任务(从数据准备到训练测试部署的完整流程)
这篇文章详细介绍了如何使用YOLOv8进行目标检测任务,包括环境搭建、数据准备、模型训练、验证测试以及模型转换等完整流程。
30031 59
目标检测实战(六): 使用YOLOv8完成对图像的目标检测任务(从数据准备到训练测试部署的完整流程)
|
机器学习/深度学习 PyTorch TensorFlow
Pytorch学习笔记(二):nn.Conv2d()函数详解
这篇文章是关于PyTorch中nn.Conv2d函数的详解,包括其函数语法、参数解释、具体代码示例以及与其他维度卷积函数的区别。
4196 0
Pytorch学习笔记(二):nn.Conv2d()函数详解
|
算法 Go 计算机视觉
YOLOv8结构解读
YOLOv8是Ultralytics团队开发的最新目标检测模型,基于YOLO系列的高效单阶段架构,进一步优化了精度与速度。相比YOLOv5,YOLOv8在Backbone中移除了Focus模块,优化了CSP结构;在Neck部分增强了特征融合能力;Head部分采用Anchor-Free与解耦头设计,提升检测精度。此外,YOLOv8引入了更先进的损失函数、自对抗训练和动态标签分配等策略,显著提高了模型性能与鲁棒性。
3569 0
|
机器学习/深度学习 JSON 算法
语义分割笔记(二):DeepLab V3对图像进行分割(自定义数据集从零到一进行训练、验证和测试)
本文介绍了DeepLab V3在语义分割中的应用,包括数据集准备、模型训练、测试和评估,提供了代码和资源链接。
5115 0
语义分割笔记(二):DeepLab V3对图像进行分割(自定义数据集从零到一进行训练、验证和测试)
|
机器学习/深度学习 人工智能 文字识别
ultralytics YOLO11 全新发布!(原理介绍+代码详见+结构框图)
本文详细介绍YOLO11,包括其全新特性、代码实现及结构框图,并提供如何使用NEU-DET数据集进行训练的指南。YOLO11在前代基础上引入了新功能和改进,如C3k2、C2PSA模块和更轻量级的分类检测头,显著提升了模型的性能和灵活性。文中还对比了YOLO11与YOLOv8的区别,并展示了训练过程和结果的可视化
27069 0
|
XML JSON 数据可视化
数据集学习笔记(二): 转换不同类型的数据集用于模型训练(XML、VOC、YOLO、COCO、JSON、PNG)
本文详细介绍了不同数据集格式之间的转换方法,包括YOLO、VOC、COCO、JSON、TXT和PNG等格式,以及如何可视化验证数据集。
5431 1
数据集学习笔记(二): 转换不同类型的数据集用于模型训练(XML、VOC、YOLO、COCO、JSON、PNG)
|
存储 编解码 数据安全/隐私保护
ISPRS Vaihingen 数据集解析
3221 0
ISPRS Vaihingen 数据集解析
|
算法 Go vr&ar
YOLOv8模型yaml结构图理解(逐层分析)
24876 1
|
算法
CamVid数据集(智能驾驶场景的语义分割)
CamVid 数据集是由剑桥大学公开发布的城市道路场景的数据集。CamVid全称:The Cambridge-driving Labeled Video Database,它是第一个具有目标类别语义标签的视频集合。 数据集包 括 700 多张精准标注的图片用于强监督学习,可分为训练集、验证集、测试集。同时, 在 CamVid 数据集中通常使用 11 种常用的类别来进行分割精度的评估,分别为:道路 (Road)、交通标志(Symbol)、汽车(Car)、天空(Sky)、行人道(Sidewalk)、电线杆 (Pole)、围墙(Fence)、行人(Pedestrian)、建筑物(Building)
2885 0