WOT(World Of Tech)2015,互联网运维与开发者大会将在北京举行,会上58同城将分享《大数据量下,58同城mysql实战》的主题,干货分享抢先看。
零、分享提纲
1)基本概念
2)常见问题及解决思路
3)拆库实战
4)拆库后业务实战
5)总结
一、基本概念
大数据量下,搞mysql,以下概念需要先达成一致
1)单库,不多说了,就是一个库

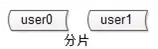
2)分片(sharding),水平拆分,用于解决扩展性问题
3)复制(replication)与分组(group),用于解决可用性问题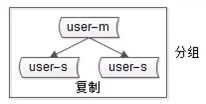
4)分片+分组,这是大数据量下,mysql架构的实际情况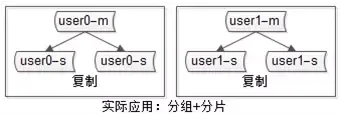
二、大数据量下,mysql常见问题及解决思路
1)常见问题
如何保证可用性?
各色各异的读写比,怎么办?
如何做无缝倒库,加字段,扩容?
数据量大,怎么解决?
2)解决思路
2.1)可用性解决思路:复制
读库可用性
从库复制多个,例如:1主2从
从库挂了读主库,例如:1主1从
写库可用性
双主模式
“双主”当“主从”用
2.2)读写比解决思路-针对特性做设计
读多些少场景:提升读性能,3种常见方案:
a)新建索引提高读性能,什么小技巧?
b)读写分离,增加从库扩展读性能
c)增加缓存来扩展读性能
a)b)c)方案存在什么问题?
如何解决这些问题?
读写相近场景:不要使用缓存,考虑水平切分
写多读少场景:不要使用缓存,考虑水平切分
2.3)无缝倒库[扩容,增加字段,数据迁移]
追日志方案
a)记录写日志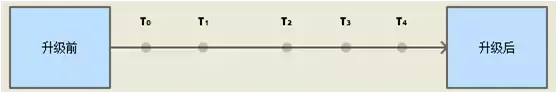
b)倒库
c)倒库完毕
d)追日志
e)追日志完毕+数据校验
f)切库
双写方案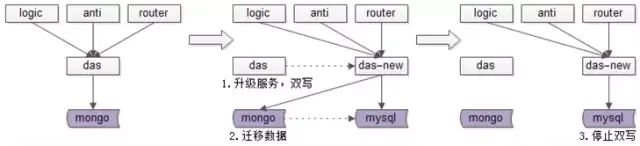
a)服务双写
b)倒库
c)倒库完毕+数据校验
d)切库
2.4)数据量大解决思路:拆库
三、58同城数据库拆库实战
四类场景覆盖99%拆库业务
a)“单key”场景,用户库如何拆分: user(uid, XXOO)
b)“1对多”场景,帖子库如何拆分: tiezi(tid, uid, XXOO)
c)“多对多”场景,好友库如何拆分: friend(uid, friend_uid, XXOO)
d)“多key”场景,订单库如何拆分:order(oid, buyer_id, seller_id, XXOO)
1)用户库如何拆分
用户库,10亿数据量
user(uid, uname, passwd, age, sex, create_time);
业务需求如下
a)1%登录请求 => where uname=XXX and passwd=XXX
b)99%查询请求 => where uid=XXX
结论:“单key”场景使用“单key”拆库
2)帖子库如何拆分
帖子库,15亿数据量
tiezi(tid, uid, title, content, time);
业务需求如下
a)查询帖子详情(90%请求)
SELECT * FROM tiezi WHERE tid=$tid
b)查询用户所有发帖(10%请求)
SELECT * FROM tiezi WHERE uid=$uid
结论:“1对多”场景使用“1”分库,例如帖子库1个uid对应多个tid,则使用uid分库,tid生成时加入分库标记
3)好友库如何拆分
好友库,1亿数据量
friend(uid, friend_uid, nick, memo, XXOO);
业务需求如下
a)查询我的好友(50%请求) => 用于界面展示
SELECT friend_uid FROM friend WHERE uid=$my_uid
b)查询加我为好友的用户(50%请求) => 用户反向通知
SELECT uid FROM friend WHERE friend_uid=$my_uid
结论:“多对多”场景,使用数据冗余方案,多份数据使用多种分库手段
4)订单库如何拆分
订单库,10亿数据量
order(oid, buyer_id, seller_id, order_info, XXOO);
业务需求如下
a)查询订单信息(80%请求)
SELECT * FROM order WHERE oid=$oid
b)查询我买的东东(19%请求)
SELECT * FROM order WHERE buyer_id=$my_uid
c)查询我卖出的东东(1%请求)
SELECT * FROM order WHERE seller_id=$my_uid
结论:“多key”场景一般有两种方案
a)方案一,使用2和3综合的方案
b)方案二,1%的请求采用多库查询
四、分库后业务实战
分库后出现的问题:单库时mysql的SQL功能不再支持了
1)海量数据下,mysql的SQL怎么玩
不会这么玩
a)各种联合查询
b)子查询
c)触发器
d)用户自定义函数
e)“事务”都用的很少
原因:对数据库性能影响极大
2)分库后,IN查询怎么玩
用户库如何进行uid的IN查询
user(uid, uname, passwd, age, sex, photo, create_time, ...);
Partition key:uid
查询需求:IN查询:WHERE uid IN(1,2,3,4,5,6)
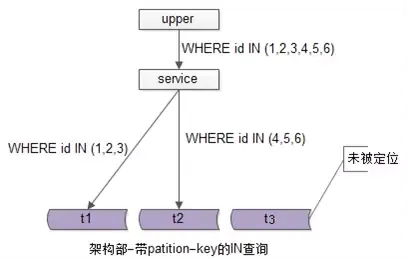
解决方案:服务做MR
方案一:直接分发
方案二:拼装成不同SQL,定位不同的库
3)分库后,非Partition key的查询怎么玩
方案一:业务方不关心数据来自哪个库,可以只定位一个库
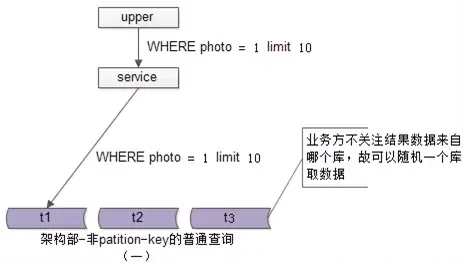
例如:有头像的用户查询
方案二:结果集只有一条数据,业务层做分发,只有一条记录返回就返回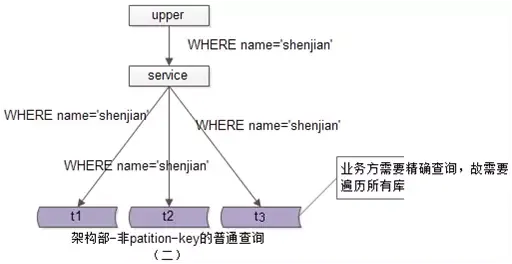
例如:用户登录时,使用userName和passwd的查询
4)分库后,夸库分页怎么玩?
问题的提出与抽象:ORDER BY xxx OFFSET xxx LIMIT xxx
a)按时间排序
b)每页100条记录
c)取第100页的记录
单机方案
ORDER BY time OFFSET 10000 LIMIT 100
分库后的难题:如何确认全局偏移量
分库后传统解决方案,查询改写+内存排序
a)ORDER BY time OFFSET 0 LIMIT 10000+100
b)对20200条记录进行排序
c)返回第10000至10100条记录
优化方案一:增加辅助id,以减少查询量
a)技术上,引入特殊id,作为查询条件(或者带入上一页的排序条件)
b)业务上,尽量禁止跨页查询
单库情况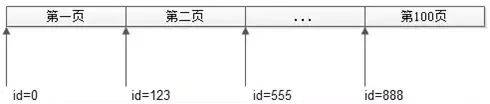
a)第一页,直接查
b)得到第一页的max(id)=123(一般是最后一条记录)
c)第二页,带上id>123查询:WHERE id>123 LIMIT 100
多库情况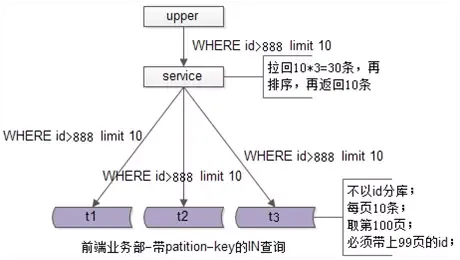
a)将WHERE id>xxx LIMIT 100分发
b)将300条结果排序
c)返回前100条
优点:避免了全局排序,只对小量记录进行排序
优化方案二:模糊查询
a)业务上:禁止查询XX页之后的数据
b)业务上:允许模糊返回 => 第100页数据的精确性真这么重要么?
优化方案三:终极方案,查询改写与两段查询
方案一和方案二在业务上都有所折衷,前者不允许跨页查询,后者数据精度有损失,解决夸库分页问题的终极方案是,将order by + offset + limit进行查询改写,分两段查询。
由于wot2015大会时间优先,这个方案待到dtcc2015数据库大会上,58同城的架构师再与大家细讲
五、总结
《概念》
单库、分片、复制、分组
《常见问题及解决思路》
1)可用性,解决思路是冗余(复制)
2)读写比
2.1)读多些少:用从库,缓存,索引来提高读性能

2.2)业务层控制强制读主来解决从库不一致问题

2.3)双淘汰来解决缓存不一致问题

2.4)读写相近,写多读少:不要使用缓存,该怎么整怎么整
3)无缝导库
3.1)写日志追数据

3.2)双写
4)数据量大,解决思路是分片(拆库)
《四大类拆库思路》
1)用户库,“单key”场景使用“单key”拆库
2)帖子库,“1对多”场景使用“1”分库,例如帖子库1个uid对应多个tid,则使用uid分库,tid生成时加入分库标记
3)好友库,“多对多”场景,使用数据冗余方案,多份数据使用多种分库手段
4)订单库,“多key”场景一般有两种方案
4.1)方案一,使用2和3综合的方案

4.2)方案二,1%的请求采用多库查询
《拆库后业务实战》
1)不这么玩:联合查询、子查询、触发器、用户自定义函数、夸库事务
2)IN查询怎么玩
2.1)分发MR

2.2)拼装成不同SQL语句
3)非partition key查询怎么玩
3.1)定位一个库

3.2)分发MR
4)夸库分页怎么玩
4.1)修改sql语句,服务内排序

4.2)引入特殊id,减少返回数量

4.3)业务优化,禁止跨页查询,允许模糊查询
4.4)终极方案,dtcc2015数据库大会揭晓