【Hadoop Summit Tokyo 2016】Apache Hive在完全支持SQL规范上取的主要进步

简介: 本讲义出自Pengcheng Xiong与Ashutosh Chauhan在Hadoop Summit Tokyo 2016上的演讲,主要分享了SQL 2011规范的关键字以及保留关键字、主键和外键以及集合操作等,并分享了当前Apache Hive在完全支持SQL规范上取的主要进步。

本讲义出自Pengcheng Xiong与Ashutosh Chauhan在Hadoop Summit Tokyo 2016上的演讲,主要分享了SQL 2011规范的关键字以及保留关键字、主键和外键以及集合操作等,并分享了当前Apache Hive在完全支持SQL规范上取的主要进步。

39e2de2003dd3b22c78047cb48fbb88a8c1ae537

58d1ed4ea281d34430496af6eb209aa047831f06

1dd8a52d2e03dfa4c0d1c090c1ee0d494a41964f

bc5c4cead81c2caa6b4c150cb559fff480e72294

830a9875ced4bb726ad3e26ab2a47c5557867c89

1a88e4ca5932180be630de96c8fa8c034be6d164

7f6faf9ab1caeebc882fc646cb9c2ce4a3f44f9a

7a7fee1e7a37bbc28470fee4e1962043e391785f

6f3eba69f66ac48570b0f74d9cd8d7cc2b58bed6

a870b118e8c2a0e385f2272dc89687f7cd4bb4b3

864a2d6edbbe909b4e1f7f5ebc4b4b7cd011240a

eb345c23190259673e14e46bde20d06172cb90e2

b743d79fb4dbba5ba94b2bc64f24a04a8fb190a1

077993e03f38679615423b5d4afa2cdf242d47cf

180c16066f9e78c30af943f6d20cc9a9140382f1

d00c49f7957b8119681b39848e6546bb96b07f1a

b3b51c46efbb998a2f1c9d6d74447b741f11819d

1963e811e4c26e452ba9a6a0d18a24312ba7065b

dc3ee01390b21c4f186f15ae35cbab402d64a934

00b2f5b5641aecb02444c29a38b7985eba629731

f2b90d59cc8b37bfe6eac2526c6d8512bda13ab8

e1ac6e0839a0b4a647a0a821f590b87da233dffe

ed1972224d5a9b4ea3c3b8b1a008369fe37ce780

70390a2a7749c619c947eeb5ac8575d1a30bb8ee

d27fd1cd650507ee9995179e5cf6df8ca71c8e9f

ebb61c78b3d8872908a861e5ea0752c35b97a054

d16edb2057f2a6d7db05ff3dfee18ab6f439e0ca

a5987103fbf5fe89ef7a39c70fde18dacd5d4892

73c82ae1a9c92f597f5583dddd66c0c7a5f9d0ab

4e948bb77a72b19473db0fa7b4709681e7f3b454

73683e24e1c396bf7fe5a278f84436320340f771

c703dd9d9d306da60e7d805f817bcaca7788c461

1ee9edcc8ab3a9e3d4b55eb153602fd722fb5926


相关文章
|
SQL 分布式计算 资源调度
Dataphin功能Tips系列(48)-如何根据Hive SQL/Spark SQL的任务优先级指定YARN资源队列
如何根据Hive SQL/Spark SQL的任务优先级指定YARN资源队列
636 4
|
SQL 分布式计算 Hadoop
Apache Hive 帮助文档
Apache Hive 帮助文档
1075 9
|
SQL 分布式计算 关系型数据库
Hadoop-21 Sqoop 数据迁移工具 简介与环境配置 云服务器 ETL工具 MySQL与Hive数据互相迁移 导入导出
555 3
|
SQL 分布式计算 Hadoop
手把手的教你搭建hadoop、hive
手把手的教你搭建hadoop、hive
1357 1
|
SQL 分布式计算 Hadoop
Hadoop-19 Flume Agent批量采集数据到HDFS集群 监听Hive的日志 操作则把记录写入到HDFS 方便后续分析
487 2
|
SQL 分布式计算 Java
大数据-96 Spark 集群 SparkSQL Scala编写SQL操作SparkSQL的数据源:JSON、CSV、JDBC、Hive
582 0
|
SQL 分布式计算 关系型数据库
Hadoop-24 Sqoop迁移 MySQL到Hive 与 Hive到MySQL SQL生成数据 HDFS集群 Sqoop import jdbc ETL MapReduce
559 0
|
人工智能 数据处理 API
阿里云、Ververica、Confluent 与 LinkedIn 携手推进流式创新,共筑基于 Apache Flink Agents 的智能体 AI 未来
Apache Flink Agents 是由阿里云、Ververica、Confluent 与 LinkedIn 联合推出的开源子项目,旨在基于 Flink 构建可扩展、事件驱动的生产级 AI 智能体框架,实现数据与智能的实时融合。
1727 6
阿里云、Ververica、Confluent 与 LinkedIn 携手推进流式创新,共筑基于 Apache Flink Agents 的智能体 AI 未来
|
存储 Cloud Native 数据处理
从嵌入式状态管理到云原生架构:Apache Flink 的演进与下一代增量计算范式
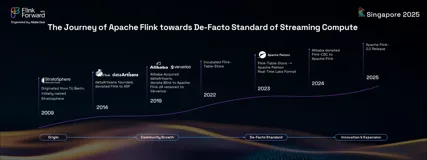
本文整理自阿里云资深技术专家、Apache Flink PMC 成员梅源在 Flink Forward Asia 新加坡 2025上的分享,深入解析 Flink 状态管理系统的发展历程,从核心设计到 Flink 2.0 存算分离架构,并展望未来基于流批一体的通用增量计算方向。
844 0
从嵌入式状态管理到云原生架构:Apache Flink 的演进与下一代增量计算范式
|
SQL 人工智能 数据挖掘
Apache Flink:从实时数据分析到实时AI
Apache Flink 是实时数据处理领域的核心技术,历经十年发展,已从学术项目成长为实时计算的事实标准。它在现代数据架构中发挥着关键作用,支持实时数据分析、湖仓集成及实时 AI 应用。随着 Flink 2.0 的发布,其在流式湖仓、AI 驱动决策等方面展现出强大潜力,正推动企业迈向智能化、实时化的新阶段。
1424 9
Apache Flink:从实时数据分析到实时AI

推荐镜像

更多