Elasticsearch 集群架构
Elasticsearch 是一个非常著名的开源搜索和分析系统,目前被广泛应用于互联网多种领域中,尤其是以下三个领域特别突出。一是搜索领域,相对于 solr,真正的后起之秀,成为很多搜索系统的不二之选。二是 Json 文档数据库,相对于 MongoDB,读写性能更佳,而且支持更丰富的地理位置查询以及数字、文本的混合查询等。三是时序数据分析处理,目前是日志处理、监控数据的存储、分析和可视化方面做得非常好,可以说是该领域的引领者了。
Elasticsearch 的详细介绍可以到官网查看。我们先来看一下 Elasticsearch 中几个关键概念:
 节点(Node):物理概念,一个运行的 Elasticearch 实例,一般是一台机器上的一个进程。
索引(Index),逻辑概念,包括配置信息 mapping 和倒排正排数据文件,一个索引的数据文件可能会分布于一台机器,也有可能分布于多台机器。索引的另外一层意思是倒排索引文件。
分片(Shard):为了支持更大量的数据,索引一般会按某个维度分成多个部分,每个部分就是一个分片,分片被节点 (Node) 管理。一个节点 (Node) 一般会管理多个分片,这些分片可能是属于同一份索引,也有可能属于不同索引,但是为了可靠性和可用性,同一个索引的分片尽量会分布在不同节点 (Node) 上。分片有两种,主分片和副本分片。
副本(Replica):同一个分片 (Shard) 的备份数据,一个分片可能会有0个或多个副本,这些副本中的数据保证强一致或最终一致。
用图形表示出来可能是这样子的:
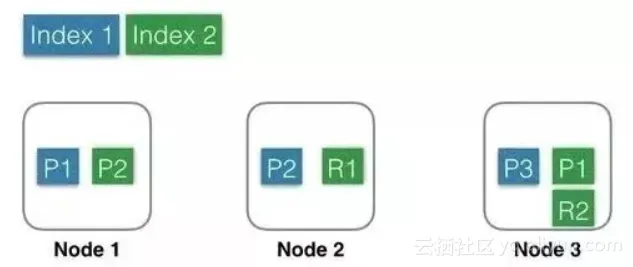
Index 1:蓝色部分,有3个 shard,分别是 P1,P2,P3,位于3个不同的 Node 中,这里没有 Replica。
Index 2:绿色部分,有2个 shard,分别是P1,P2,位于2个不同的 Node 中。并且每个 shard 有一个 replica,分别是 R1 和 R2。基于系统可用性的考虑,同一个 shard 的 primary 和 replica 不能位于同一个 Node 中。这里 Shard1 的 P1 和 R1 分别位于 Node3 和 Node2 中,如果某一刻 Node2 发生宕机,服务基本不会受影响,因为还有一个 P1 和 R2 都还是可用的。因为是主备架构,当主分片发生故障时,需要切换,这时候需要选举一个副本作为新主,这里除了会耗费一点点时间外,也会有丢失数据的风险。
Index 流程
建索引(Index)的时候,一个 Doc 先是经过路由规则定位到主 Shard,发送这个 doc到主 Shard 上建索引,成功后再发送这个 Doc 到这个 Shard 的副本上建索引,等副本上建索引成功后才返回成功。
在这种架构中,索引数据全部位于 Shard 中,主 Shard 和副本 Shard 各存储一份。当某个副本 Shard 或者主 Shard 丢失(比如机器宕机,网络中断等)时,需要将丢失的 Shard 在其他 Node 中恢复回来,这时候就需要从其他副本(Replica)全量拷贝这个 Shard 的所有数据到新 Node 上构造新 Shard。这个拷贝过程需要一段时间,这段时间内只能由剩余主副本来承载流量,在恢复完成之前,整个系统会处于一个比较危险的状态,直到 failover 结束。
这里就体现了副本(Replica)存在的一个理由,避免数据丢失,提高数据可靠性。副本(Replica)存在的另一个理由是读请求量很大的时候,一个 Node 无法承载所有流量,这个时候就需要一个副本来分流查询压力,目的就是扩展查询能力。
角色部署方式
接下来再看看角色分工的两种不同方式:
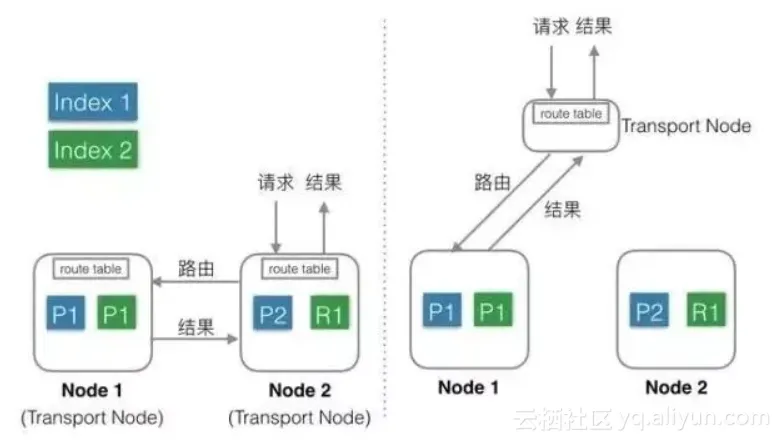
Elasticsearch 支持上述两种方式:
混合部署(左图):
默认方式。
不考虑 MasterNode 的情况下,还有两种 Node,Data Node 和 Transport Node,这种部署模式下,这两种不同类型 Node 角色都位于同一个 Node 中,相当于一个Node 具备两种功能:Data 和 Transport。
当有 index 或者 query 请求的时候,请求随机(自定义)发送给任何一个 Node,这台 Node 中会持有一个全局的路由表,通过路由表选择合适的 Node,将请求发送给这些 Node,然后等所有请求都返回后,合并结果,然后返回给用户。一个 Node 分饰两种角色。
好处就是使用极其简单,易上手,对推广系统有很大价值。最简单的场景下只需要启动一个 Node,就能完成所有的功能。
缺点就是多种类型的请求会相互影响,在大集群如果某一个 Data Node 出现热点,那么就会影响途经这个 Data Node 的所有其他跨 Node 请求。如果发生故障,故障影响面会变大很多。
Elasticsearch 中每个 Node 都需要和其余的每一个 Node 都保持13个连接。这种情况下,每个 Node 都需要和其他所有 Node 保持连接,而一个系统的连接数是有上限的,这样连接数就会限制集群规模。
还有就是不能支持集群的热更新。
分层部署(右图):
通过配置可以隔离开 Node。
设置部分 Node 为 Transport Node,专门用来做请求转发和结果合并。
缺点是上手复杂,需要提前设置好 Transport 的数量,且数量和 Data Node、流量等相关,否则要么资源闲置,要么机器被打爆。
好处就是角色相互独立,不会相互影响,一般 Transport Node 的流量是平均分配的,很少出现单台机器的 CPU 或流量被打满的情况,而 DataNode 由于处理数据,很容易出现单机资源被占满,比如 CPU,网络,磁盘等。独立开后,DataNode如果出了故障只是影响单节点的数据处理,不会影响其他节点的请求,影响限制在最小的范围内。
角色独立后,只需要 Transport Node 连接所有的 DataNode,而 DataNode 则不需要和其他 DataNode 有连接。一个集群中DataNode的数量远大于 Transport Node,这样集群的规模可以更大。另外,还可以通过分组,使 Transport Node 只连接固定分组的 DataNode,这样 Elasticsearch 的连接数问题就彻底解决了。
可以支持热更新:先一台一台的升级 DataNode,升级完成后再升级 Transport Node,整个过程中,可以做到让用户无感知。
上面介绍了 Elasticsearch 的部署层架构,不同的部署方式适合不同场景,需要根据自己的需求选择适合的方式。
Elasticsearch 数据层架构
接下来我们看看当前 Elasticsearch 的数据层架构。
数据存储
Elasticsearch 的 Index 和 meta,目前支持存储在本地文件系统中,同时支持 niofs,mmap,simplefs,smb 等不同加载方式,性能最好的是直接将索引 LOCK 进内存的 MMap 方式。默认,Elasticsearch 会自动选择加载方式,另外可以自己在配置文件中配置。这里有几个细节,具体可以看官方文档。
索引和 meta 数据都存在本地,会带来一个问题:当某一台机器宕机或者磁盘损坏的时候,数据就丢失了。为了解决这个问题,可以使用 Replica(副本)功能。
副本(Replica)
可以为每一个 Index 设置一个配置项:副本(Replicda)数,如果设置副本数为2,那么就会有3个 Shard,其中一个是 PrimaryShard,其余两个是 ReplicaShard,这三个 Shard 会被 Mater 尽量调度到不同机器,甚至机架上,这三个 Shard 中的数据一样,提供同样的服务能力。
副本(Replica)的目的有三个:
保证服务可用性:当设置了多个 Replica 的时候,如果某一个 Replica 不可用的时候,那么请求流量可以继续发往其他 Replica,服务可以很快恢复开始服务。
保证数据可靠性:如果只有一个 Primary,没有 Replica,那么当 Primary 的机器磁盘损坏的时候,那么这个 Node 中所有 Shard 的数据会丢失,只能 reindex 了。
提供更大的查询能力:当 Shard 提供的查询能力无法满足业务需求的时候, 可以继续加N个 Replica,这样查询能力就能提高N倍,轻松增加系统的并发度。
问题
上面说了一些优势,这种架构同样在一些场景下会有些问题。
Elasticsearch 采用的是基于本地文件系统,使用 Replica 保证数据可靠性的技术架构,这种架构一定程度上可以满足大部分需求和场景,但是也存在一些遗憾:
Replica带来成本浪费。为了保证数据可靠性,必须使用 Replica,但是当一个 Shard 就能满足处理能力的时候,另一个 Shard 的计算能力就会浪费。
Replica 带来写性能和吞吐的下降。每次 Index 或者 update 的时候,需要先更新Primary Shard,更新成功后再并行去更新 Replica,再加上长尾,写入性能会有不少的下降。
当出现热点或者需要紧急扩容的时候动态增加 Replica 慢。新 Shard 的数据需要完全从其他 Shard 拷贝,拷贝时间较长。
上面介绍了 Elasticsearch 数据层的架构,以及副本策略带来的优势和不足,下面简单介绍了几种不同形式的分布式数据系统架构。
分布式系统
第一种:基于本地文件系统的分布式系统
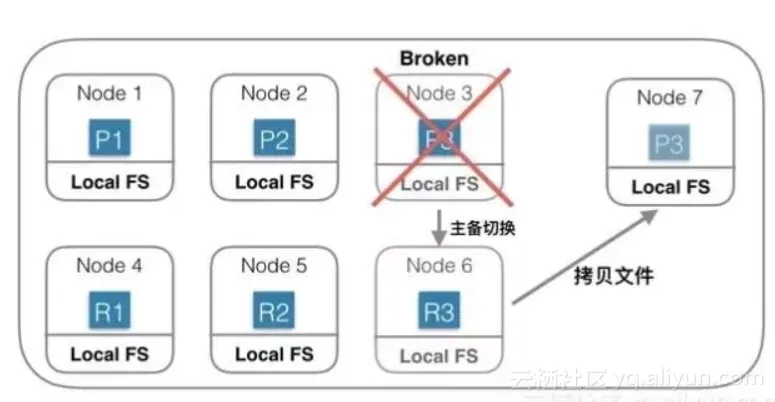
上图中是一个基于本地磁盘存储数据的分布式系统。Index 一共有3个 Shard,每个 Shard 除了 Primary Shard 外,还有一个 Replica Shard。当 Node 3 机器宕机或磁盘损坏的时候,首先确认 P3 已经不可用,重新选举 R3 位 Primary Shard,此 Shard 发生主备切换。然后重新找一台机器 Node 7,在 Node7 上重新启动 P3 的新 Replica。由于数据都会存在本地磁盘,此时需要将 Shard 3 的数据从 Node 6 上拷贝到 Node7 上。如果有 200G 数据,千兆网络,拷贝完需要1600秒。如果没有 replica,则这1600秒内这些 Shard 就不能服务。
为了保证可靠性,就需要冗余 Shard,会导致更多的物理资源消耗。
在这种架构中,如果你的数据是在其他存储系统中生成的,比如 HDFS/HBase,那么你还需要一个数据传输系统,将准备好的数据分发到相应的机器上。
这种架构中为了保证可用性和可靠性,需要双集群或者 Replica 才能用于生产环境,优势和副作用在上面介绍 Elasticsearch 的时候已经介绍过了,这里就就不赘述了。
Elasticsearch 使用的就是这种架构方式。
第二种:基于分布式文件系统的分布式系统(共享存储)
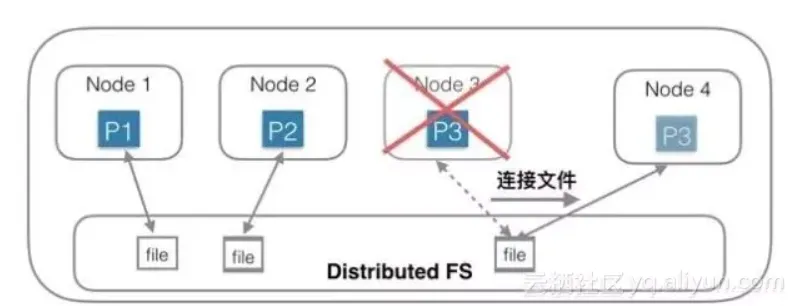
针对第一种架构中的问题,另一种思路是:存储和计算分离。
第一种思路的问题根源是数据量大,拷贝数据耗时多,那么有没有办法可以不拷贝数据?为了实现这个目的,一种思路是底层存储层使用共享存储,每个 Shard 只需要连接到一个分布式文件系统中的一个目录/文件即可,Shard 中不含有数据,只含有计算部分。相当于每个 Node 中只负责计算部分,存储部分放在底层的另一个分布式文件系统中,比如 HDFS。
上图中,Node 1 连接到第一个文件;Node 2 连接到第二个文件;Node3 连接到第三个文件。当 Node 3 机器宕机后,只需要在 Node 4 机器上新建一个空的 Shard,然后构造一个新连接,连接到底层分布式文件系统的第三个文件即可,创建连接的速度是很快的,总耗时会非常短。
这种是一种典型的存储和计算分离的架构,优势有以下几个方面:
在这种架构下,资源可以更加弹性,当存储不够的时候只需要扩容存储系统的容量;当计算不够的时候,只需要扩容计算部分容量。
存储和计算是独立管理的,资源管理粒度更小,管理更加精细化,浪费更少,结果就是总体成本可以更低。
负载更加突出,抗热点能力更强。一般热点问题基本都出现在计算部分,对于存储和计算分离系统,计算部分由于没有绑定数据,可以实时的扩容、缩容和迁移,当出现热点的时候,可以第一时间将计算调度到新节点上。
这种架构同时也有一个不足:
访问分布式文件系统的性能可能不及访问本地文件系统。在上一代分布式文件系统中,这是一个比较明显的问题,但是目前使用了各种用户态协议栈后,这个差距已经越来越小了。
HBase 使用的就是这种架构方式。
Solr 也支持这种形式的架构。
总结
上述两种架构,各有优势和不足,对于某些架构中的不足或缺陷,思路不同,解决的方案也大相径庭,但是思路跨度越大,收益一般也越大。
上面只是介绍了分布式数据(存储/搜索/分析等等)系统在存储层的两种不同架构方式,希望能对大家有用。但是分布式系统架构设计所涉及的内容广,细节多,权衡点众,如果大家对某些领域或者方面有兴趣,也可以留言,后面再探讨。