一、Hadoop部署模式
单机模式:默认情况下运行为一个单独机器上的独立Java进程,主要用于调试环境
伪分布模式:在单个机器上模拟成分布式多节点环境,每一个Hadoop守护进程都作为一个独立的Java进程运行
完全分布式模式:真实的生产环境,搭建在完全分布式的集群环境
二、添加用户和组
|
1
2
|
$
sudo
adduser hadoop
##创建用户hadoop
$
sudo
usermod
-G
sudo
hadoop
##将hadoop用户添加进sudo用户组
|
三、安装相关软件
|
1
2
3
4
|
$
sudo
apt-get update
$
sudo
apt-get -y
install
openssh-server
rsync
openjdk-7-jdk
$
sudo
service
ssh
restart
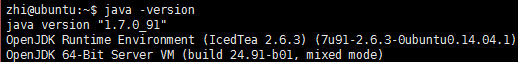
$ java -version
|
四、配置SSH免密登录
|
1
2
3
4
|
$
su
-l hadoop
##切换至hadoop用户
$
ssh
-keygen -t rsa -P
""
##配置SSH免密登录
$
cat
~/.
ssh
/id_rsa
.pub >> ~/.
ssh
/authorized_keys
##将公钥追加到authorized_keys中
$
ssh
localhost
##验证
|
五、Hadoop配置
①下载安装Hadoop
|
1
2
3
4
|
$
su
-l hadoop
$ wget http:
//apache
.fayea.com
/hadoop/common/hadoop-2
.7.1
/hadoop-2
.7.1.
tar
.gz
$
tar
-zxvf hadoop-2.7.1.
tar
.gz
$
sudo
mv
hadoop-2.7.1
/usr/local/hadoop
|

②配置Hadoop
a.添加环境变量
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
|
$
vi
/home/hadoop/
.bashrc
#HADOOP START
export
JAVA_HOME=
/usr/lib/jvm/java-7-openjdk-amd64
export
HADOOP_INSTALL=
/usr/local/hadoop/
export
PATH=$PATH:$HADOOP_INSTALL
/bin
export
PATH=$PATH:$HADOOP_INSTALL
/sbin
export
HADOOP_MAPRED_HOME=$HADOOP_INSTALL
export
HADOOP_COMMON_HOME=$HADOOP_INSTALL
export
HADOOP_HDFS_HOME=$HADOOP_INSTALL
export
YARN_HOME=$HADOOP_INSTALL
export
HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_INSTALL
/lib/native
export
HADOOP_OPTS=
"-Djava.library.path=$HADOOP_INSTALL/lib"
#HADOOP END
$ .
/home/hadoop/
.bashrc
##重载使其生效
|

六、测试
①创建输入数据
|
1
2
3
4
|
$
su
-l hadoop
$
cd
/usr/local/hadoop
$
sudo
mkdir
input
$
sudo
cp
/etc/passwd
input/
|
②执行Hadoop WordCount应用(词频统计)
|
1
|
$ bin
/hadoop
jar share
/hadoop/mapreduce/sources/hadoop-mapreduce-examples-2
.7.1-sources.jar org.apache.hadoop.examples.WordCount input output
|

③查看生成的单词统计数据
|
1
2
3
4
|
$ hadoop dfs -
ls
output
-rw-r--r-- 1 hadoop hadoop 0 2015-12-18 13:18 output
/_SUCCESS
-rw-r--r-- 1 hadoop hadoop 2128 2015-12-18 13:18 output
/part-r-00000
$ hadoop dfs -
cat
output/*
|
附:
配置单节点Hadoop的文档:http://hadoop.apache.org/docs/r2.7.1/hadoop-project-dist/hadoop-common/SingleCluster.html#Standalone_Operation
本文转自 结束的伤感 51CTO博客,原文链接:http://blog.51cto.com/wangzhijian/1765696