来一个可能防止恶意采集和爬虫的SH

简介:

没办法,公司的要求,还有,一些山寨爬虫完全不够我们运维人员的感觉,

一天爬虫搞个三四十万的LOG,那我只好干了。。

人家GOOGLE,BAIDU,一天大约也就五六千吧。。

有一个小的SSH技巧,是判断SSH命令执行成功与否,是否有返回值,不用IF,而直接用||和&&。

~~~~~~~~~~~~~~~~~~~~~

$?变量会被赋值为0,反之,赋值为-1。通过判断$?变量的方式确实可以满足我们的要求,但是需要用if判断,要写脚本,比较繁琐,有没有比较方便的命令呢。哈,肯定有的噻。

shell中还提供了快捷操作符: && 和 ||

// 此时存在/tmp/xxxx文件,执行了&&后面的命令
# ls /tmp/xxxx && echo '/tmp/xxxx exits'
/tmp/xxxx
/tmp/xxxx exits

// 此时存在/tmp/xxxx文件,不执行 || 后面的命令
# ls /tmp/xxxx || echo '/tmp/xxxx exits'
/tmp/xxxx

我们对上例可以这么分析,&& 签名的命令执行成功就执行后面的命令,|| 前面的命令执行失败才执行后面的命令。

~~~~~~~~~~
复制代码
#/bin/sh

time_inter_minute=50000
alert_count=85000000
head_count=20
log_path="/xxx/xxx/log.log"
last_time=`date "-d -${time_inter_minute} minute" '+%d/%b/%G:%H:%M:%S'`

now_time=`date '+%d/%b/%G:%H:%M:%S'`
now_time_str="[${now_time}"
last_time_str="[${last_time}"
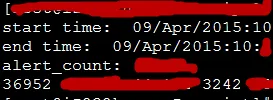
echo "start time: " $last_time
echo "end time: " $now_time
echo "alert_count: " $alert_count

shell_out=`awk -v a=$last_time_str -v b=$now_time_str '$4 > a && $4 < b' $log_path|awk '{print $1}'|sort |uniq -c | sort -nr|head -10`
arra=($shell_out)
echo ${arra[@]}

for i in "${!arra[@]}"; do
    if [ `expr $i \% 2` -eq 0 ] ;then
    if [ ${arra[$i]} -gt $alert_count ] && [ ${arra[$i+1]} != "xx.xx.xx.xx" ] ; then
        /sbin/iptables -vnL|grep ${arra[$i+1]} && echo ${arra[$i+1]} "have added"
        /sbin/iptables -vnL|grep ${arra[$i+1]} || /sbin/iptables -I INPUT -s ${arra[$i+1]} -j DROP
    fi
    fi
done
复制代码

这个IP好过分哟

目录
相关文章
|
数据采集 Web App开发 JavaScript
JavaScript爬虫进阶攻略:从网页采集到数据可视化
|
数据采集 数据挖掘 API
主流电商平台数据采集API接口|【Python爬虫+数据分析】采集电商平台数据信息采集
随着电商平台的兴起,越来越多的人开始在网上购物。而对于电商平台来说,商品信息、价格、评论等数据是非常重要的。因此,抓取电商平台的商品信息、价格、评论等数据成为了一项非常有价值的工作。本文将介绍如何使用Python编写爬虫程序,抓取电商平台的商品信息、价格、评论等数据。 当然,如果是电商企业,跨境电商企业,ERP系统搭建,我们经常需要采集的平台多,数据量大,要求数据稳定供应,有并发需求,那就需要通过接入电商API数据采集接口,封装好的数据采集接口更方便稳定高效数据采集。
|
数据采集 XML 存储
Python爬虫实战:一键采集电商数据,掌握市场动态!
这个爬虫还挺实用,不光能爬电商数据,改改解析规则,啥数据都能爬。写爬虫最重要的是要有耐心,遇到问题别着急,慢慢调试就成。代码写好了,运行起来那叫一个爽,分分钟几千条数据到手。
|
数据采集 存储 安全
利用爬虫技术自动化采集汽车之家的车型参数数据
汽车之家是一个专业的汽车网站,提供了丰富的汽车信息,包括车型参数、图片、视频、评测、报价等。如果我们想要获取这些信息,我们可以通过浏览器手动访问网站,或者利用爬虫技术自动化采集数据。本文将介绍如何使用Python编写一个简单的爬虫程序,实现对汽车之家的车型参数数据的自动化采集,并使用亿牛云爬虫代理服务来提高爬虫的稳定性和效率。
1498 0
利用爬虫技术自动化采集汽车之家的车型参数数据
|
数据采集 存储 分布式计算
Nutch爬虫在大数据采集中的应用案例
Nutch爬虫在大数据采集中的应用案例
|
数据采集 XML 编译器
Scala爬虫实战:采集网易云音乐热门歌单数据
|
数据采集 Python
Python爬虫系列14-采集JD商城百万商品数据详情
有时候不能什么都听别人的,更不能因为别人的意见而打乱了自己原有的计划。学习亦是如此。 自己要学会为自己负责,不要听别人说什么就是什么。如果真是那样,那么你自己的人生会过得非常的不好,会一团糟。别人的只是建议,最终还是由自己决定。
Python爬虫系列14-采集JD商城百万商品数据详情
|
数据采集 Python
Python爬虫系列13-采集快手短视频官网数据
读书不是唯一出路,但学习一定是。 有些人忙碌的活着,有些人努力的拼搏,有些人随意挥霍青春,人生百态,各有不同。
1374 0
Python爬虫系列13-采集快手短视频官网数据
|
存储 数据采集 Web App开发
Python爬虫系列2-采集2022年拉钩网最新的IT岗位招聘数据
2022年转眼已过半,再过半年即将迎来2023年,我坚信疫情早晚会过去,2023年相信会是一个互联网全新的时代:物联网时代,古语云:十年磨一剑,古时候烽火传递、飞鸽传书,交流信息很不方便。古人就幻想着有千里眼和顺风耳。能看到千里之外的地方和听到很远地方的声音。从2000年至2010年这十年,古人的愿望变成了现实;我们见证了全智能手机的发展历程;以及2010年至2020年的移动互联网从早期的2G网络过渡至3G到现在的4G网络甚至到目前已经慢慢普及但尚未成熟的5G网络的发展历程;我们也坚信未来的万物互联距离现如今的我们也并不是一件很遥远的事情。 如果本文对你有些帮助-还请点赞👍关注!
Python爬虫系列2-采集2022年拉钩网最新的IT岗位招聘数据
|
数据采集 Python
Python爬虫系列19-采集某视频中的弹幕信息
种一棵树最好的时间是十年前,其次是现在。 不管自己想做一件什么样的事情,要么全力以赴,要么果断放弃,明确对生活的态度会让一切变得更好简单。 当我们同时做很多件事情的时候,很有可能一件事情都做不好,倒不如专注的做好一件事,来的更好。
Python爬虫系列19-采集某视频中的弹幕信息