如何将5W和H应用于文本数据!
文本数据无处不在
从文本数据中提取有意义和值得学习的数据是自然语言处理(NLP)的一个非常重要的研究课题。NLP是一个非常大的领域,NLP有几个最常使用的关键应用:
·识别不同的用户/客户群。
·准确的检测和提取不同类别的反馈。
·根据意图对文本进行分类。
本文将讲解如何从头开始有效地处理这些问题的指南和技巧:首先解释如何构建机器学习解决方案来解决上面提到的问题。然后转向更细致的解决方案,比如特性工程、单词向量和深度学习。
第一步:收集你的数据
每个机器学习问题都始于数据。本文中,我们将使用一个名为“社交媒体上的灾难”的数据集:投稿人查看了超过一万条的推文,然后指出每条推文是否提到了灾难事件。
我们的任务是检测哪些推文是关于灾难事件的,因为有潜在的应用专门收集紧急事件并通知执法部门。这个任务的特殊挑战是两个类都包含用于查找推文的相同搜索条件,所以我们不得不用更微妙的差异来区分它们。
在本文中,我们将有关灾难的推文称为“灾难”,其他推文称为“无关紧要的”。正如Richard Socher所描述的那样,查找和标记足够的数据来训练模型比试图优化复杂的无监督方法通常更快、更简单、更便宜。
第二步:清理你的数据
“你的模型只能和你的数据一样好”。一个干净的数据集能够使模型学习有意义的特征,所以应当是先查看数据然后再清理数据。
以下是用来清理你的数据的清单(详见代码):
1、删除所有不相关的字符,例如任何非字母数字字符。
2、把你的文章分成一个个单独的单词。
3、删除不相关的单词。
4、将所有字符转换为小写。
5、考虑将拼错的单词或拼写单词组合成一个单独的表示。
6、考虑词形化。
在遵循这些步骤并检查额外的错误之后,我们可以开始使用干净的、标记的数据来训练模型!
第三步:找到一个好的数据表示
机器学习模型以数值作为输入。我们的数据集是一个句子的列表,所以为了能够提取数据。我们首先要找到一种方法使我们的算法能理解它:也就是数字列表。
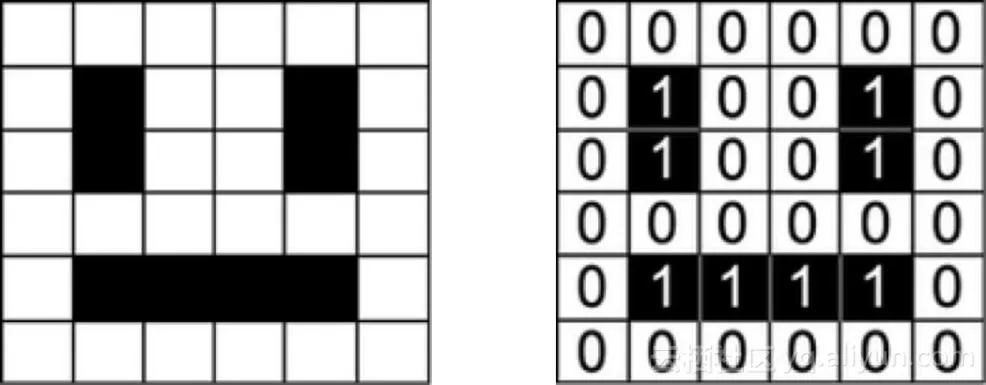
一组以数据矩阵表示的笑脸
独热编码(Bag of Words)
计算机文本表示的一种方法是将每个字符单独编码为一个数字(例如ASCII)。这对于大多数数据集来说是不可能的,所以我们需要更高层次的方法。
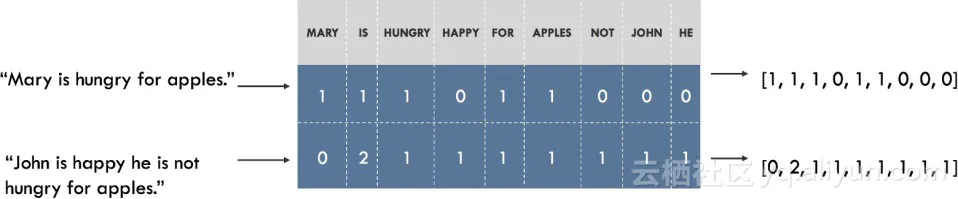
例如,我们可以在我们的数据集中建立一个所有的单词的词汇表,并将一个唯一的索引与词汇表中的每个单词联系起来。每个句子被表示为一个列表,只要我们的词汇表中有不同单词的数量。在这个列表中的每个索引中,我们标记出在我们的句子中出现了多少次给定的单词。这被称为Bag of Words模型,因为它是一种完全无视我们句子中词语顺序的表现形式。
可视化嵌入
为了查看嵌入是否捕获了与我们的问题相关的信息(例如,tweet是否与灾难有关),我们选择可视化并查看这些类这个方法,但是由于词汇表通常非常大,并且在20000个维度中可视化数据是不可能的,像PCA这样的技术将有助于将数据压缩到两个维度。如下图。
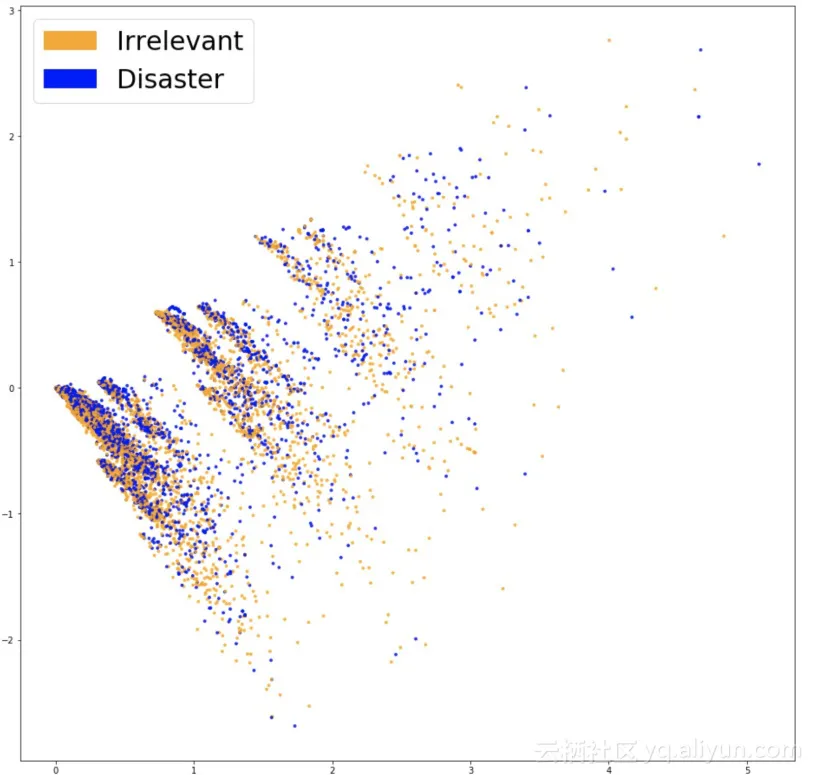
嵌入后这两个类依旧不太好分开,仅仅是降低了维度。为了看Bag of Words特征是否有用,我们根据它们来训练一个分类器。
第四步:分类
当涉及到对数据进行分类时,逻辑回归是最简单可用的工具,训练简单,结果可解释,可以很容易的从模型中提取最重要的系数。将数据分成一个适用于我们的模型和测试集的训练集,以了解它如何推广到不可见的数据。训练结束后得到了75.4%的准确度,虽然这个精度足够满足我们的需求,但是我们还是应该试图去理解它是如何工作的。
第五步:检查
混淆矩阵
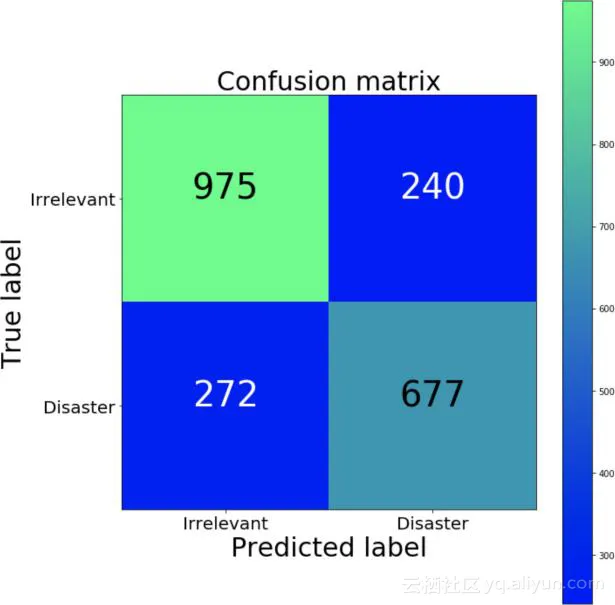
第一步是了解我们模型的错误类型,以及哪种类型的错误是最不可取。在我们的例子中,误报是将不相关的tweet归为灾难,而漏报是将灾难归类为不相关的tweet。如果要优先处理每个潜在的事件,就要降低漏报率,如果受到资源的限制,那么会游戏那考虑降低误报率。将这些信息可视化的一个好方法是使用混淆矩阵,将我们的模型与真实标签的预测相比较。理想情况下,矩阵将是从左上角到右下角的对角线。
混淆矩阵
结果显示该分类器漏报率更高。换句话说,我们的模型最常见的错误是将灾难分类为不相关的。
解释我们的模型
验证我们的模型并解释它的预测结果,重要的是看它使用哪些词作出预测。在数据有偏差时,分类器能在样本数据中做出准确预测,但是这个模型在现实世界中不能很好地推广。在这里,我们为灾难和不相关的推文绘制了最关键的单词表。
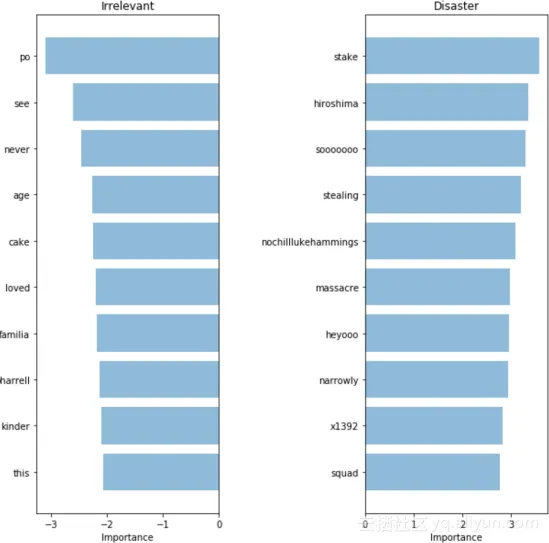
我们分类器的词汇库能够处理大量的词汇。然而,有些词是非常频繁的,而且只会对我们的预测造成干扰。所以接下来,我们将尝试用一种方法来表示能够解释单词频率的句子,看看我们是否能从我们的数据中获得更多的信息。
第六步:掌握词汇结构
TF-IDF
为了帮助我们的模型更多地关注有意义的单词,我们可以在我们的单词模型包上使用TF-IDF评分,下图为新嵌入的PCA投影。
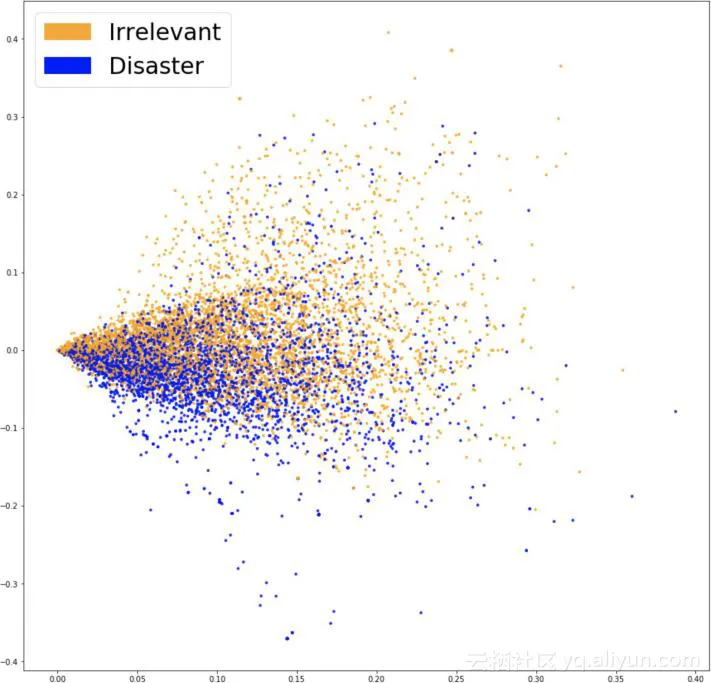
可视化TF-IDF嵌入
我们可以看到这两个颜色之间的区别更明显了,这使我们的分类器更容易区分。我们在新的嵌入式系统上培训另一个逻辑回归,并最终达到了76.2%的精确度。一个轻微的改善,提高了模型的性能,所以我们可以考虑升级这个模型了。
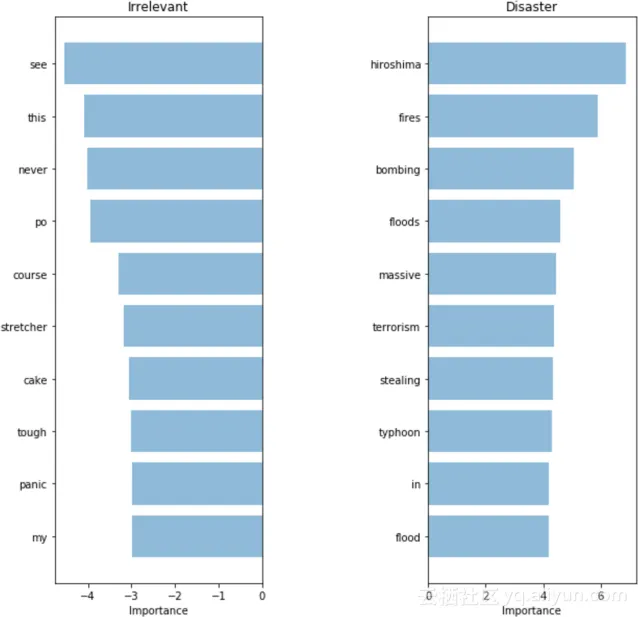
TF-IDF:文字的重要性
第七步:Leveraging semantics
Word2Vec
即使是最新的模型也没法将训练中没有遇到的单词进行分类,哪怕是非常相似的单词。为了解决这个问题,我们所用的工具叫做Word2Vec。
Word2Vec是一种查找单词连续嵌入的技术。它可以从阅读大量的文本中学习,并记住在类似的语境中出现的单词。论文的作者开放了一个在非常大的语料库中预先训练的模型,预先训练的向量可以在与这个帖子相关的存储库中找到。
语句级别的表示
为我们的分类器获得一个句子嵌入的一个快速方法是平均Word2Vec得分。这跟以前一样是Bag of Words的方法,但是这次我们只丢掉句子的语法,同时保留一些语义信息。
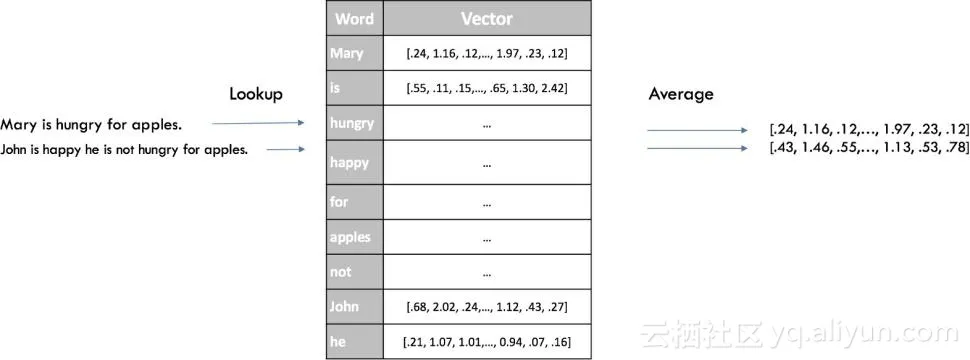
Word2Vec句子嵌入
下图是我们使用以前的技术实现的新嵌入的可视化:

可视化Word2Vec嵌入
在训练了相同的模型三次(逻辑回归)后,我们得到了77.7%的精度分数,这是现阶段得到的最好的结果!
复杂性/ Explainability trade-oG
由于我们的嵌入没有像以前的模型那样被表示为每个单词一维的矢量,所以很难看出哪些单词与我们的分类最相关。虽然我们仍然可以访问我们的逻辑回归的系数,但它们与我们嵌入的300个维度相关,而不是词的索引。然而,对于更复杂的模型,我们可以利用LIME等黑盒解释器来了解我们的分类器如何工作。
LIME
在GitHub上可以获得开源的LIME。它是一种允许用户解释任何分类器决定的黑盒解释器。
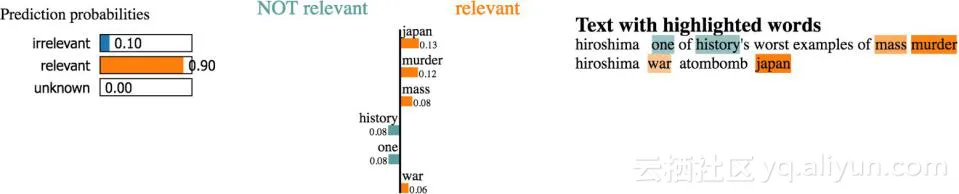
正确的灾难词语被识别为“相关的”
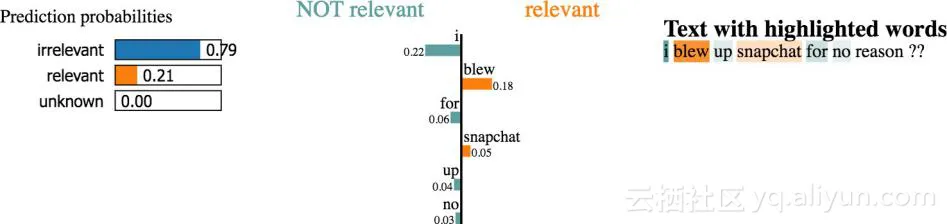
在这里,词语对分类的贡献似乎不那么明显
我们需要在一个有代表性的测试用例上运行LIME,看看那些词最关键,用这种方法可以得到像以前模型一样重要的分数,并验证我们模型的预测结果。
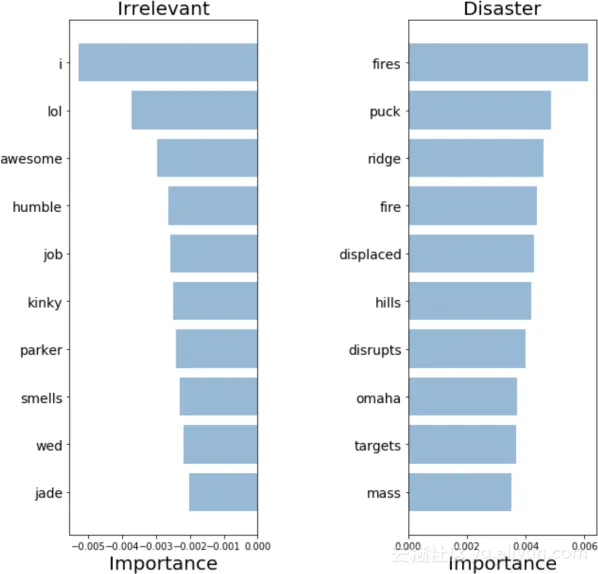
Word2Vec:文字的重要性
由上图可得,这个模型收集了相关性非常高的词,暗示它做出了可以解释的预测结果,所以可以放心的部署到生成中。
第八步:使用端到端的方法来利用语法
由于以上方法省略了单词的顺序,丢弃了句子的句法信息,所以这些方法不能提供足够准确的结果。为此您可以使用更复杂的模型,一种常见的方法是将一个句子作为单个单词向量的序列,使用Word2Vec或者如GloVe、CoVe这样的方法。
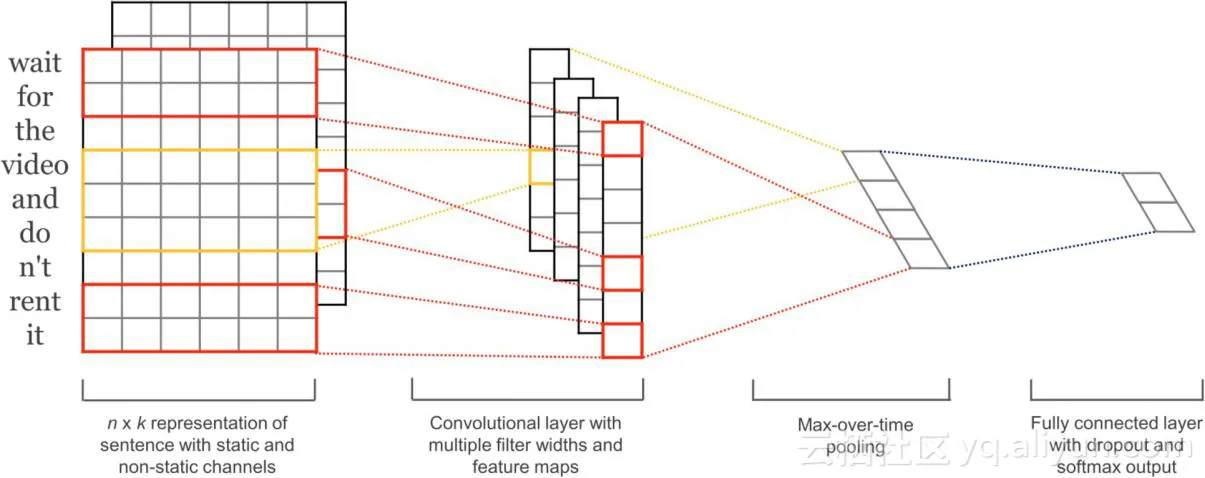
一个高度eGective端到端架构(源)
卷积神经网络用于句子分类的训练非常迅速,并且是入门级的深度学习体系结构。卷积神经网络在文本相关的任务中表现非常出色,而且通常比大多数复杂的NLP方法(例如LSTMs和编码器/解码架构)要快得多。这个模型保存了单词的顺序,并学习了有价值的信息,其中的单词序列可以预测我们的目标类。训练这个模型不会比之前的方法麻烦,并且能获得79.5%的准确性。所以下一步应该是使用我们描述的方法来探索和解释预测,以验证它确实是部署到用户的最佳模型。
本文由北邮@爱可可-爱生活 老师推荐,阿里云云栖社区组织翻译。
文章原标题《How to solve 90% of NLP problems: a step-by-step guide》
作者:Emmanuel Ameisen
译者:奥特曼,审校:袁虎。
文章为简译,更为详细的内容,请查看原文