前言
之前对于并发这一块确实接触的比较少,自从遇到现在的老大,每写完一块老大都会过目一下然后给出意见,期间确实收获不少,接下来有几篇会来讲解SQL Server中关于并发这一块的内容,有的是总结,有的是学习,若有错误见解请批评性指出。
SQL Server并发处理队列数据问题
在我们的项目中对于购买产品的用户会对应分配卡密,同时会更新其卡密的状态为已使用,所以当出现并发时此时我们不加以控制会导致同一个卡号和密码被不同的用户所使用,这样的情况是不能允许的,此时我们迫切需要解决对卡密使用后的更新和产生的并发。所以有了此文的产生。我们接下来来创建测试表。
CREATE TABLE Test (
  Id    INT IDENTITY(1, 1) NOT NULL PRIMARY KEY,
  Other VARCHAR(100))

GO
接下来我们插入十条测试数据
DECLARE  @counter INT

SELECT @counter = 1

WHILE (@counter <= 10)
  BEGIN
    INSERT INTO Test
               (Other)
    SELECT 'other action' + CAST(@counter AS VARCHAR)

    SELECT @counter = @counter + 1
  END

接下来我们打开两个会话运行如下SQL语句:
DECLARE @queueid INT

BEGIN TRAN TRAN1

SELECT TOP 1 @queueid = Id
FROM Test

PRINT 'processing queueid # ' + CAST(@queueid AS VARCHAR)

WAITFOR DELAY '00:00:10'

DELETE FROM Test
WHERE Id = @queueid

COMMIT
此时我们看到打开的两个会话会同时处理相同的行。

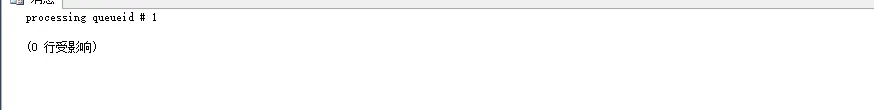
如上则不是我们想要的结果,此时我们再来在如上基础上加一个更新锁,然后SQL Server查询引擎会不允许其他读取者来获取更新锁,此时将能够有效的处理对应对应的行记录,但是会造成阻塞,如下:
DECLARE @queueid INT

BEGIN TRAN TRAN1

SELECT TOP 1 @queueid = Id
FROM Test WITH (updlock)

PRINT 'processing queueid # ' + CAST(@queueid AS VARCHAR)

WAITFOR DELAY '00:00:10'

DELETE FROM Test
WHERE Id = @queueid

COMMIT
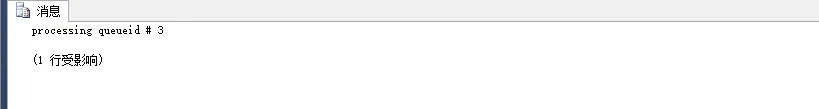

上述虽然能解决更新问题,但是此时会造成阻塞,一旦并发量比较大此时将造成长时间阻塞,当前正在执行的更新会话必须等待另外一个更新会话执行完毕同时释放更新锁。此时为了解决阻塞问题,在SQL Server中通过添加READPAST关键字来告诉SQL Server引擎一旦遇到被锁住的行,你就跳过吧不用理会,所以不会再造成阻塞问题。此时最终的代码将变成如下:
DECLARE @queueid INT

BEGIN TRAN TRAN1

SELECT TOP 1 @queueid = Id
FROM Test WITH (updlock)

BEGIN TRAN TRAN1

SELECT TOP 1 @queueid = Id
FROM Test WITH (UPDLOCK, READPAST)

PRINT 'processing queueid # ' + CAST(@queueid AS VARCHAR)

WAITFOR DELAY '00:00:10'

DELETE FROM Test
WHERE Id = @queueid

COMMIT

PRINT 'processing queueid # ' + CAST(@queueid AS VARCHAR)

WAITFOR DELAY '00:00:10'

DELETE FROM Test
WHERE Id = @queueid

COMMIT
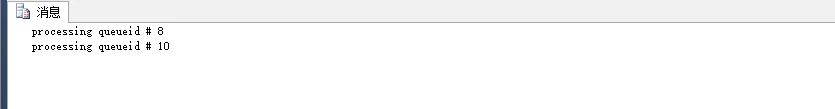
通过UPDLOCK+READPAST结合使用将对于处理并发更新时,就像处理队列数据一样,但是不会造成阻塞,此时将给予我们最好的性能。我们结合上述所讲,来查询出数据并删除对应数据且,不会出现重复删除情况且不会导致阻塞,此时代码将变成如下:
SET NOCOUNT ON
DECLARE @queueid INT

WHILE (SELECT COUNT(*) FROM Test WITH (updlock, readpast)) >= 1

BEGIN

   BEGIN TRAN TRAN1

   SELECT TOP 1 @queueid = Id
   FROM Test WITH (updlock, readpast)

   PRINT 'processing queueid # ' + CAST(@queueid AS VARCHAR)

   WAITFOR DELAY '00:00:10'

   DELETE FROM Test
   WHERE Id = @queueid
   COMMIT
END

总结
本文我们探讨产生并发在SQL Server中如何不处于阻塞并且得到较好的性能,对于那种秒杀情况,这种方案不失为一种解决方案,请问你有何高见?
本文转自Jeffcky博客园博客,原文链接:http://www.cnblogs.com/CreateMyself/p/6906279.html,如需转载请自行联系原作者