[本文出自天外归云的博客园]
问题
最近在网上搜到了一些练习题,改编了一下这里的20题如下:登陆中国联通网上营业厅 后选择「自助服务」-->「查询」-->「账户余额」,然后输出手机号码和可用额度。
思路
1. 通过抓包模拟接口请求的方式和一些爬网的相关方法解决;
2. 通过selenium进行一些web自动化操作解决。
编写脚本
这里选择了第二种用selenium的方法来解决,脚本如下:
# -*- coding: utf-8 -*-
from selenium import webdriver
import selenium.webdriver.support.ui as ui

def login_query_10010(username,pwd):
    driver = webdriver.PhantomJS()
    driver.get("http://iservice.10010.com/e4/")
    wait = ui.WebDriverWait(driver, 10)
    login_frame = driver.find_element_by_xpath("html/body/div[5]/div[1]/iframe")
    driver.switch_to_frame(login_frame);
    wait.until(lambda dr: dr.find_element_by_id('userName').is_displayed())
    driver.find_element_by_id("userName").send_keys(username)
    driver.find_element_by_id("userPwd").send_keys(pwd)
    driver.find_element_by_id("login1").click()
    driver.switch_to_default_content()
    wait.until(lambda dr: dr.find_element_by_id('menu_query').is_displayed())
    driver.find_element_by_id("menu_query").click()
    wait.until(lambda dr: dr.find_element_by_id('000100010002').is_displayed())
    driver.find_element_by_id("000100010002").click()
    wait.until(lambda dr: dr.find_element_by_xpath(".//*[@id='loadPage']/iframe").is_displayed())
    account_info_frame = driver.find_element_by_xpath(".//*[@id='loadPage']/iframe")
    driver.switch_to_frame(account_info_frame);
    wait.until(lambda dr: dr.find_element_by_id('userInfoContent').is_displayed())
    wait.until(lambda dr: dr.find_element_by_xpath(".//*[@id='userInfoContent']/dl[3]/dd").is_displayed())
    phone_number = driver.find_element_by_xpath(".//*[@id='userInfoContent']/dl[3]/dd").text
    print(u"电话号:"+phone_number)
    wait.until(lambda dr: dr.find_element_by_xpath(".//*[@id='userInfoContent']/dl[4]/dd").is_displayed())
    available_amount = driver.find_element_by_xpath(".//*[@id='userInfoContent']/dl[4]/dd").text
    print(u"可用预存款:"+available_amount)

if __name__ == '__main__':
    login_query_10010("用户名","密码")
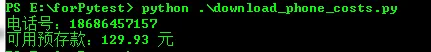
运行结果如下(脚本中用户名和密码为需替换的部分):
总结
总结一下遇到的一些经验点:
1. 通过phantomjs无界面浏览器可以实现无界面化web自动化访问;
2. 如果一个元素定位不到,要看看这个元素是否嵌在iframe元素中,这里用到了selenium定位页面元素之iframe元素的切换;
3. 确定页面元素可访问之后,如果还找不到定位的元素,可能是没有加载完成,需要进行一定时间的等待,这里用到了“wait.until”方法;
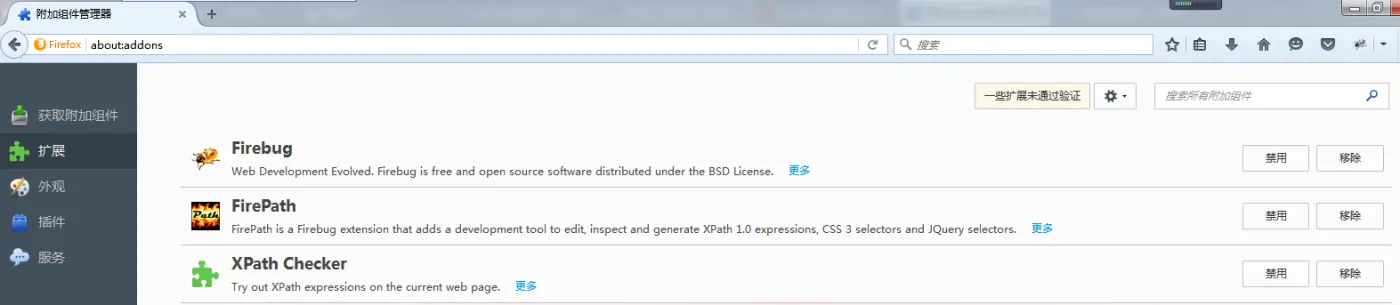
4. 定位页面元素可以用过id和一些属性,如果没有明显属性可以用来定位则可以考虑用xpath来定位,这里用到了firefox的一些xpath插件来辅助显示页面元素的xpath路径: