Coursera创始人兼斯坦福大学副教授吴恩达声称,迁移学习将成为机器学习取得商业成功的下一个驱动力。
迁移学习是一种机器学习技术,在一个特定的数据集上,重新利用已经训练过的卷积神经网络(CNN),并将其改造或迁移到一个不同的数据集中。重复使用训练过的卷积神经网络,主要原因是训练数据通常需要花费很长的时间。例如:在4个NVIDIA K80 GPU上对ResNet18训练30次需要3天,在4个NVIDIA K80 GPU上对ResNet152训练120次需要4个月。
本文将使用pytorch在不同的数据集上进行迁移学习,阐述最常见的迁移学习策略,并分析在何种情况应该使用哪种策略。
如果想直接看到结果,请划至文末。
迁移学习策略
通常来说,迁移学习的策略有两种。Finetuning(微调)包括在基础数据集上使用预训练网络,并在目标数据集上训练所有层。Freeze and Train(冻结和训练)包括仅冻结并训练最后一层,其他层不变(权重不更新);也可以冻结前几层,微调其他层,这是由于有些证据表明CNN的前几层有纹理滤镜和彩色斑点。本文我们将分析两个极端的例子:训练所有的网络层和只训练最后一层。
最常见的基础数据集是 ImageNet,包含1000个类别的120万张图像,每个类别的图像大约有1000张,可分为两组:动物和物品。大多数深度学习库可提供在ImageNet上训练好的CNN模型。
下图为CNN架构的工作流程图,即ResNet,来识别猫。输入为一张224px*224px大小的3通道RGB图像,输出是虎斑猫标签。最后一层有1000个单元,相当于1000个ImageNet的类。

下图可看到上述提到的迁移学习的两个方法。在这里,我们在ImageNet上使用一个预先训练过的CNN,改编来对Homer Simpson分类,将 the Simpsons Character Data的一个子集作为目标数据集。这个子集包含20个类,每个类有300到1000个图像。
迁移学习的第一步是将基本数据集类的数量调整到目标数据集类的数量,在Simpson数据集中,必须删除网络最后一层,它包含1000个单元,并添加了一个有20个单元的新层。
如上图所示,然后进行Freeze and Train(冻结和训练),我们只训练最后一层。或者我们也可以微调所有层,如下图所示。

什么时候使用迁移学习?
应该只训练最后一层还是微调整个网络适用于哪种情况很难确定。在Yosinsky的论文(Yosinsky 等等, 2014)中,作者表述了在ImageNet数据集的环境中,一个指定的卷积神经网络的层是常规的还是特定的这一量化程度问题。由于这些层需要相互适应,在中间的某些层网络的分裂对迁移性有负面影响。论文指出,迁移间隔随着任务之间距离的增加而增长,与零权重训练相比,用迁移权重初始化网络可以提高范化性能。
正如Karpathy教程中所讲的,在新的数据集中使用迁移学习时,一些基本原则如下:
1.小而相似的图像:当目标数据集与基本数据集相比时较小,且图像相似时,建议冻结和训练最后一层。
2.大而相似的图像:当数据集较大且图像相似时,建议微调。
3.小而不同的图像:建议freeze and train(冻结和训练)最后一层,或一些最后一层。
4.大而不同的图像:建议微调。
本文将使用不同的数据集重新验证这些策略。

模型和实用程序
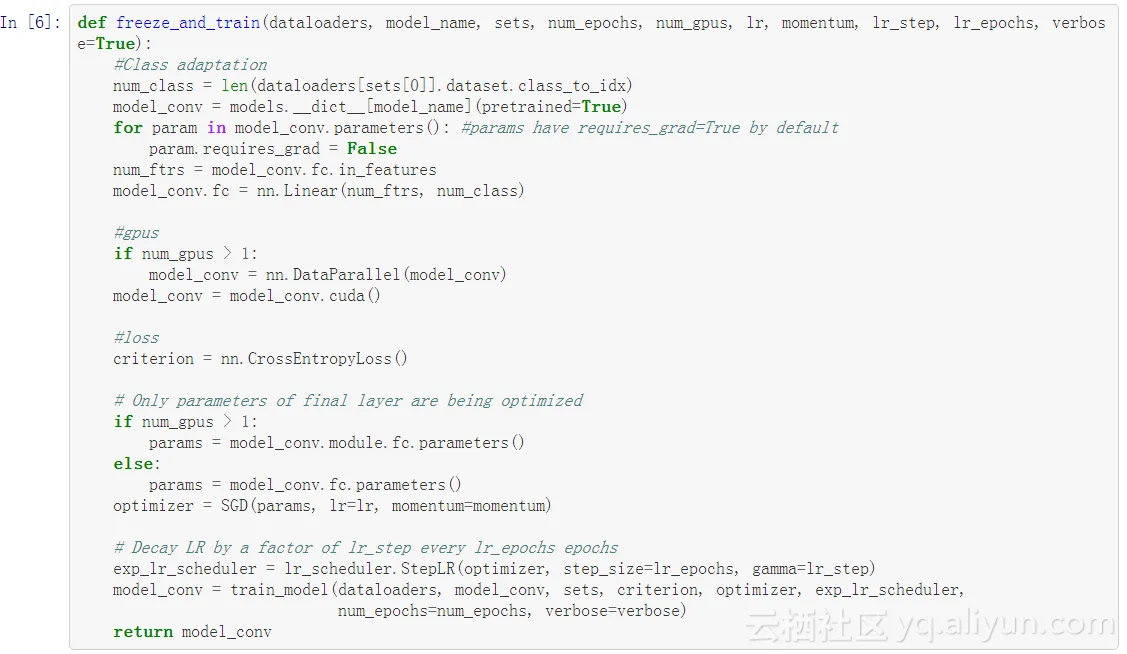
第一步,定义finetune (微调)和freeze_and_train(冻结和训练)程序。此外,列出了pytorch中所有可用模型,我们可以将其用作基础模型。
数据集
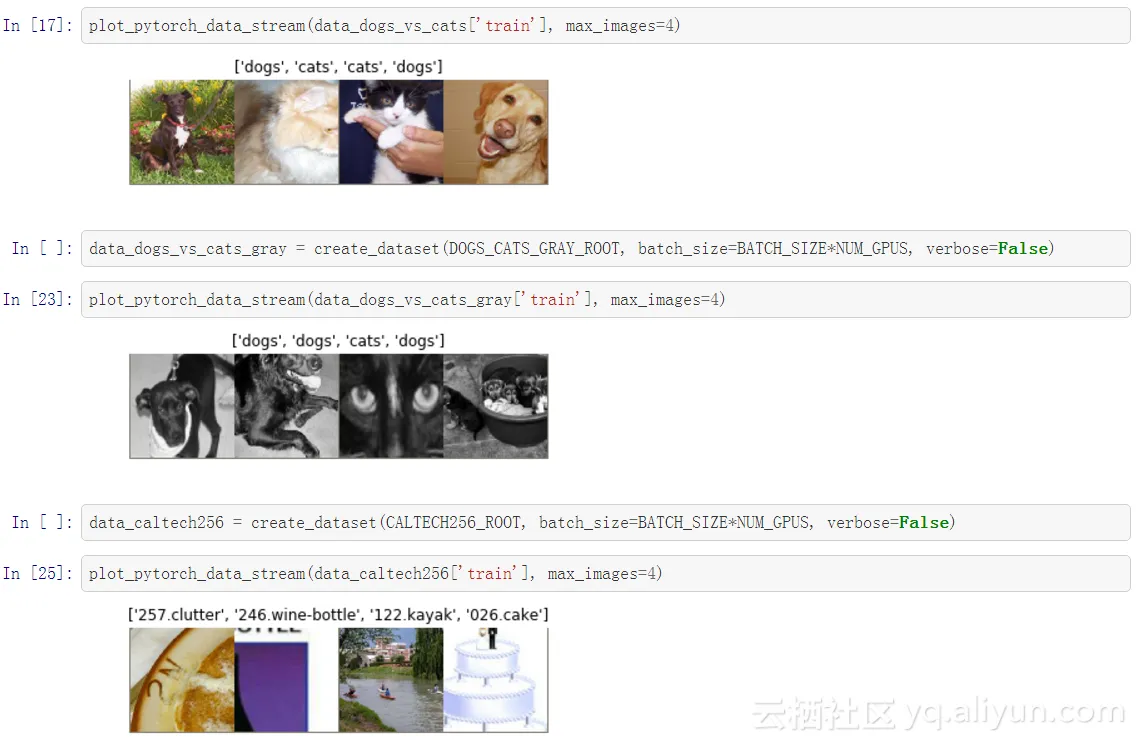
我们使用不同的数据集测试迁移学习程序,将它们全部转换为灰度范围内的数据集,来分析网络在彩色空间内的行为。我们还必须按照pytorch结构将数据集目录分为训练和验证。所有的步骤请参照data_prep.ipynb。
资源链接:
Hymenoptera,2 个类和397 张图片
Simpons,20 个类(总体的子集) 和19548张图像
Dogs vs Cats,2个类和25000 张图像
Caltech 256,257个类和 30607张图像

我们定义了初始化参数。

现在,我们加载每个数据集,显示每个数据集的内部统计信息。



训练
对于每个数据集,我们将要计算 finetunining和freeze and train。
注:截止到目前(2017年12月),PyTorch并行计算的效率并不高,因此同时使用4个GPU计算微调和冻结。使用一个GPU冻结的速度比微调快2.5倍。它们有个PR解决这个问题,更多信息请参阅这里。
Hymenoptera数据集


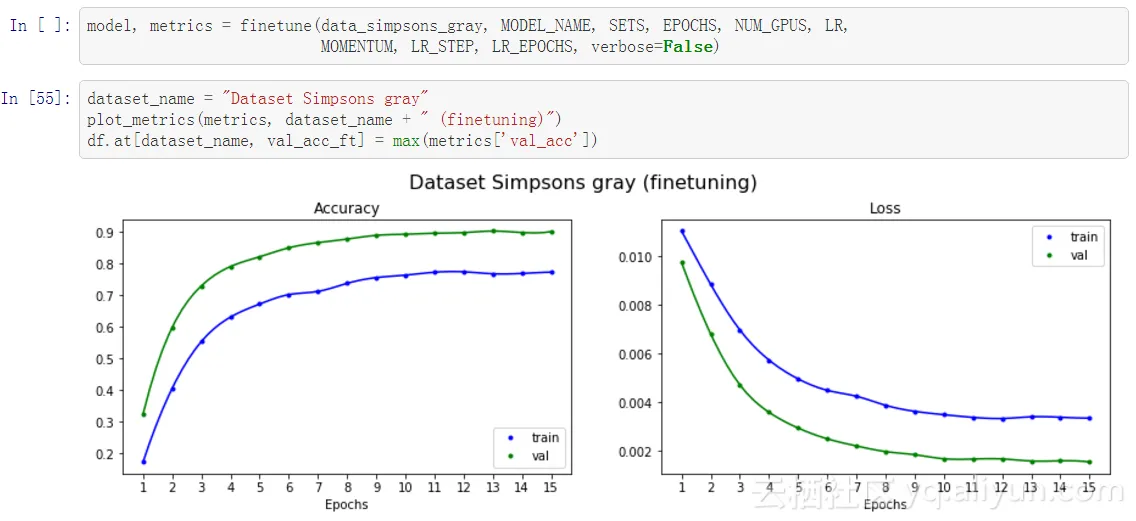
Simpsons数据集


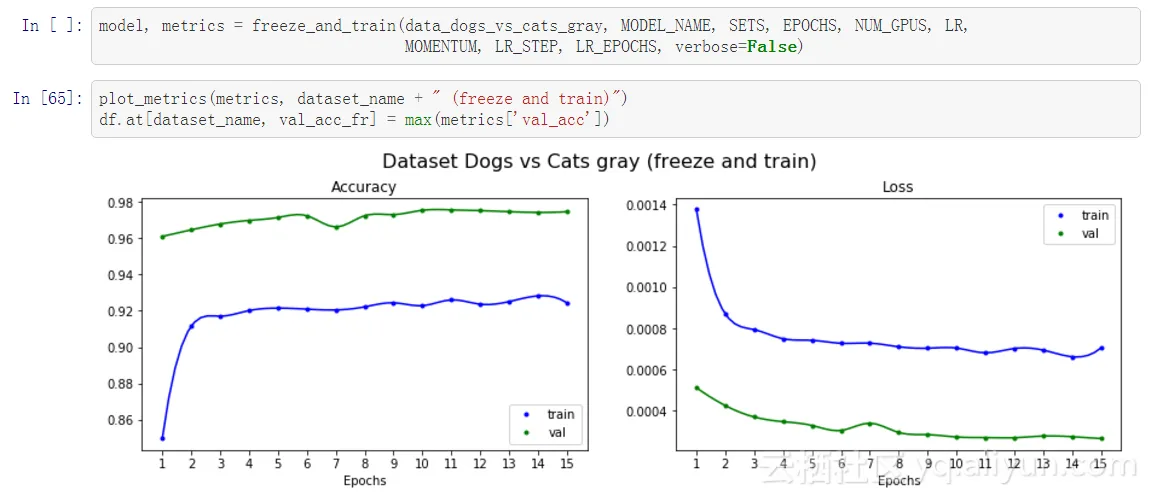
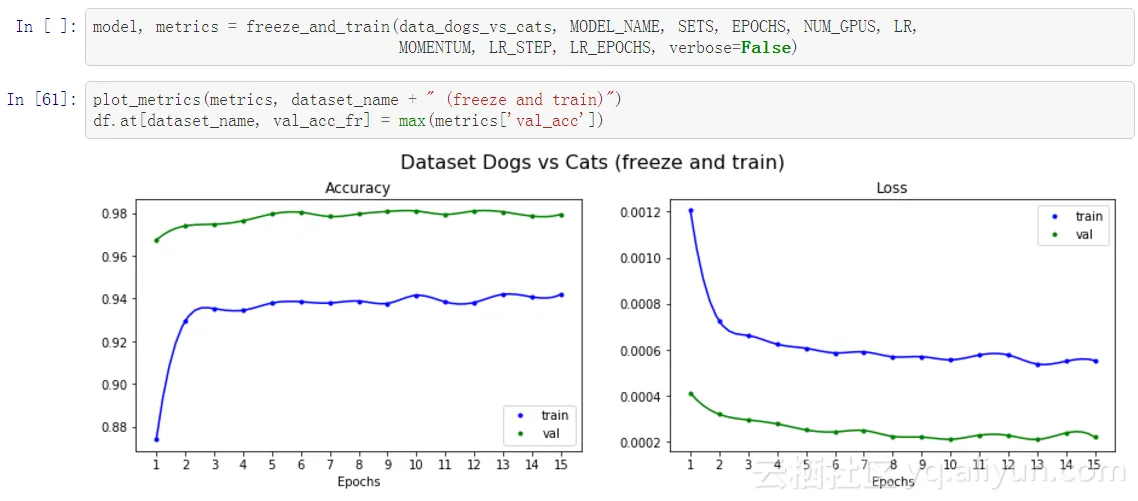
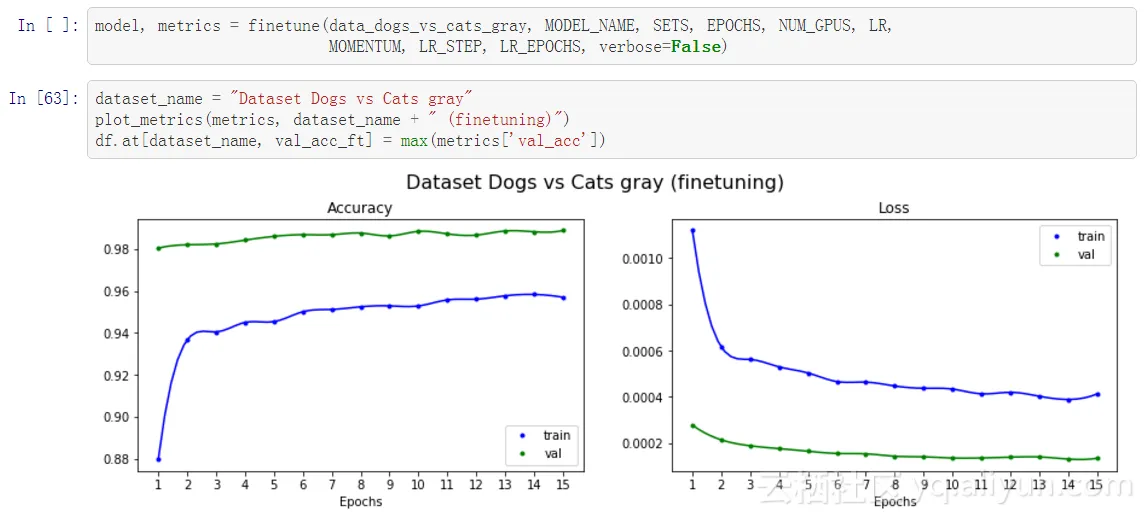
Dogs vs cats数据集

Caltech256数据集

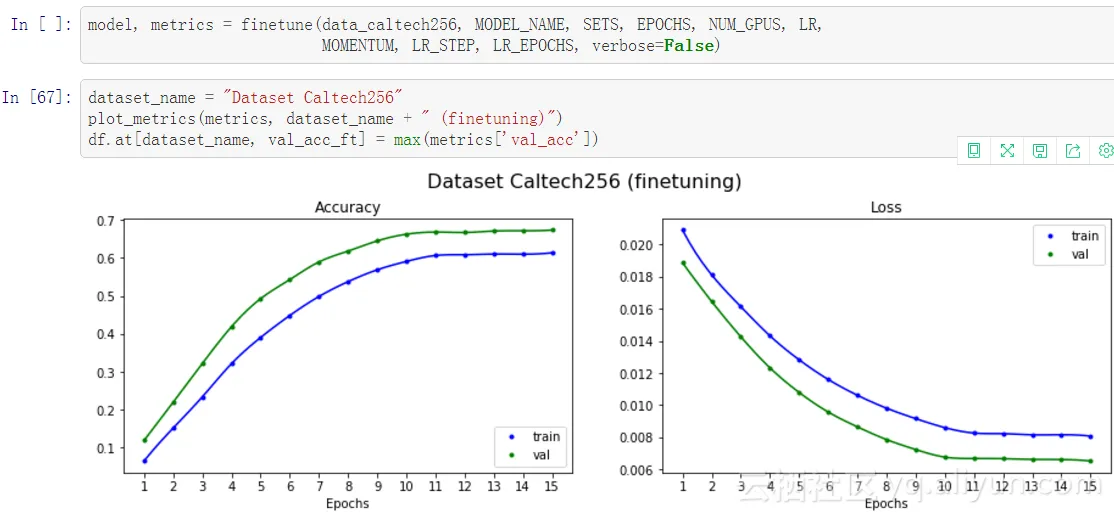
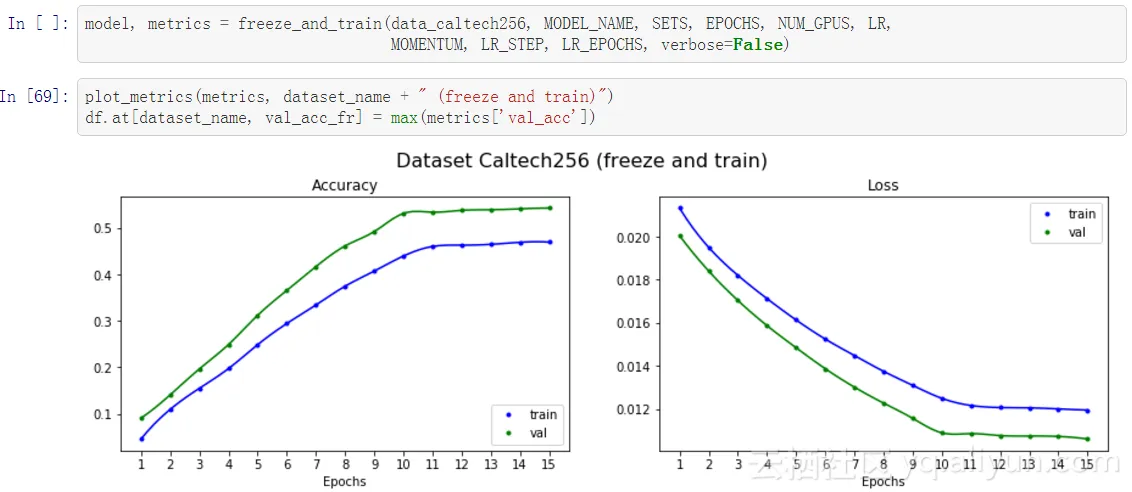
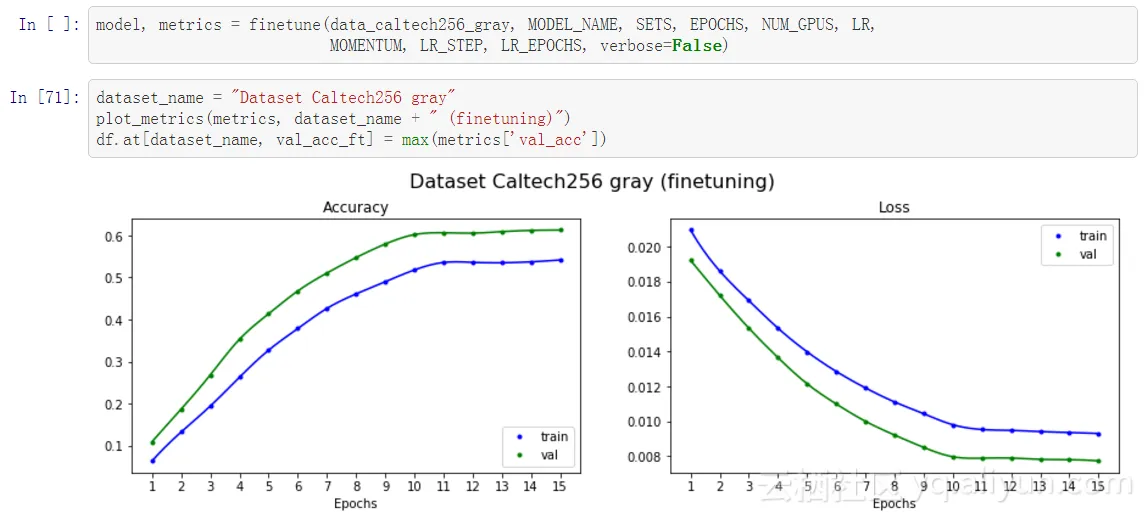
总结

讨论和分析
本文使用了数量有限的小型网络数据集ResNet18,因此将研究成果推广到所有数据集和网络还为时过早。然而,这一研究成果可能会为使用转移学习时碰到的问题提供一些启示。结论如下表所示。
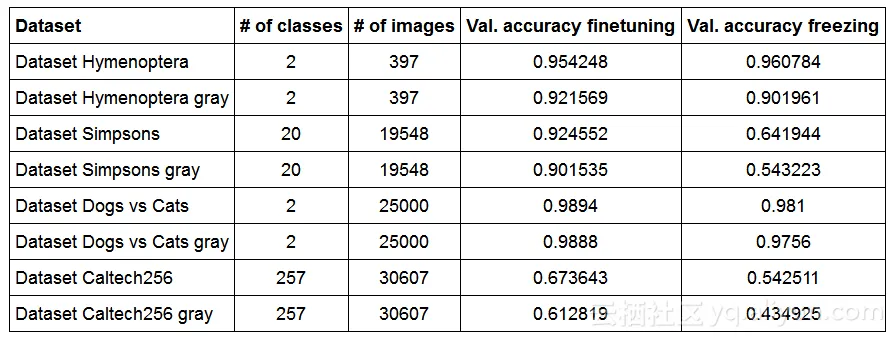
我们观察到的第一个细节是,与彩色数据集相比,训练灰度数据集的精确度较低。这与其他研究人员的结论一致,即基础数据集和目标数据集的领域差异越大,移植性越差。
我们也观察到,对于Simpsons和Caltech256数据集来说,在冻结时精确度降低幅度较大。在Simpsons数据集中,精确度降低最多可能是由于领域跨度大,而在ImageNet数据集中有自然图像,Simpsons数据集中大多是纯色。在Caltech数据集中精确度较低,冻结时精确度降低幅度较大。可能是由于一个包含了大量的类数据集,每个类的图像数量较小,大约有数百个。
Dogs and Cats数据集与ImageNet数据集最为相似,实际上,ImageNet数据集包含几种狗和猫。在这种情况下,微调或冻结没有太大的差别。
最后,在hymenoptera(膜翅目昆虫)数据集中,我们看见了在冻结时彩色数据集的一个小进步。这是因为领域相近,并且数据集比较小的缘故。对应灰色数据集,在冻结的时候,我们看不到任何提高,大概是由于领域迥异吧。
以上为译文。
本文由北邮@爱可可-爱生活 老师推荐,阿里云云栖社区组织翻译。
文章原标题《A Gentle Introduction to Transfer Learning for Image Classification》,译者:Mags,审校:袁虎。
文章为简译,更为详细的内容,请查看原文