前言:
本篇之所以称为草稿设计,是因为设计的都是在纸上完成的。反映了一个思考的过程。
本篇的议题如下:
1) 第一个数据层草图的提出
2) 对数据访问层的思考
3) 第二个数据层草图的提出
1.数据层草图的提出
Richard开始着手设计,一开始他没有就立刻在自己的计算机开始敲代码。而且采用笔+纸开始构思。
因为他认为:写程序不是什么时候都得上机,脑子里面想什么的才是最重要的,往往很多时候,在设计程序时,首先在头脑中就已经把整个功能已经实现了,甚至代码的详细编写都已经在头脑中走了一遍,并且在头脑中运行,调试了。
开始设计了,因为这次Richard想要提出一个比较好的架构,一个比较强大的企业级的架构,所以参看成功的一些案例是很有必要,Richard也想到了微软best practice的那些推荐的架构组织方式和建议(大家对best practice不熟悉也要紧,不会影响阅读)。
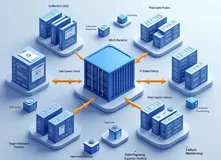
之后,Richard的第一个草图就出来了:

一个架构组织方式的提出,不是随随便便就提出的,新的架构的设计和提出首先必须要明白你要解决哪些问题,而且也不要过度设计。(这个过程很难,很多时候需要权衡,所以作为架构的设计者,权衡的思想很重要:在时间,资源,资金等都要考虑)。可能在起初会参看一些别的设计架构,甚至是模仿它们,但是随着思考的深入,那些表象的东西就会逐渐的被抛除。
同时也开始设计的时候,没有说一定要立刻就要设计出一个很强大的东西出来,对架构设计的能力也是在慢慢的演化和思考过程中提升的。
2. 对数据访问层的思考
在解释为什么架构要像上面那副图进行设计之前,我们首先来讨论一些之前项目问题:
对于数据访问层(DAL)的问题:
1. DAL很依赖Linq生成的实体。可以说在之前的项目中,在数据访问层能够使用的技术就已经钉死在了Linq上。这里不是说Linq不好,而且强调在DAL的访问技术的选择的余地已经没有了,不灵活。
a) 在架构的设计过程中,就需要考虑到以后技术的转变和更换,可能在项目A中采用Linq to sql,但是在项目B中就采用Entity Framework。因为我们的目的就是要开发一个比较灵活的通用架构,能够支持不同就数据访问技术。可能以后的项目都只是用一种访问技术,但是最为架构的设计者,特别是希望从架构最后能够演化到Framework, 那就要为更换技术预留接口。
2. 在DAL中没有很多的异常处理等底层机制。
a) 在项目设计的过程中,有些底层的机制是几乎每一个逻辑都要用到的:异常处理,日志跟踪,缓存机制,事务机制,安全验证机制。当时在之前的DAL中是没有的。可能现在你认为有些机制不是需要的,或者不明白为什么需要。
因为一个强大的软件,不能随随便便就因为某些异常或者错误就崩溃了,也不可能就是一大堆代码的堆砌。上面所提到的有些机制:如异常,日志,它们的价值很多时候在软件维护的时候体验出来。根据日志记录,可以查处软件哪里出了问题,如是数据库断了,还是哪个操作流程导致了问题。 而有些机制是在运行时体现价值,如缓存,验证,事务。
但是在使用这些底层机制的时候也要权衡,综合的考虑,如缓存机制,就得明白那些数据要缓存,缓存在哪里,缓存数据时候要加密,缓存多长时间,如何刷新过期了的数据。等等,很多东西要考虑。
3. 数据来源仅仅只是考虑了数据库。其实这个问题不是之前的项目的一个问题,但是这里有必要提出。
a) 一般在我们开发项目的时候,数据的来源很多时候都是数据库,我们直接操作数据库就行了,但是还得考虑一个问题:如果我们的项目没有自己的数据库,我们的数据来源是来自其他的公司或者服务接口,怎么办?作为架构的设计者,是需要考虑这些的。NET 分布式架构开发实战之二 草稿设计
可能在项目敲定那天就已经清楚是自己设计数据库还是从其他地方获取数据。但是一个通用的一个架构的就要能够为其他的数据源预留接口。
这里,可能就有了一点过度设计的味道了,起初在项目A中所使用的架构没有考虑其他数据源的问题,但是如果在项目B中出现了,怎么办?那么架构就要演化,改进来适应这种情况。
之前也提过,没有必要一上来就设计强大的就架构,而是在项目中改进,演化。开始时候没有考虑到,以后慢慢的加嘛。(比较的纠结)。
上面只是紧紧的从数据层DAL的角度进行了思考,DAL最终还是为业务层BLL提供数据的,所以就考虑DAL以何种方式来被BLL调用,鉴于之前的一些考虑,可以得出一点:不让BLL直到DAL的实现细节,所以接口似乎是个不错的解决办法,Provider的模式也似乎可以排上用场。
于是,Richard就决定在DAL和BLL之前加上接口层来解耦。
3. 第二个数据层草图的提出

这个图和之前的第一个图基本上是一样的,只是做了一修改,而且加上了之前谈论中涉及的一些问题。
因为随着思考的深入,逐渐的发觉:数据源的来源可以很多—数据库,普通文本,XML等等。不同的数据源提供不同的Provider,其实从其他的服务接口获取数据也是一种来源,上面的图之所以单独的把Service Agent分出,主要是因为比较特殊。
而且图中的那些基本功能:Log, Exception等,是到处都用到的。
此时Richard也在头脑中闪现了一些要处理的,可以出现的异常:
1.Data Source is not exits:数据源不存在,因为这个问题很常见,比如在项目运行过程中,数据库断了,或者远程的服务无法访问,等等基本都属于这个问题的。所以这个异常肯定是要处理的。
2. Time out:超时。这个异常很常见,获取的数据过大,或者远程数据源连接超时,等,都可以引发一些问题。
3. 如果数据源是其他服务接口提供数据,那么在数据获取时,可能要转换数据格式,如果格式出错,。或者发送的数据不符合一些规则,这个异常一定要处理,因为这些数据可能涉及到安全的问题了:是数据真的不正确,还是被篡改了。
程序就必须对这些异常进行处理:是把原生的异常抛出,然后有业务层决定如果处理;还是决定把异常包装称为另外的一个异常,再抛出;还是最后干脆再DAL就执行自己处理,然后给业务层一个友好的提示,等等。如果数据源是远程的服务,那么如果服务断了,在异常过程中,采用什么样的策略:简单的处理,如抛出异常,记录日志,还是做一些恢复性的操作,如尝试重新连接,等。
之前第一张图中,在DAL上定义一个接口,用来接耦,但是在第二张图有做了一些修改--把DAL做为服务提供出去。之所以做了这个修改,因为在开始思考的时候,只是认为底层设计的DAL只是给BLL使用。可以发觉到一点:在DAL中,数据可以从远程的服务中获取,那么可能我们这里的DAL也可以作为服务给其他的人设计的DAL使用,也就是说,我们的这里的DAL成了远程服务的数据源。所以做了上面的修改。但是这个思考到还会改进,因为这里面问题(读者朋友可以先自己思考是什么问题)。
相关文章:.NET分布式架构开发实战之一 故事起源