实验涉及大数据产品
- 大数据计算服务 MaxCompute
- 大数据开发套件 DataWorks
实验环境准备
必备条件:首先需要确保自己有阿里云云账号并已实名认证。详细点击:
开通大数据计算服务MaxCompute
若已经开通和购买了MaxCompute,请忽略次步骤直接进入创建DataWorks项目空间。


- step3:选择按量付费并点击立即购买。

创建DataWorks项目空间
确保阿里云账号处于登录状态。
- step1:点击进入大数据(数加)管理控制台>大数据开发套件tab页面下。
- step2:点击右上角创建项目或者直接在项目列表-->创建项目,跳出创建项目对话框。

选择相应的服务器时如果没有购买是选择不了会提示您去开通购买。数据开发、运维中心、数据管理默认是被选择中。
- step3:勾选相应的服务单击 确认,跳转到下面的界面,填写相应的信息单击确认,创建项目完成。

项目名需要字母或下划线开头,只能包含字母下划线和数字。
【注意】项目名称全局唯一,建议大家采用自己容易区分的名称来作为本次workshop的项目空间名称。
- step4:单击进入项目跳转到下面的界面:

新建数据源
根据workshop模拟的场景,需要分别创建FTP数据源和RDS数据源。
1.新建FTP数据源
- step1:点击数据集成>数据源,继而点击新增数据源。

- step2:选择数据源类型ftp,同时Protocol选择为sftp,其他配置项如下。

FTP数据源配置信息如下:
- 数据源类型类型:有公网ip
- 数据源名称:ftp_workshop_log
- 数据源描述:ftp日志文件同步
- Protocol:sftp
- Host:118.31.238.64
- Port:22
- 用户名/密码:workshop/workshop
- step3:点击测试连通性,连通性测试通过后,点击确定保存配置。

2.新建RDS数据源
- step1:点击数据集成>数据源,继而点击新增数据源。
- step2:选择数据源类型为RDS>mysql并完成相关配置项。

RDS数据源配置信息如下:
- 数据源类型:阿里云数据库(RDS)
- 数据源名称:rds_workshop_log
- 数据源描述:rds日志数据同步
- RDS实例名称:rm-bp1z69dodhh85z9qa
- RDS实例购买者ID:1156529087455811
- 数据库名:workshop
- 用户名/密码:workshop/workshop#2017
- step3:点击测试连通性,连通性测试通过后,点击确定保存配置。

创建目标表
- step1:点击数据开发,进入数据开发首页中点击新建脚本。

- step2:配置文件名称为create_table_ddl,类型选择为ODPS SQL,点击提交。

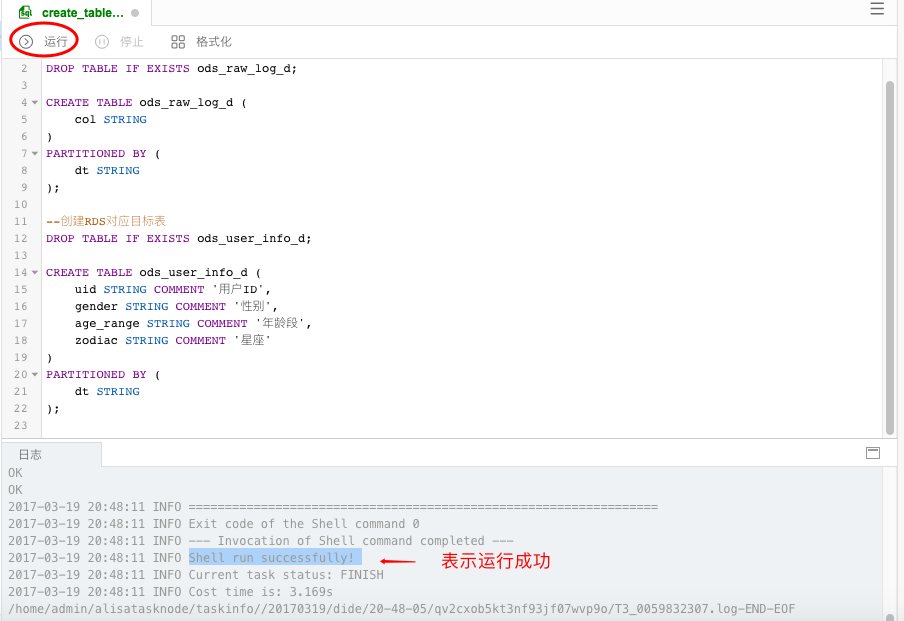
- step3:编写DDL创建表语句,如下分别创建FTP日志对应目标表和RDS对应目标表。

DDL语句如下:
--创建ftp日志对应目标表
DROP TABLE IF EXISTS ods_raw_log_d;

CREATE TABLE ods_raw_log_d (
  col STRING
)
PARTITIONED BY (
  dt STRING
);

--创建RDS对应目标表
DROP TABLE IF EXISTS ods_user_info_d;
CREATE TABLE ods_user_info_d (
  uid STRING COMMENT '用户ID',
  gender STRING COMMENT '性别',
  age_range STRING COMMENT '年龄段',
  zodiac STRING COMMENT '星座'
)
PARTITIONED BY (
  dt STRING
);- step3:点击运行,直至日志信息返回成功表示两张目标表创建成功。
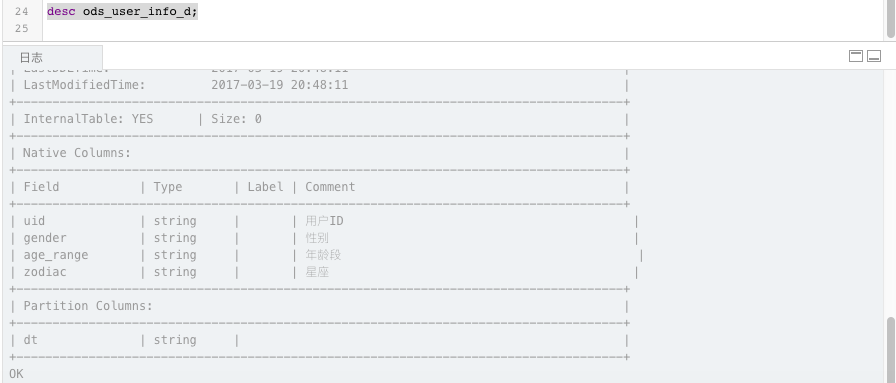
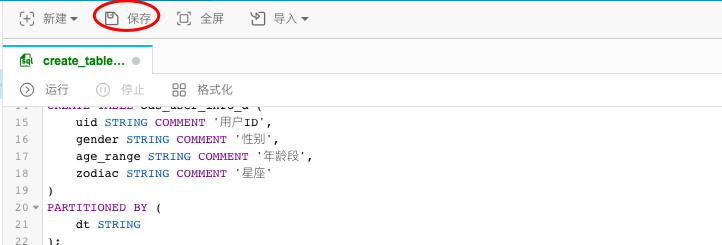
- step5:点击保存,保存编写的SQL建表语句。

新建工作流任务
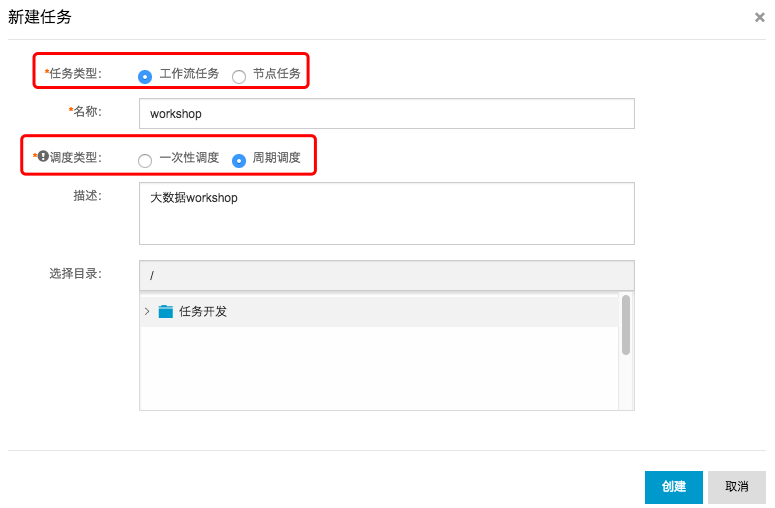
- step1:点击新建并选择新建任务。href="https://yqfile.alicdn.com/dc80059e519af072213306f0d927b16e8c588a24.png" target="_blank">

- step2:选择工作流任务,调度类型选择为周期调度,其他配置项如下。

- step3:点击创建。
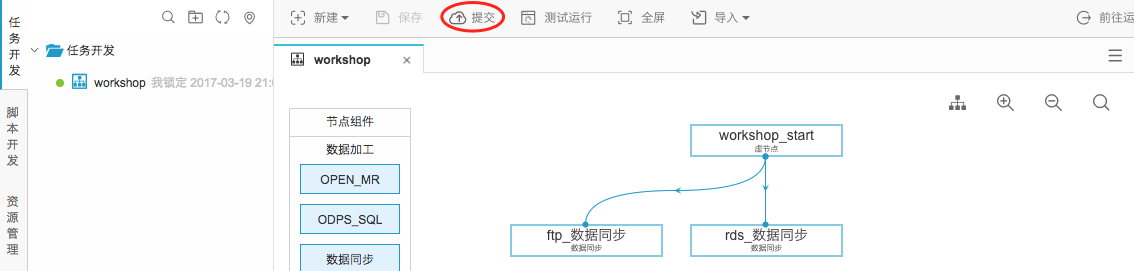
- step4:进入工作流配置面板,并向面板中拖入一个虚节点(命名为workshop_start)和两个数据同步节点(分别命名为ftp_数据同步和rds_数据同步):



- step5:拖拽连线将workshop_start虚节点设置为两个数据同步节点的上游节点,如下所示:

- step6:点击保存(或直接快捷键ctrl+s)。
配置数据同步任务
1)配置ftp_数据同步节点
- step1:双击ftp_数据同步节点,进入节点配置界面。选择来源:并选择数据来源事先配置好的ftp数据源,为ftp_workshop_log,文件路径为/home/workshop/user_log.txt。可以对非压缩文件进行数据预览。

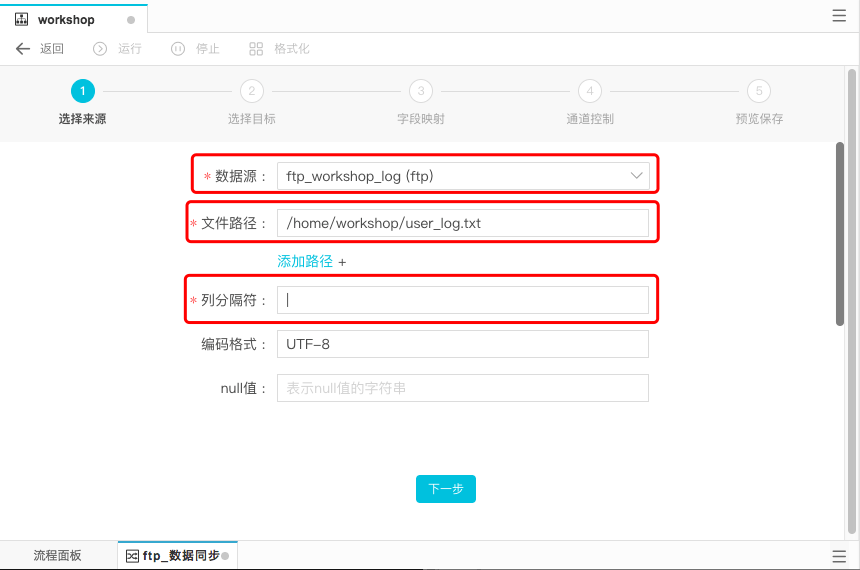
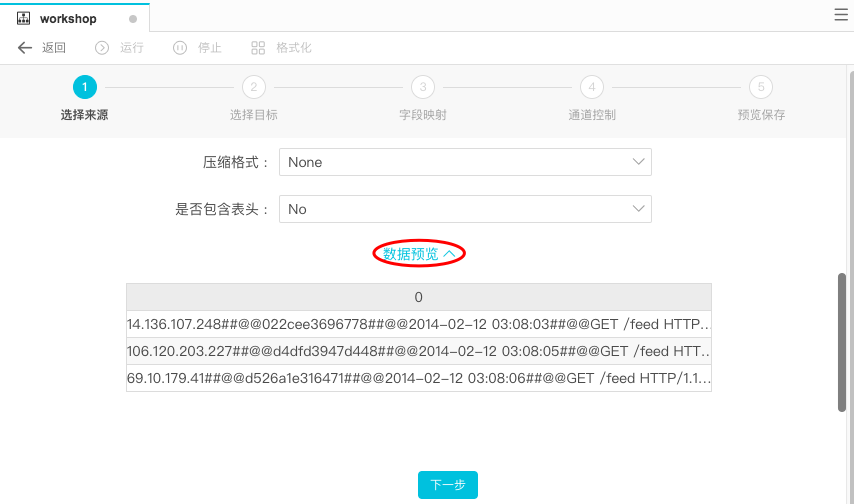
数据来源配置项具体说明如下:
- 数据来源:ftp_workshop_ftp
- 文件路径:/home/workshop/user_log.txt
- 列分隔符:|
- step2:选择目标。点击下一步。
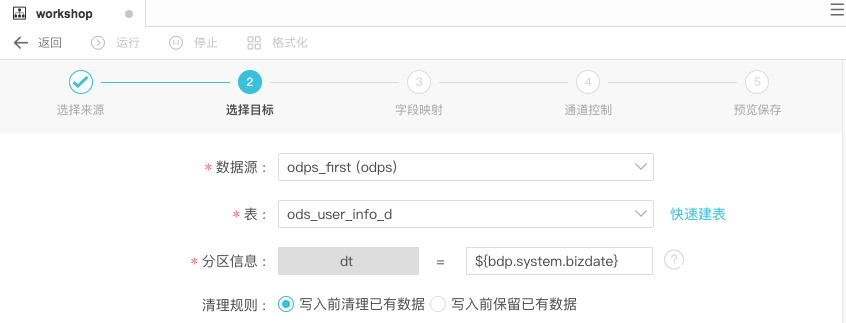
数据流向选择数据源为odps_first,表名为ods_raw_log_d。分区信息和清理规则都采取系统默认,即清理规则为写入前清理已有数据,分区按照${bdp.system.bizdate}。
- step3:配置字段映射。连接要同步的字段。如下:

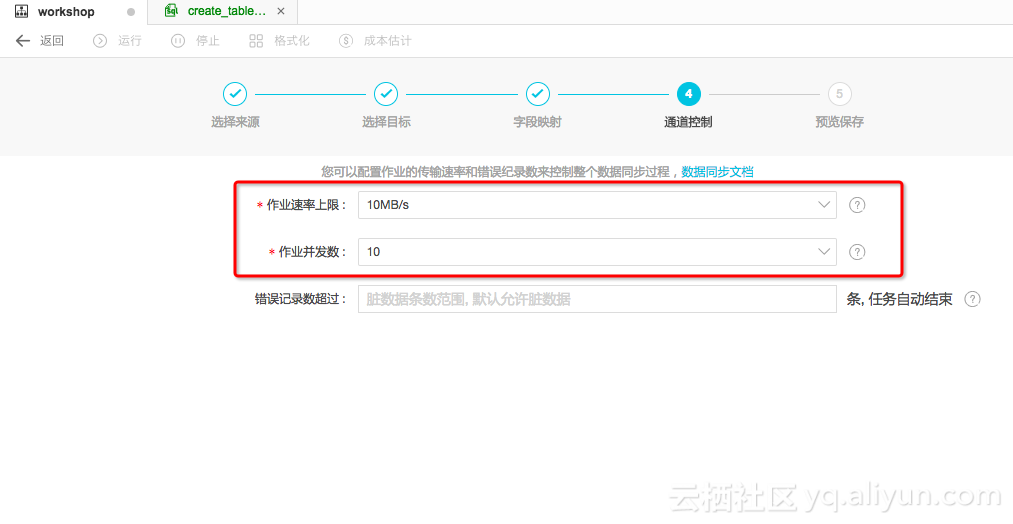
- step4:在下一步操作中配置通道控制,作业速率上限为10MB/s,进入下一步。

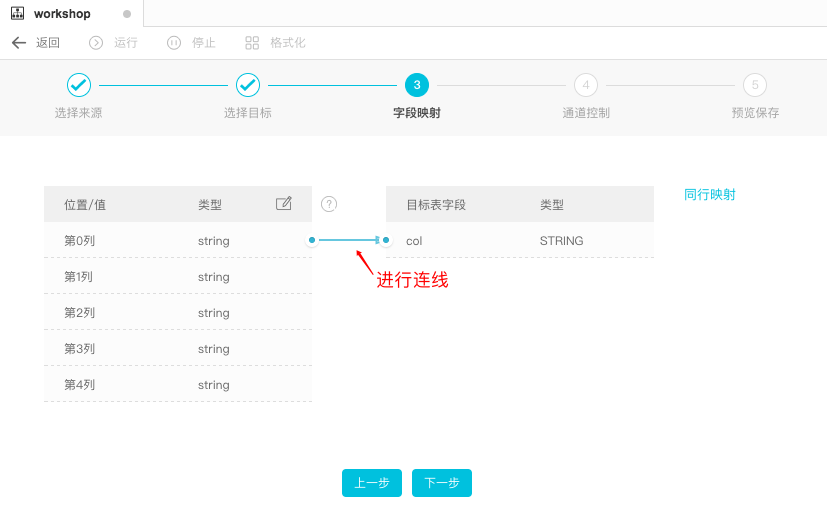
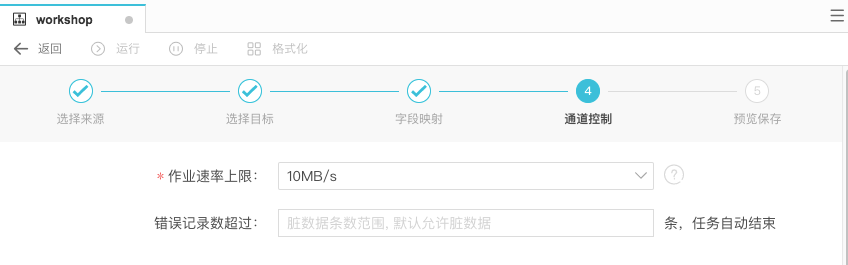
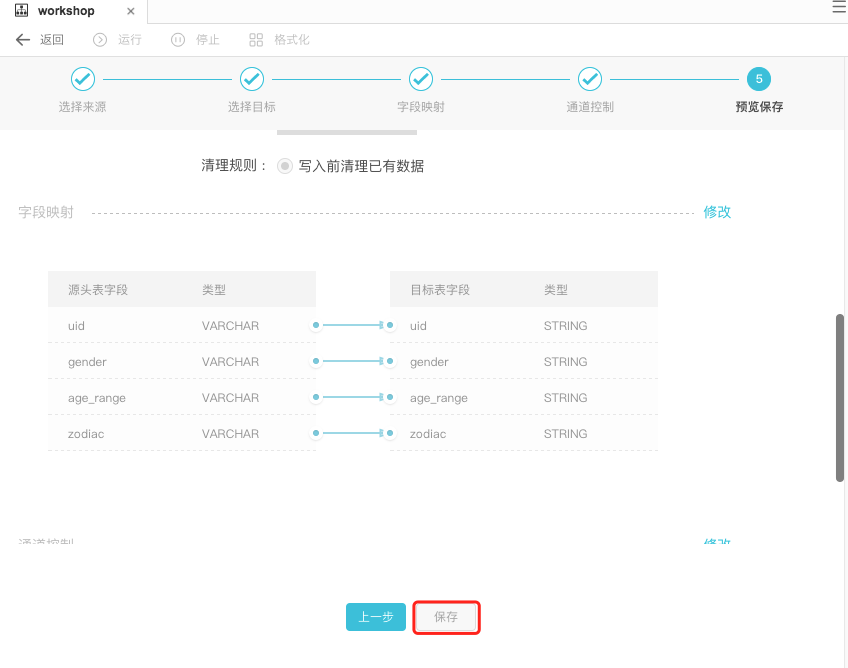
可在预览保存页面中,预览上述的配置情况,也可以进行修改,确认无误后,点击保存。
- step5:点击返回工作流面板。

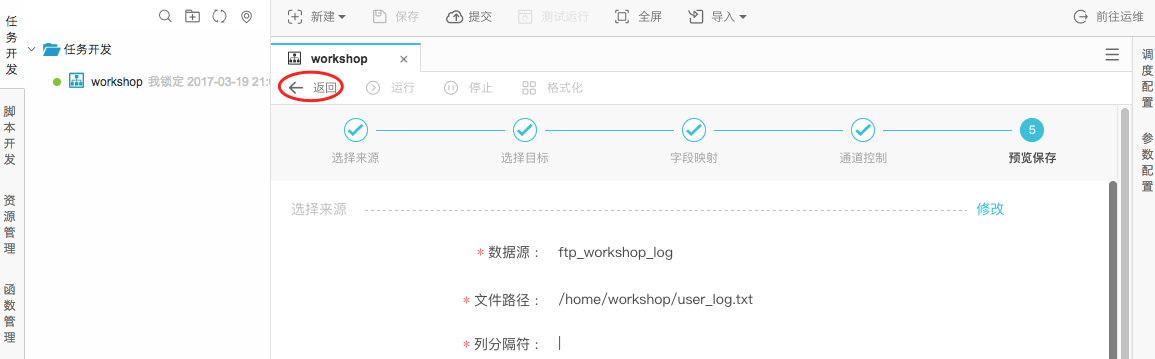
2)配置rds_数据同步节点
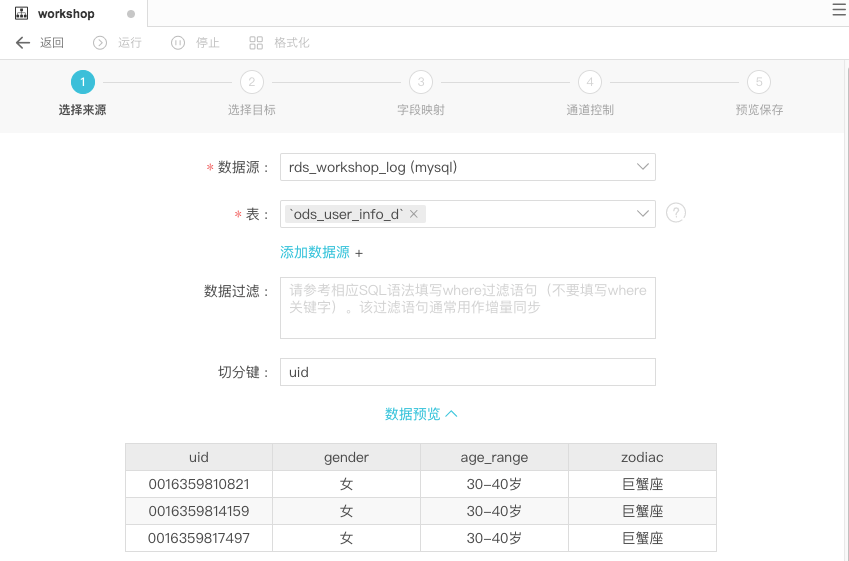
- step1:双击rds_数据同步节点进入配置界面。选择来源:选择数据来源为rds_workshop_log,表名为ods_user_info_d;切分键为使用默认生成列即可。点击数据预览,可以看到表中数据样例。

- step2:进入下一步,选择目标数据源和表名。

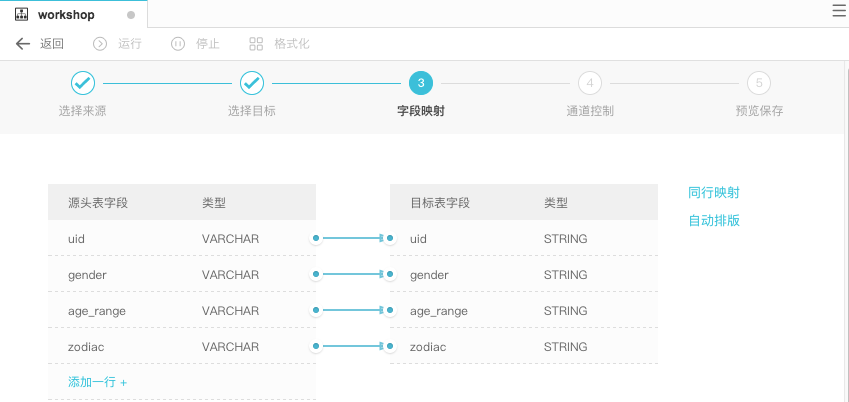
- step3:进入下一步,配置字段映射。默认会同名映射,字段映射关系采用默认即可,如下所示:

- step4:进入下一步,配置作业速率上限。

- step5:在预览保存页面中确认配置信息,无误后点击保存配置。

配置调度、提交工作流任务
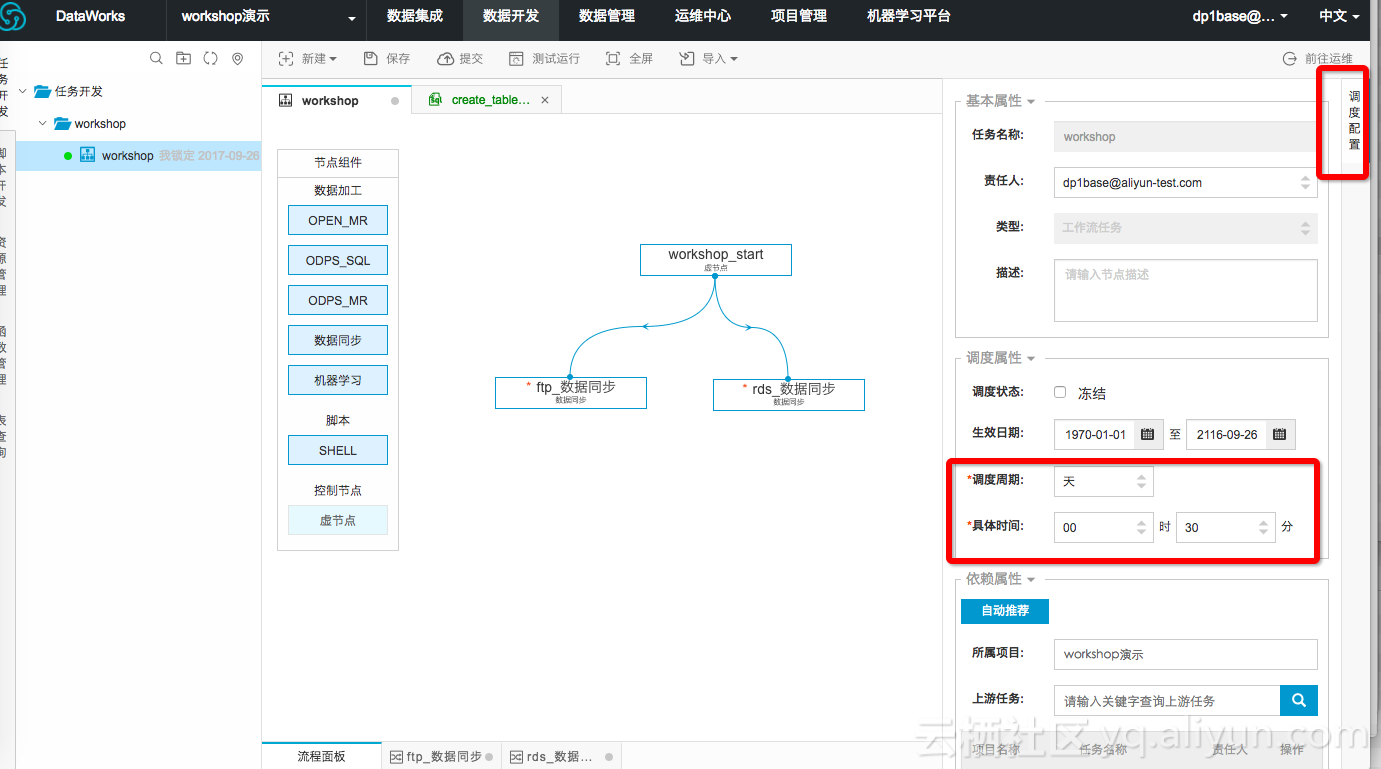
- step1:点击调度配置,配置调度参数

- step2:点击提交,提交已经配置的工作流任务。

- step3:在变更节点列表弹出框中点击确定提交。

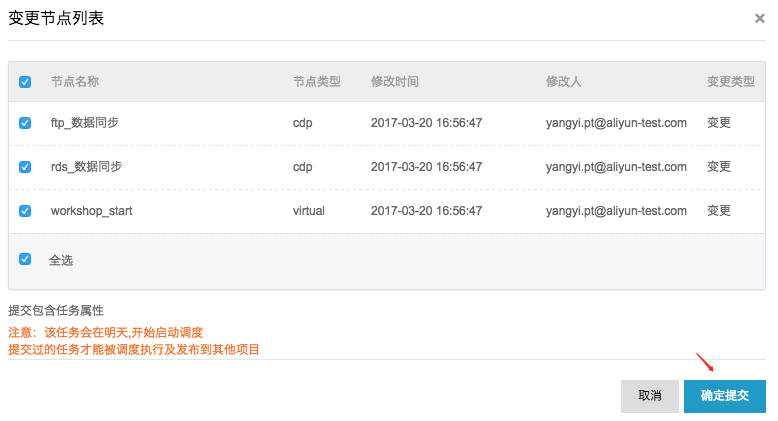
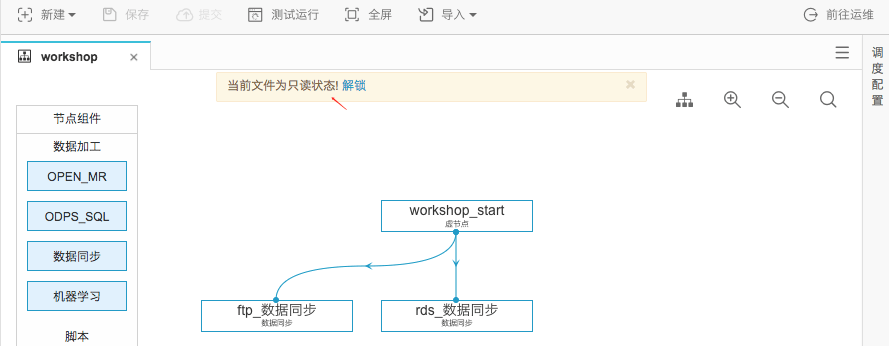
提交成功后工作流任务处于只读状态,如下:
测试运行工作流任务
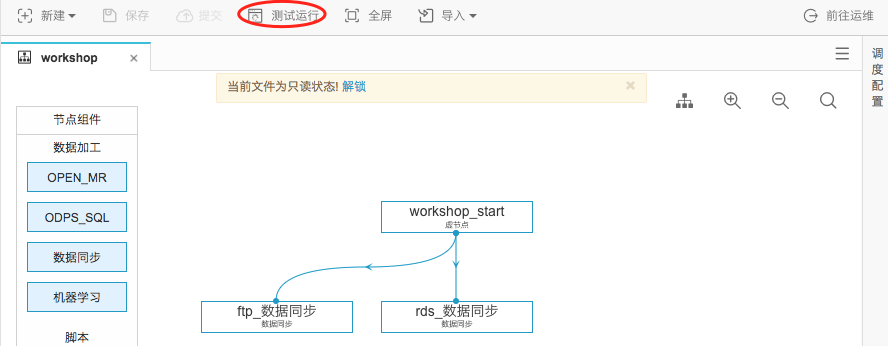
- step1:点击测试运行。

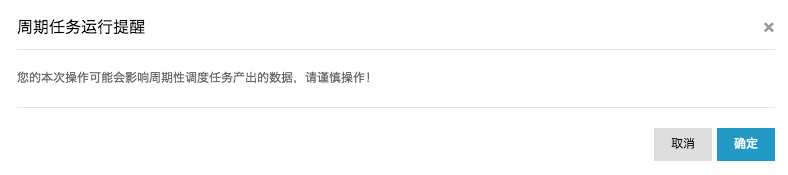
- step2:在周期任务运行提醒弹出框点击确定。

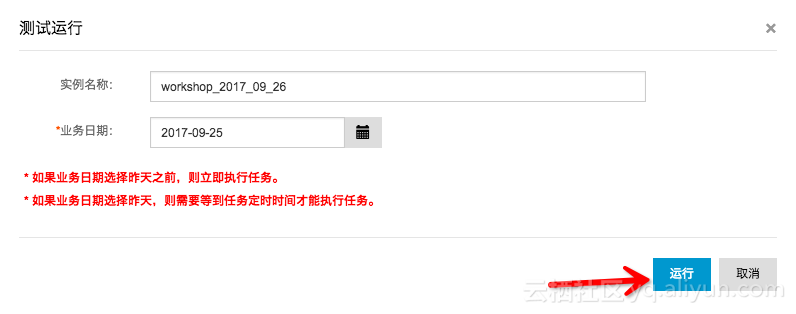
- step3:在测试运行弹出框中,实例名称和业务日期都保持默认,点击运行。

- step4:在工作流任务测试运行弹出框中,点击前往运维中心。
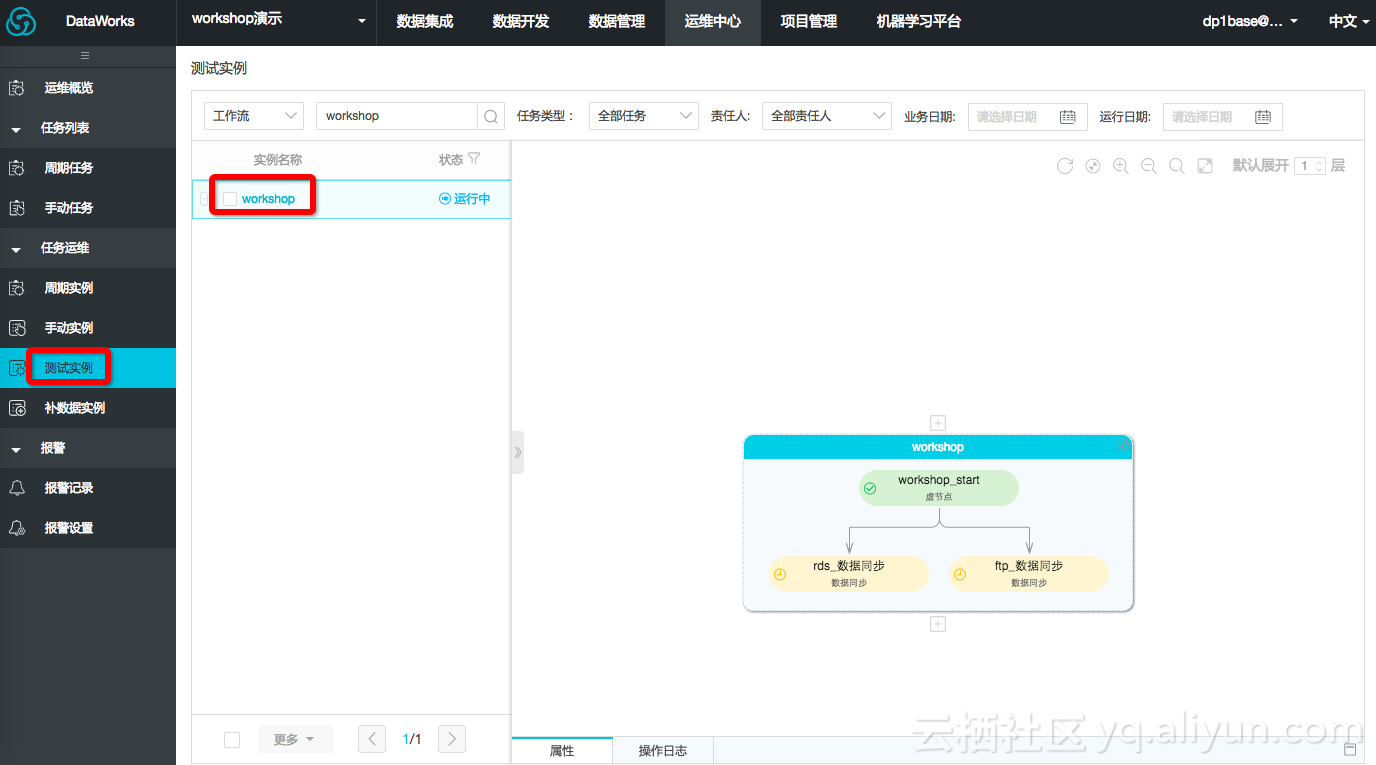
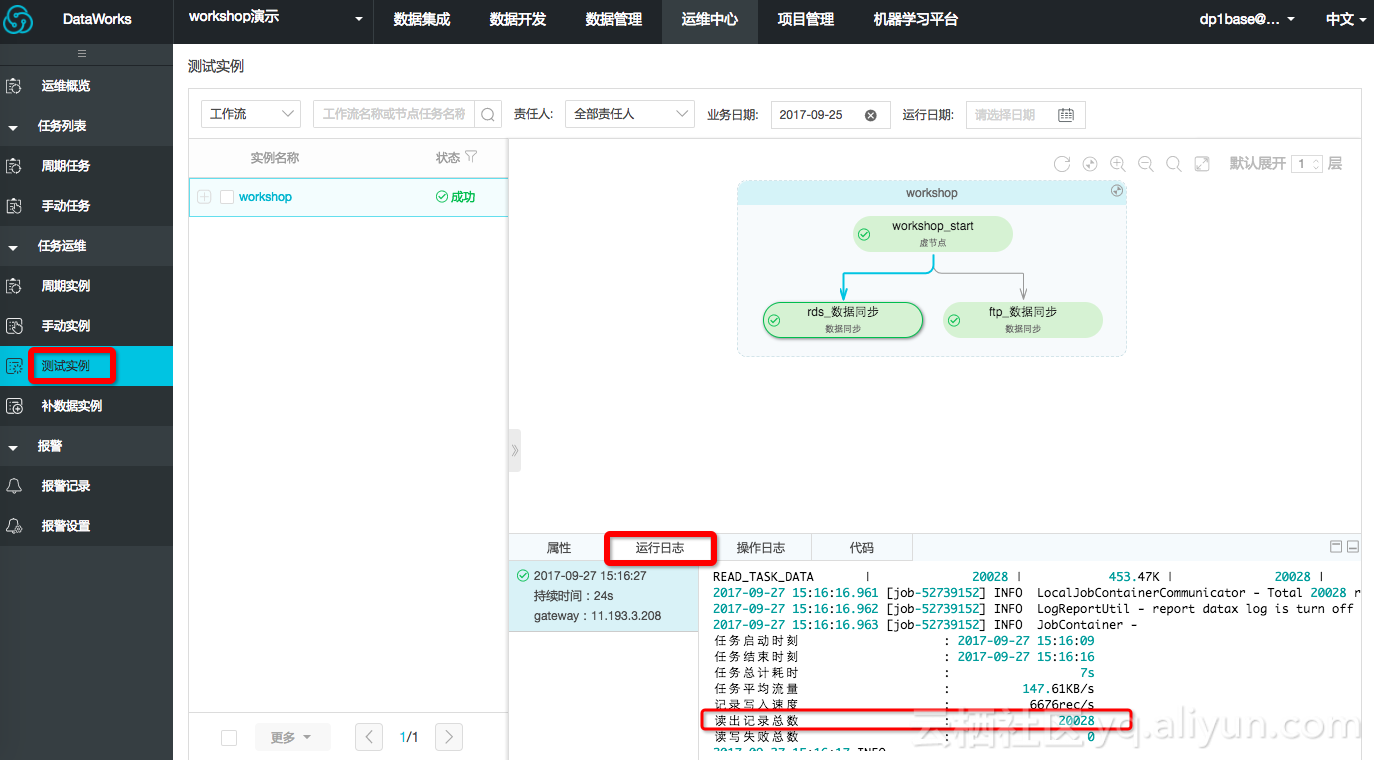
在运维中心可以查看任务视图,如下图表示该工作流任务(名称为workshop_start)正在运行。
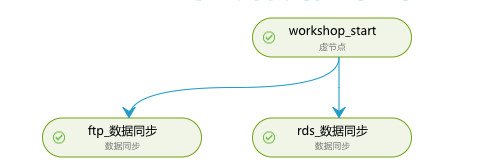
直至所有节点都运行返回成功状态即可(需要点击运维视窗中的刷新按钮查看实时状态)。如下所示:
- step5:点击节点,查看运行日志。

确认数据是否成功导入MaxCompute
- step1:返回到create_table_ddl脚本文件中。
- step2:编写并执行sql语句查看导入ods_raw_log_d记录数。

- step3:同样编写并执行sql语句查看导入ods_user_info_d记录数。
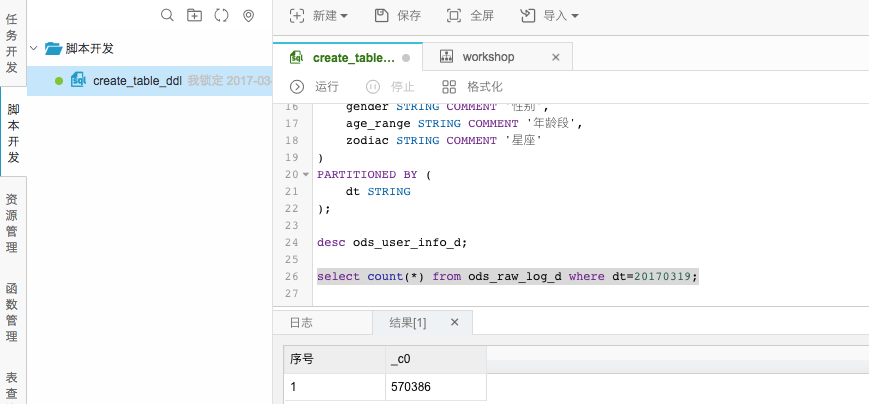
附录:SQL语句如下,其中分区键需要更新为业务日期,如测试运行任务的日期为20171011,那么业务日期为20171010。
--查看是否成功写入MaxCompute
select count(*) from ods_raw_log_d where dt=业务日期;
select count(*) from ods_user_info_d where dt=业务日期;>>>点击进入>>>《数据加工:用户画像》篇