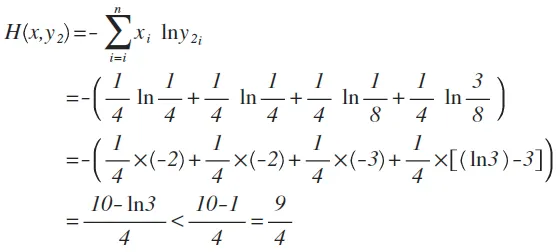归一化(softmax)、信息熵、交叉熵

简介: 机器学习中经常遇到这几个概念,用大白话解释一下: 一、归一化 把几个数量级不同的数据,放在一起比较(或者画在一个数轴上),比如:一条河的长度几千甚至上万km,与一个人的高度1.7m,放在一起,人的高度几乎可以被忽略,所以为了方便比较,缩小他们的差距,但又能看出二者的大小关系,可以找一个方法进行转换。

机器学习中经常遇到这几个概念,用大白话解释一下:

一、归一化

把几个数量级不同的数据,放在一起比较(或者画在一个数轴上),比如:一条河的长度几千甚至上万km,与一个人的高度1.7m,放在一起,人的高度几乎可以被忽略,所以为了方便比较,缩小他们的差距,但又能看出二者的大小关系,可以找一个方法进行转换。

另外,在多分类预测时,比如:一张图,要预测它是猫,或是狗,或是人,或是其它什么,每个分类都有一个预测的概率,比如是猫的概率是0.7,狗的概率是0.1,人的概率是0.2... , 概率通常是0到1之间的数字,如果我们算出的结果,不在这个范围,比如:700,10,2 ,甚至负数,这样就需要找个方法,将其转换成0-1之间的概率小数,而且通常为了满足统计分布,这些概率的和,应该是1。
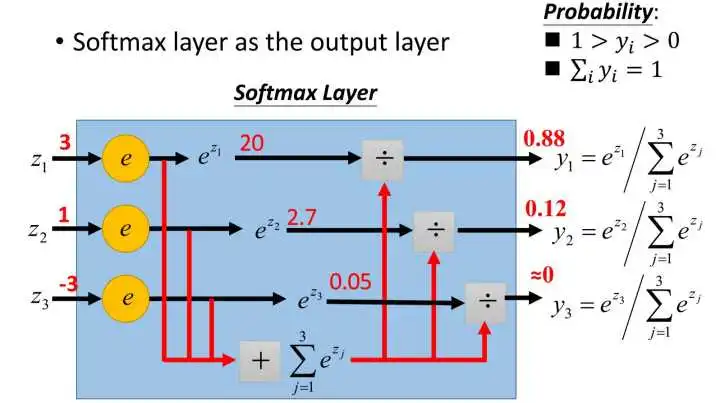
最常用的处理方法,就是softmax,原理如上图(网上淘来的)。
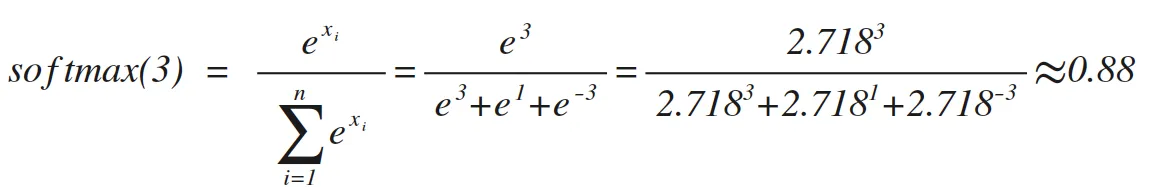
点击看原图

类似的softmax(1)=0.12,softmax(-3)=0,这个方法在数学上没毛病,但是在实际运用中,如果目标值x很大,比如10000,那e的10000次方,很可能超出编程语言的表示范围,所以通常做softmax前,要对数据做一下预处理(比如:对于分类预测,最简单的办法,所有训练集整体按比例缩小) 


二、信息熵

热力学中的热熵是表示分子状态混乱程度的物理量,而且还有一个所谓『熵增原理』,即:宇宙中的熵总是增加的,换句话说,分子状态总是从有序变成无序,热量总是从高温部分向低温部分传递。 香农借用了这个概念,用信息熵来描述信源的不确定度。

简单点说,一个信息源越不确定,里面蕴含的信息量越大。举个例子:吴京《战狼2》大获成功后,说要续拍《战狼3》,但是没说谁当女主角,于是就有各种猜测,各种可能性,即:信息量很大。但是没过多久,吴京宣布女主角确定后,大家就不用再猜测女主角了,信息量相比就没这么大了。

这个例子中,每种猜测的可能性其实就是概率,而信息量如何衡量,可以用下面的公式来量化计算,算出来的值即信息熵:
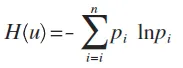
 

这里p为概率,最后算出来的结果通常以bit为单位。

举例:拿计算机领域最常现的编码问题来说,如果有A、B、C、D这四个字符组成的内容,每个字符出现的概率都是1/4,即概率分布为{1/4,1/4,1/4,1/4},设计一个最短的编码方案来表示一组数据,套用刚才的公式:
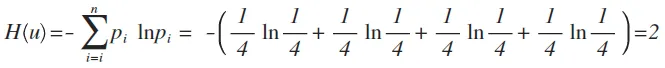
即:2个bit,其实不用算也能想明白,如果第1位0表示A,1表示B;第2位0表示C,1表示D,2位编码搞定。

如果概率变了,比如A、B、C、D出现的概率是{1,1,1/2,1/2},即:每次A、B必然出现,C、D出现机会各占一半,这样只要1位就可以了。1表示C,0表示D,因为AB必然出现,不用表示都知道肯定要附加上AB,套用公式算出来的结果也是如此。
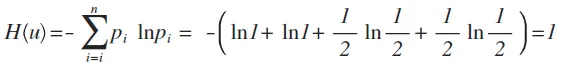
 

三、交叉熵 
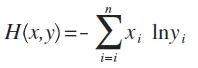
 

这是公式定义,x、y都是表示概率分布(注:也有很多文章喜欢用p、q来表示),这个东西能干嘛呢?

假设x是正确的概率分布,而y是我们预测出来的概率分布,这个公式算出来的结果,表示y与正确答案x之间的错误程度(即:y错得有多离谱),结果值越小,表示y越准确,与x越接近。

比如:

x的概率分布为:{1/4 ,1/4,1/4,1/4},现在我们通常机器学习,预测出来二组值:

y1的概率分布为  {1/4 ,  1/2 , 1/8 , 1/8}

y2的概率分布为  {1/4 ,  1/4 , 1/8 , 3/8}

从直觉上看,y2分布中,前2项都100%预测对了,而y1只有第1项100%对,所以y2感觉更准确,看看公式算下来,是不是符合直觉:
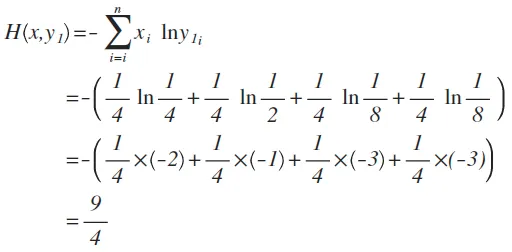


对比结果,H(x,y1)算出来的值为9/4,而H(x,y2)的值略小于9/4,根据刚才的解释,交叉熵越小,表示这二个分布越接近,所以机器学习中,经常拿交叉熵来做为损失函数(loss function)。 


参考文章:

https://www.zhihu.com/question/23765351
https://www.zhihu.com/question/41252833/answer/108777563
https://www.zhihu.com/question/22178202

目录
相关文章
|
1月前
|
人工智能 测试技术 API
最近全网爆火的 Jev 到底是什么?适合干什么、怎么用,一篇讲透!
Jev是TypeSafe AI推出的“系统一模型”,不生成文本,专做毫秒级结构化决策:Choice(多选)、Score(打分)、Noul(是非概率)。响应快193倍、成本低444倍,适合工单路由、内容审核、测试定级等高频判断场景。
2996 4
最近全网爆火的 Jev 到底是什么?适合干什么、怎么用,一篇讲透!
|
1月前
|
存储 人工智能 算法
大模型长期记忆系统设计:记忆压缩、去重、动态遗忘、时间衰减与冲突处理应用实践24.0
本文系统阐述大模型记忆引擎设计,提出瞬时/短期/长期三层记忆架构,涵盖压缩精简、语义去重、版本更新、时间衰减与冲突消解等全生命周期治理机制,强调其非简单数据库,而是模拟人脑规律的智能信息筛选与管理能力。
207 3
|
3月前
|
人工智能 搜索推荐 API
什么是 Ontology?用一个电商例子讲清楚“本体论”
Ontology(本体)在AI中并非哲学玄谈,而是对领域知识的结构化定义:明确概念、关系、属性与规则,为机器提供可理解、可推理的“知识骨架”,赋能RAG、知识图谱、AI Agent等场景。(239字)
1239 1
|
4月前
|
人工智能 运维 机器人
RAG、Agentic RAG 和 AI Memory 到底有什么区别?
它们合在一起,回答的是同一个问题:AI 怎么从“回答当前问题”,变成“参与长期工作”。RAG 让它会查资料;Agentic RAG 让它更会查资料;Memory 让它能带着过去的上下文继续工作。当这三者组合起来,AI 才更像一个长期协作的助手,而不只是一个每次都要重新介绍背景的聊天窗口。
461 0
RAG、Agentic RAG 和 AI Memory 到底有什么区别?
|
6月前
|
存储 机器学习/深度学习 编解码
「纯干货」几万字都讲不明白的Memory架构与思考
本文讲述作者对 Memory 的一些理解与思考。(文章内容基于作者个人技术实践与独立思考,旨在分享经验,仅代表个人观点。)
「纯干货」几万字都讲不明白的Memory架构与思考
|
6月前
|
存储 大数据 数据库
GraphRAG技术探究及实践路径
在大语言模型广泛应用的当下,检索增强生成(RAG)技术成为提升模型回答准确性、降低幻觉的核心手段,而GraphRAG(基于图的检索增强生成) 作为 RAG 技术的进阶形态,将知识图谱与大语言模型深度融合,凭借强大的推理能力和可解释性,成为复杂知识问答、关系分析场景的关键解决方案。本文从基础认知、前沿技术、实践路径三大维度,全面解析 GraphRAG 技术,探索其落地应用的核心思路。
|
机器学习/深度学习 存储 自然语言处理
从理论到实践:如何使用长短期记忆网络(LSTM)改善自然语言处理任务
【10月更文挑战第7天】随着深度学习技术的发展,循环神经网络(RNNs)及其变体,特别是长短期记忆网络(LSTMs),已经成为处理序列数据的强大工具。在自然语言处理(NLP)领域,LSTM因其能够捕捉文本中的长期依赖关系而变得尤为重要。本文将介绍LSTM的基本原理,并通过具体的代码示例来展示如何在实际的NLP任务中应用LSTM。
1619 4
|
机器学习/深度学习 人工智能 自然语言处理
6.1 自然语言处理综述
这篇文章综述了自然语言处理(NLP)的发展历程、主要挑战、常见任务,并探讨了如何利用深度学习和飞桨框架来解决NLP任务,同时提出了对NLP未来应用的思考。
|
存储 Java 索引
Java数组的地址值与元素访问技术
Java数组的地址值与元素访问技术
394 2
|
机器学习/深度学习 算法 数据挖掘
机器学习十大经典算法之K-Means聚类算法