在不久前结束的2017浪潮云数据中心全国合作伙伴大会(IPF)上,浪潮秉承坚持围绕"计算+"战略,进一步明确业务重心,聚焦智慧计算,发展开放融合的计算生态,建立智慧计算市场的领导力。
智慧计算的未来在商业应用, 随着人工智能应用的快速发展,AI所需的计算力也急剧攀升。此前,浪潮就已在AI计算平台、架构领域布局,拥有业界完整的支持2、4、8 GPU卡的异构超算服务器阵列。而本次IPF上,浪潮发布了业界最高密度的、单机点支持16块GPU卡的SR-AI整机柜,进一步优化了AI计算硬件架构,改变原有CPU-GPU紧耦合状态,实现GPU资源的灵活池化扩容。
人工智能成为未来社会发展重要动因
更复杂的AI应用呼唤更强大的计算平台
深度学习概念和浅层学习算法已经被提出多年,而人工智能近年才开始逐渐升温,原因是人工智能技术的进步受限于计算平台的性能和数据量的积累。举个例子,从IBM深蓝战胜卡斯帕罗夫,浪潮天梭战胜五位象棋大师,再到谷歌AlphaGo战胜围棋冠军李世石,解决问题的博弈树空间扩大了237数量级,这其中需要更优化的算法,也需要更强大的计算平台来支撑实时运算。
除了AI游戏,在现实生活中人工智能的应用也越来越广泛和复杂,从人脸签到打卡,到行动轨迹追踪,再到无人驾驶汽车,更复杂的AI应用呼唤更强大的计算平台。传统的单机单卡、2卡甚至8卡已经不能满足多样化的业务需求,浪潮SR-AI整机柜服务器以单节点16卡的更高密度,满足当下快速膨胀的AI计算能力需求。
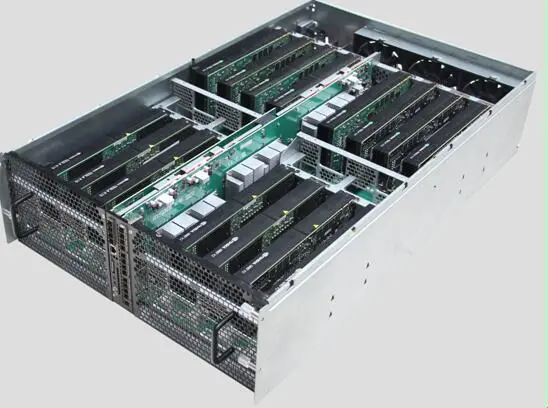
SR-AI整机柜服务器
更高密度+资源解耦,10倍于传统AI计算设备性能
此次,浪潮与百度联合发布的SR-AI整机柜服务器,符合最新的天蝎2.5标准,是全球首个采用PCIe Fabric互联架构设计的AI方案,通过PCI-E交换机和GPU BOX两个模块的配合,打破GPU和CPU的物理耦合,让两者可以灵活扩展,相对于传统的GPU服务器,这是种颠覆式的创新,带来了高密度、低延迟、易扩展等优势。
首先,传统的AI计算设备集群需要通过高速网络实现数据的交互,着会带来us级以上的延迟,而SR-AI整机柜中GPU BOX间的互联是通过PCI-E交换机来实现,并借助GPUDirect RDMA技术可以大幅下降跨节点GPU间的通信延迟,能够实现ns级网络延时。
第二,SR-AI整机柜的I/O BOX单节点即可实现支持16个GPU的超大扩展,并且可以通过PCI-E交换机实现4个BOX、64块GPU的级联,峰值处理能力达到为512TFlops。
第三,SR-AI整机柜的GPU资源扩展无需同步配置高成本的IT资源(比如IB交换机),成本可优化5%以上,并随着规模上升成本优势越明显。
SR-AI整机柜是面向更大规模数据集和深层神经网络的超大规模AI计算平台,能够高效支撑复杂的深度学习线下模型训练任务,适用于图像识别、语音识别、自然语言处理、搜索排序等AI应用。百度实际业务的测试数据显示,SR-AI整机柜相比传统的AI方案性能提高5-10倍!
高效开发框架+算法协同优化,AI计算效率最大化
与 CPU 少量的逻辑运算单元相比,GPUFPGAMIC这种协处理加速设备整个就是一个庞大的计算矩阵,可实现 10-100 倍应用吞吐量。但同时,这种庞大的并行能力需要付出代价:需要较强的软件开发能力和算法优化能力。
为此,浪潮将高效深度学习框架Caffe-MPI开源,与众多开发者共同优化,为深度学习的用户提供了更便捷、更高效的应用手段。浪潮Caffe-MPI能够在保证正确率相同的情况下,在4节点下16卡的性能较单卡提升13倍,并增加了对cuDNN库的支持,使程序开发人员能够轻松实现高性能深度学习代码的开发。
在算法方面,此前浪潮与客户在GPU加速加速流量特征分析技术开展合作,通过软硬件和算法的协同优化,使训练24万样本的时间单节点4GPU相对于单GPU加速3倍,单机4GPU卡程序性能较原始版本加速270倍。
数据显示,2016年浪潮在人工智能计算领域的市场份额超过60%,为百度、阿里巴巴、腾讯、奇虎、科大讯飞、Face++等中国人工智能企业,提供基于GPU、FPGA、KNL等协处理加速服务器和caffe-MPI等软件、算法优化。
原文发布时间为: 2017年5月11日
本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。