背景:
PySpider:一个国人编写的强大的网络爬虫系统并带有强大的WebUI。采用Python语言编写,分布式架构,支持多种数据库后端,强大的WebUI支持脚本编辑器,任务监视器,项目管理器以及结果查看器。在线示例: http://demo.pyspider.org/
官方文档: http://docs.pyspider.org/en/l...
Github : https://github.com/binux/pysp...
本文爬虫代码 Github 地址:https://github.com/zhisheng17...
更多精彩文章可以在微信公众号:猿blog 阅读到,欢迎关注。
说了这么多,我们还是来看正文吧!
前提:
你已经安装好了Pyspider 和 MySQL-python(保存数据)
如果你还没安装的话,请看看我的前一篇文章,防止你也走弯路。
我所遇到的一些错误:

首先,本爬虫目标:使用 Pyspider 框架爬取 V2EX 网站的帖子中的问题和内容,然后将爬取的数据保存在本地。
V2EX 中大部分的帖子查看是不需要登录的,当然也有些帖子是需要登陆后才能够查看的。(因为后来爬取的时候发现一直 error ,查看具体原因后才知道是需要登录的才可以查看那些帖子的)所以我觉得没必要用到 Cookie,当然如果你非得要登录,那也很简单,简单地方法就是添加你登录后的 cookie 了。
我们在 https://www.v2ex.com/ 扫了一遍,发现并没有一个列表能包含所有的帖子,只能退而求其次,通过抓取分类下的所有的标签列表页,来遍历所有的帖子: https://www.v2ex.com/?tab=tech 然后是 https://www.v2ex.com/go/progr... 最后每个帖子的详情地址是 (举例): https://www.v2ex.com/t/314683...
创建一个项目
在 pyspider 的 dashboard 的右下角,点击 “Create” 按钮

替换 on_start 函数的 self.crawl 的 URL:
- @every(minutes=24 * 60)
- def on_start(self):
- self.crawl('https://www.v2ex.com/', callback=self.index_page, validate_cert=False)
- self.crawl 告诉 pyspider 抓取指定页面,然后使用 callback 函数对结果进行解析。
- @every) 修饰器,表示 on_start 每天会执行一次,这样就能抓到最新的帖子了。
- validate_cert=False 一定要这样,否则会报 HTTP 599: SSL certificate problem: unable to get local issuer certificate错误
首页:
点击绿色的 run 执行,你会看到 follows 上面有一个红色的 1,切换到 follows 面板,点击绿色的播放按钮:
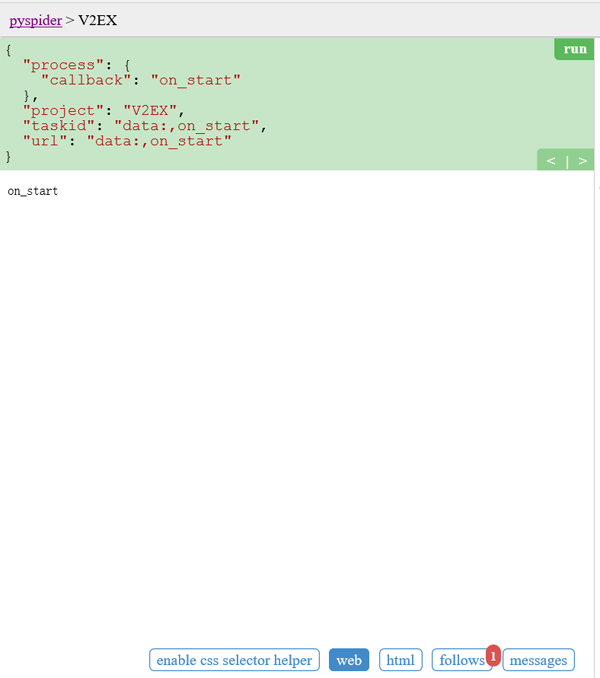
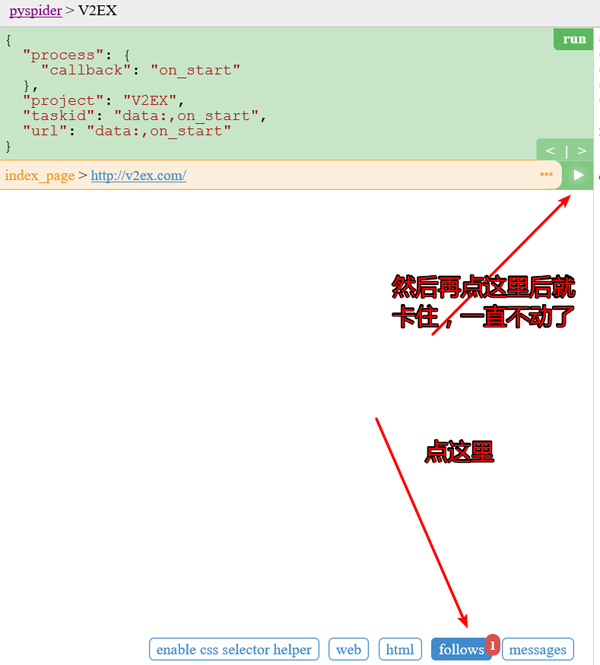
第二张截图一开始是出现这个问题了,解决办法看前面写的文章,后来问题就不再会出现了。
Tab 列表页 :
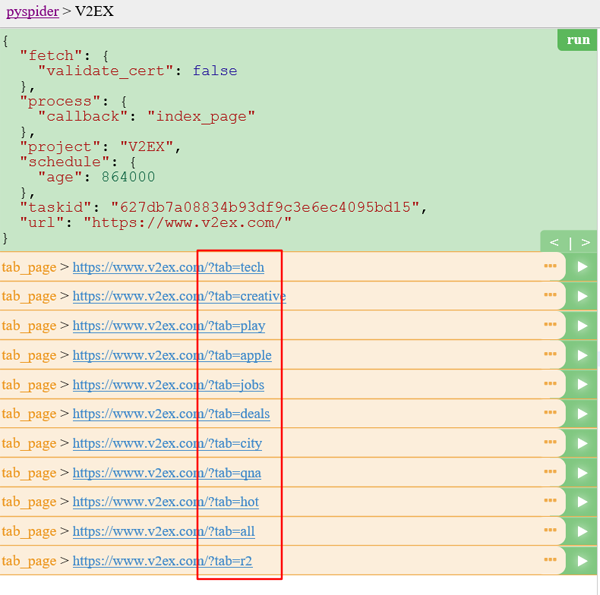
在 tab 列表页 中,我们需要提取出所有的主题列表页 的 URL。你可能已经发现了,sample handler 已经提取了非常多大的 URL
代码:
- @config(age=10 * 24 * 60 * 60)
- def index_page(self, response):
- for each in response.doc('a[href^="https://www.v2ex.com/?tab="]').items():
- self.crawl(each.attr.href, callback=self.tab_page, validate_cert=False)
- 由于帖子列表页和 tab列表页长的并不一样,在这里新建了一个 callback 为 self.tab_page
- @config(age=10 24 60 * 60) 在这表示我们认为 10 天内页面有效,不会再次进行更新抓取
Go列表页 :
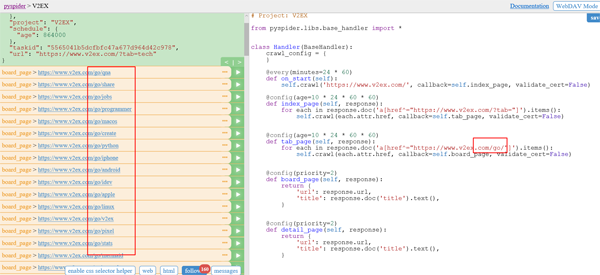
代码:
- @config(age=10 * 24 * 60 * 60)
- def tab_page(self, response):
- for each in response.doc('a[href^="https://www.v2ex.com/go/"]').items():
- self.crawl(each.attr.href, callback=self.board_page, validate_cert=False)
帖子详情页(T):

你可以看到结果里面出现了一些reply的东西,对于这些我们是可以不需要的,我们可以去掉。
同时我们还需要让他自己实现自动翻页功能。
代码:
- @config(age=10 * 24 * 60 * 60)
- def board_page(self, response):
- for each in response.doc('a[href^="https://www.v2ex.com/t/"]').items():
- url = each.attr.href
- if url.find('#reply')>0:
- url = url[0:url.find('#')]
- self.crawl(url, callback=self.detail_page, validate_cert=False)
- for each in response.doc('a.page_normal').items():
- self.crawl(each.attr.href, callback=self.board_page, validate_cert=False) #实现自动翻页功能
去掉后的运行截图:
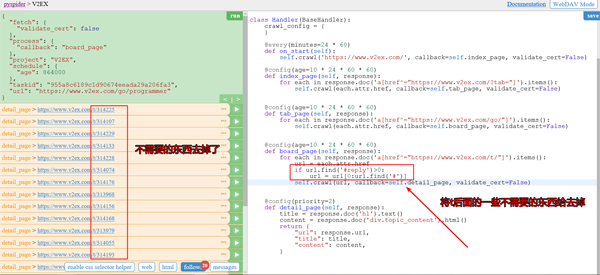
实现自动翻页后的截图:

此时我们已经可以匹配了所有的帖子的 url 了。
点击每个帖子后面的按钮就可以查看帖子具体详情了。
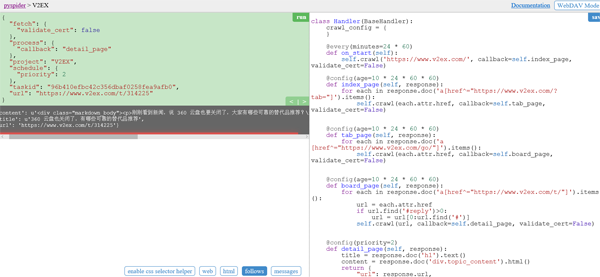
代码:
- @config(priority=2)
- def detail_page(self, response):
- title = response.doc('h1').text()
- content = response.doc('div.topic_content').html().replace('"', '\\"')
- self.add_question(title, content) #插入数据库
- return {
- "url": response.url,
- "title": title,
- "content": content,
- }
插入数据库的话,需要我们在之前定义一个add_question函数。
- #连接数据库
- def __init__(self):
- self.db = MySQLdb.connect('localhost', 'root', 'root', 'wenda', charset='utf8')
- def add_question(self, title, content):
- try:
- cursor = self.db.cursor()
- sql = 'insert into question(title, content, user_id, created_date, comment_count) values ("%s","%s",%d, %s, 0)' % (title, content, random.randint(1, 10) , 'now()'); #插入数据库的SQL语句
- print sql
- cursor.execute(sql)
- print cursor.lastrowid
- self.db.commit()
- except Exception, e:
- print e
- self.db.rollback()
查看爬虫运行结果:
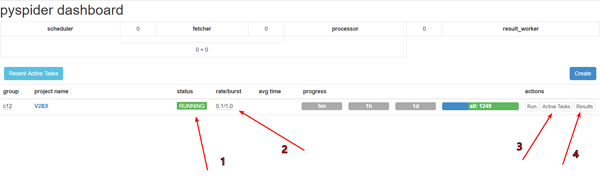
先debug下,再调成running。pyspider框架在windows下的bug
设置跑的速度,建议不要跑的太快,否则很容易被发现是爬虫的,人家就会把你的IP给封掉的
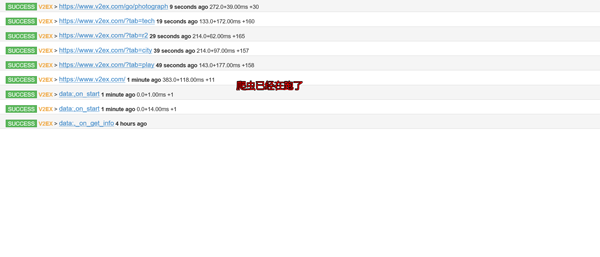
查看运行工作
查看爬取下来的内容
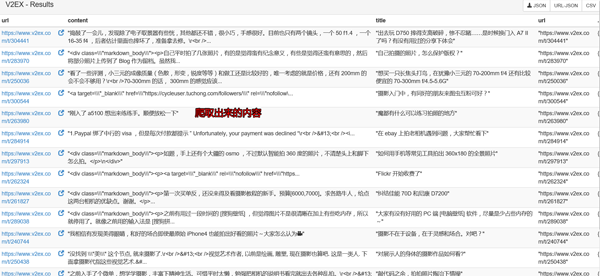
然后再本地数据库GUI软件上查询下就可以看到数据已经保存到本地了。
自己需要用的话就可以导入出来了。
在开头我就告诉大家爬虫的代码了,如果详细的看看那个project,你就会找到我上传的爬取数据了。(仅供学习使用,切勿商用!)
当然你还会看到其他的爬虫代码的了,如果你觉得不错可以给个 Star,或者你也感兴趣的话,你可以fork我的项目,和我一起学习,这个项目长期更新下去。
最后:
代码:
- # created by 10412
- # !/usr/bin/env python
- # -*- encoding: utf-8 -*-
- # Created on 2016-10-20 20:43:00
- # Project: V2EX
- from pyspider.libs.base_handler import *
- import re
- import random
- import MySQLdb
- class Handler(BaseHandler):
- crawl_config = {
- }
- def __init__(self):
- self.db = MySQLdb.connect('localhost', 'root', 'root', 'wenda', charset='utf8')
- def add_question(self, title, content):
- try:
- cursor = self.db.cursor()
- sql = 'insert into question(title, content, user_id, created_date, comment_count) values ("%s","%s",%d, %s, 0)' % (title, content, random.randint(1, 10) , 'now()');
- print sql
- cursor.execute(sql)
- print cursor.lastrowid
- self.db.commit()
- except Exception, e:
- print e
- self.db.rollback()
- @every(minutes=24 * 60)
- def on_start(self):
- self.crawl('https://www.v2ex.com/', callback=self.index_page, validate_cert=False)
- @config(age=10 * 24 * 60 * 60)
- def index_page(self, response):
- for each in response.doc('a[href^="https://www.v2ex.com/?tab="]').items():
- self.crawl(each.attr.href, callback=self.tab_page, validate_cert=False)
- @config(age=10 * 24 * 60 * 60)
- def tab_page(self, response):
- for each in response.doc('a[href^="https://www.v2ex.com/go/"]').items():
- self.crawl(each.attr.href, callback=self.board_page, validate_cert=False)
- @config(age=10 * 24 * 60 * 60)
- def board_page(self, response):
- for each in response.doc('a[href^="https://www.v2ex.com/t/"]').items():
- url = each.attr.href
- if url.find('#reply')>0:
- url = url[0:url.find('#')]
- self.crawl(url, callback=self.detail_page, validate_cert=False)
- for each in response.doc('a.page_normal').items():
- self.crawl(each.attr.href, callback=self.board_page, validate_cert=False)
- @config(priority=2)
- def detail_page(self, response):
- title = response.doc('h1').text()
- content = response.doc('div.topic_content').html().replace('"', '\\"')
- self.add_question(title, content) #插入数据库
- return {
- "url": response.url,
- "title": title,
- "content": content,
- }
作者:猿blog
来源:51CTO