
从分支、弹性与多租户,到业务语义与 Agent 运行时
演讲嘉宾:王廓,阿里云智能集团数据库产品事业部产品专家
当 Agent 能够快速生成应用,数据库面临的变化就不只是调用方式:应用数量增长更快,生命周期难以预测,开发过程需要反复试错,业务数据也需要提供明确的语义。
2026 年 9 月 23 日,在云栖大会“为 Agent 重构数据库:Agentic Database 的架构与实践”分论坛,阿里云智能集团数据库产品事业部产品专家王廓分享了《RDS Supabase:从数据底座出发,驱动 Agent 全栈进化》:RDS Supabase 的规模化实践,以及从应用后端向 Agent 数据、知识与运行环境延伸的探索。
阿里云智能集团数据库产品事业部产品专家王廓在 2026 年云栖大会现场分享
点击下方视频链接,观看王廓关于 RDS Supabase 与 Agent 数据底座的完整分享。
https://cloud.video.taobao.com/vod/tGZBEp_bEoD5xTUPff2yzC3BlupYcs1OmPYILBvvS-c.mp4
以下为王廓的演讲实录:
01 从减少后端依赖,到构建可控的 Agent 应用环境
过去一年,RDS PostgreSQL 的实例规模快速增长,RDS Supabase 是其中的重要推动因素。截至本次大会,云上已有超过 15 万个 RDS Supabase 实例。今天,我想分享我们如何支撑这些实例,以及对 Agentic Database 的进一步探索。
去年发布 RDS Supabase 时,我们关注如何减少 AI 开发应用时的出错环节。今年,关注点进一步转向 Harness,也就是组织 Agent 工具、运行环境和执行约束的机制,让执行过程更可控。
Supabase 通过统一客户端、SDK(软件开发工具包)及 MCP(模型上下文协议)等接口,提供认证、数据读写、实时消息、对象存储和 Edge Functions 边缘函数等后端能力,减少 Agent 重复编写样板代码的工作。应用完成开发后,还可以利用 RDS 托管与配套部署服务继续推进上线。
02 开源 Supabase 之上,补齐企业级数据与基础设施能力
RDS Supabase 在兼容开源 Supabase 生态的基础上,结合了 RDS PostgreSQL 和阿里云基础设施。底层提供 Serverless、计算与存储弹性、高性能云盘和安全容器;数据内核提供基于 pgvector 的向量能力、基于 Apache AGE 的图能力,以及结合 DuckDB 的分析能力。
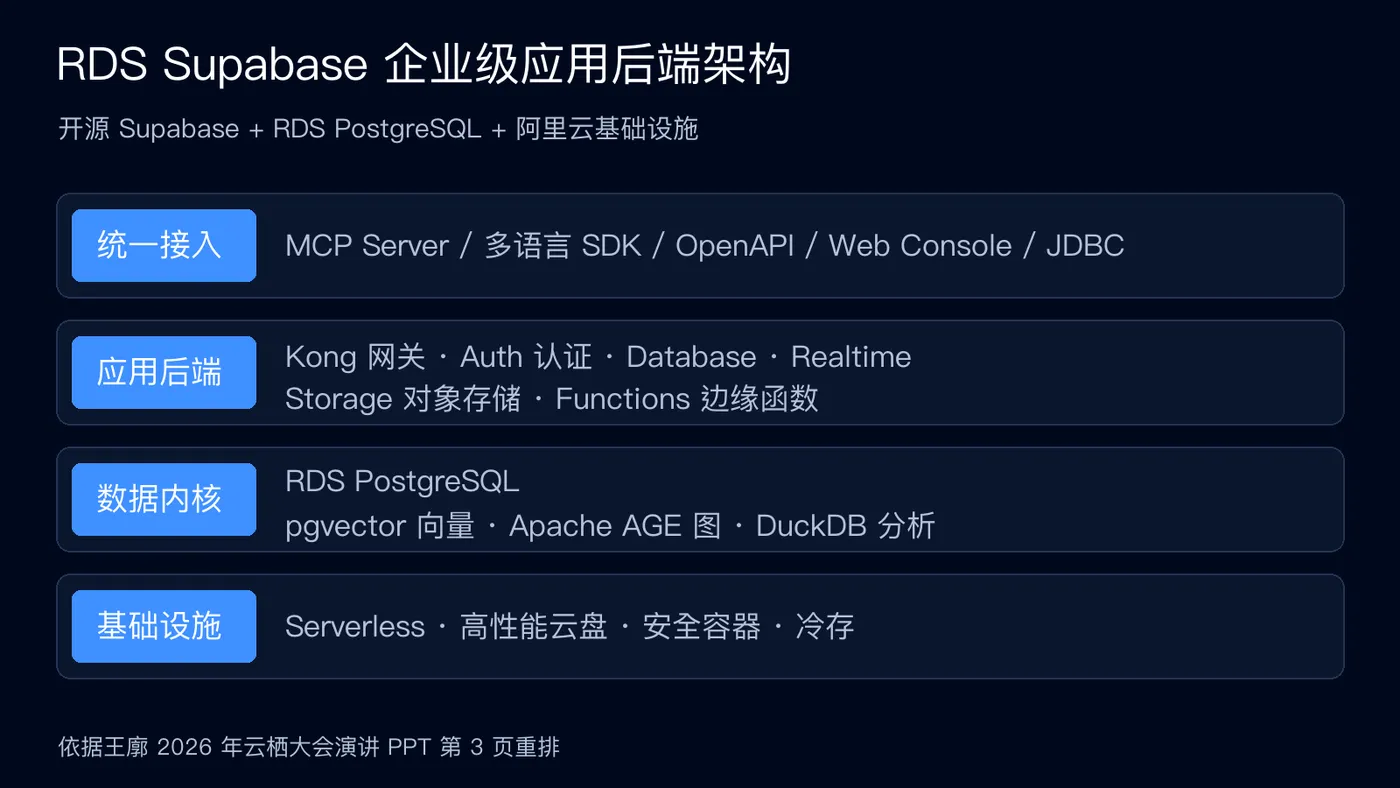
RDS Supabase 的企业级应用后端架构
与开放平台客户交流时,我们看到,他们既要承载开发者各不相同的库表结构,也要考虑后续如何让 Agent 使用应用和数据。PostgreSQL 的数据能力与 Supabase 的统一后端接口,为这些需求提供了基础。随着应用数量增长,我们又围绕分支、弹性和多租户,降低试错与运行成本。
03 数据分支:让代码与 Schema 沿同一套版本演进
Agent 接手应用时,库表定义是理解业务上下文的直接入口。应用迭代中,DDL(数据定义语言)与 Schema(数据库结构)的变化,也需要和代码版本配合。
例如,Agent 将代码更新到 V3,并删除了 cover_image 列;此后只把代码回滚到 V1,旧代码依赖的列不会自动恢复。通过数据分支,我们可以为不同版本保留数据库环境。回退代码时,切换到对应版本的数据库分支,使代码与 Schema 保持一致。也可以从 V1 创建新分支,尝试另一种实现。分支能力还支持合并不同版本的 DDL 变更。
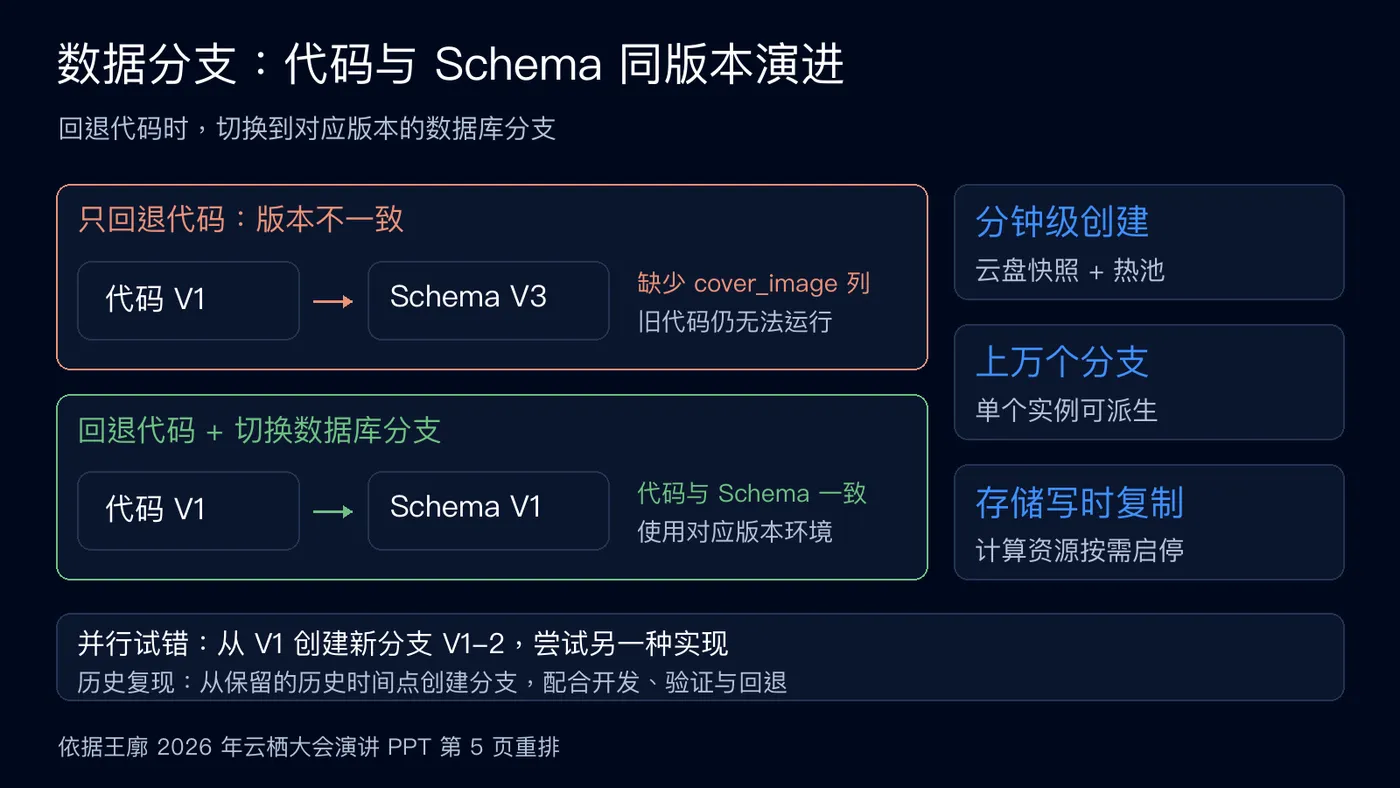
数据分支支持代码与 Schema 的版本配合及并行试错
我们利用高性能云盘与快照快速克隆分支,可在分钟级创建,结合热池还能缩短准备时间。单个实例可以派生上万个分支实例,但不必全部常驻运行:分支先保留存储状态,计算按需启动,存储采用写时复制。我们也支持从保留的历史时间点创建分支,用于开发、验证和回退。
04 弹性与冷热池:适应难以预测的应用生命周期
Agent 生成的应用可能只使用一天,也可能长期运行,或闲置后突然被访问。为减少空转成本,我们与客户探索了休眠实例的快速唤醒:无访问时挂起计算资源,再次请求时通过预热实例池,在 3 秒内拉起。Serverless 按实际用量计费,挂起期间不产生空转计算费用,数据存储仍有成本。
在我们的冷热池实践中,连续未访问不足 14 天的应用保留在可快速拉起的池中;连续 14 天未访问则转入冷存,保留备份。冷存应用再次被访问,需要先从备份恢复出休眠实例,再进入快速唤醒流程,不能将完整恢复过程等同于 3 秒唤醒。
计算与存储还可以独立扩缩,生产实例支持在线变配和只读节点弹性扩展,按实际负载配置资源。
05 多租户:从一个应用一个实例,到一个实例承载 1000+ 项目
传统 SaaS 的租户通常使用同一套业务模型,Agent 生成的应用则可能各有库表结构。客户希望为租户提供独立的 API Key,又不希望每个租户都占用一个 PostgreSQL 实例。
我们为此提供共享实例的多租户形态:一个较大的 PostgreSQL 实例,可以承载超过 1000 个 Supabase 项目。项目保留各自的认证和存储服务能力,底层共享数据库及计算资源。
每个租户配置独立的 Schema、角色与 API 密钥,结合 RLS(行级安全策略)限制数据访问;Kong 网关执行认证、路由和租户寻址校验。备份、监控、变配与内核升级在实例维度统一处理,减少重复运维。同一实例内还可以创建租户级隔离分支,项目也可以在多租户与独享形态之间切换。
06 从 SQL 到 API,连接知识、运行环境与业务数据
Supabase 在 SQL 之外提供 API 访问后,我们开始探索,如何将知识、业务语义与 Agent 工作流通过统一接口提供给应用。
方案分为四层:接入层提供 MCP、REST API、CLI 和 IM 等入口;知识层组织 GraphRAG、Ontology 和数据 Skill;运行时层提供配套沙箱与边缘函数;底层由 RDS Supabase 承载数据库和对象存储。
业务请求到达后,可以拉起沙箱并配置运行镜像。我们在其中接入 Claude Code 等 Agent 工具,让它们访问企业知识和业务数据、完成任务。沙箱运行 Agent 程序和工具,数据库提供数据能力;知识层则连接文档及其他数据系统,补充问数和取数的上下文。
07 Ontology:让 Agent 理解业务含义,并按约束执行
Ontology(本体)通过业务对象、关系和动作组织语义。例如,P7 可能指岗位级别,也可能指车型;同样是 L9,2024 款与 2025 款的数据也可能不同。建立车型、年份与版本的关联,可以帮助 Agent 明确查询对象。
这套方案中,DataSource 负责数据接入、内容加工和元数据;Ontology 定义对象、关系、指标、规则及 Action 执行约束;In-DB Agent Runtime 组织业务 Agent、工作流和 Skill 的交付运行。
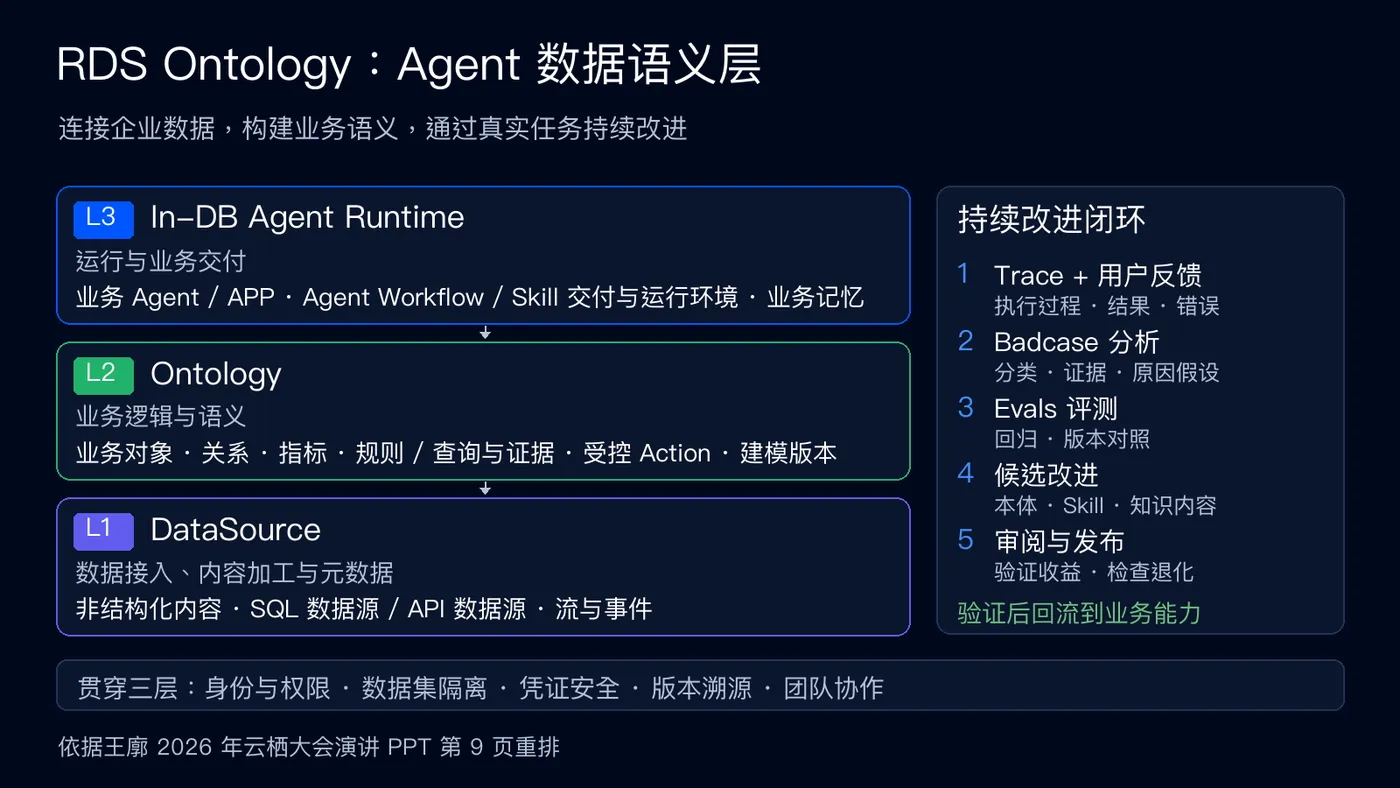
RDS Ontology 的三层架构与持续改进流程
企业不必先迁移全部数据。语义层可以连接数据库、数仓、文档、开放系统 API 和 Kafka 等消息队列。在汽车行业的毛利率分析场景中,需要关联车型、两万多个零部件、供应商与进销存系统中的成本。通过语义层组织这些关系,Agent 可以下钻分析,再通过飞书或钉钉返回结果。
我们通过建模 Agent,将本体转为语义层 Skill。工作流约束先明确指标含义与对象范围,再到业务数据库取数;Action 则结合权限、执行约束和审计管理。
语义与系统变化后,我们利用 Trace、用户反馈和错误案例分析问题,通过 Evals 进行回归与版本对照,形成候选修改,经过审阅、验证收益与检查退化后发布。身份与权限、数据集隔离、凭证安全和版本溯源贯穿三层。
08 秒悟实践:支撑 9 万+ AI 轻应用的创建与运行
秒悟 Meoo 将对话输入、代码生成和部署运行连接起来,让用户通过自然语言构建应用。截至本次大会,案例展示的线上 AI 轻应用已超过 9 万。大量应用属于低频访问,需要兼顾资源成本与再次访问时的启动体验。
本次大会展示的案例中,综合资源成本降低了 90%。这是该案例的优化结果,具体效果仍取决于访问频率、实例配置与运行方式。
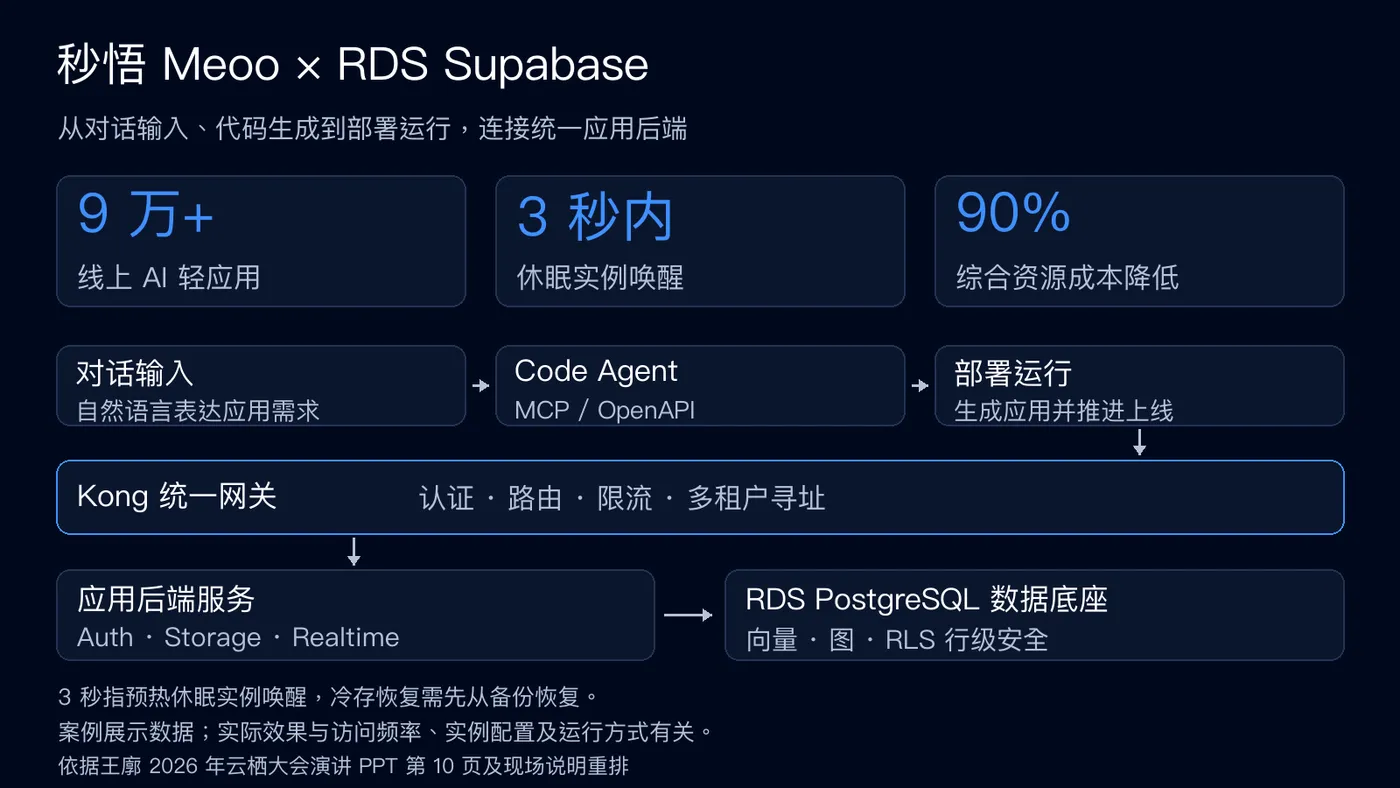
秒悟 Meoo 基于 RDS Supabase 的应用架构与实践成果
RDS Supabase 为其提供统一数据底座:Code Agent 通过 MCP 和 OpenAPI 调用后端能力,Kong 负责认证、路由、限流与多租户寻址,认证、存储和实时消息组件连接 PostgreSQL 的数据与权限体系。分支、Serverless 和多租户能力支撑应用持续创建、迭代与按需运行。
在秒悟这样的场景中,应用上线后还会不断迭代,也可能暂时闲置、随后再次被访问。我们围绕分支、Serverless 和多租户提供能力,来支撑应用的这些变化:开发时可以反复试错,运行时按负载分配资源,闲置时保留数据,再次需要时恢复使用。
了解 RDS Supabase
如果你正在为 Agent 应用选择数据与后端服务,可以点击下方链接进一步了解 RDS PostgreSQL 全托管 Supabase 的产品能力、接入方式及使用文档。
