一次普通的结账改动评审,新增了一个 pricing.ts,里面是一个 formatMoneyCents()。代码写得干净,带了单元测试,功能也跑通了。问题在于,仓库的 packages/currency/src/format.ts 里早就导出了 formatCurrency(),做的是同一件事,只是多承担了一项职责:它执行的是财务在一次真实的分币事故后签字确认的舍入规则。
新函数用了四舍五入,而不是银行家舍入。这个 PR 里没有任何测试失败。它会在几个月后、某个具体的退款总额上,安静地出错。
以上场景来自2026年11月2日一篇技术评论的描述,属于媒体账号发布的工程观察。但它描述的现象在引入 AI 编程助手后变得非常普遍,值得当成一类缺陷来对待。
为什么测试抓不到
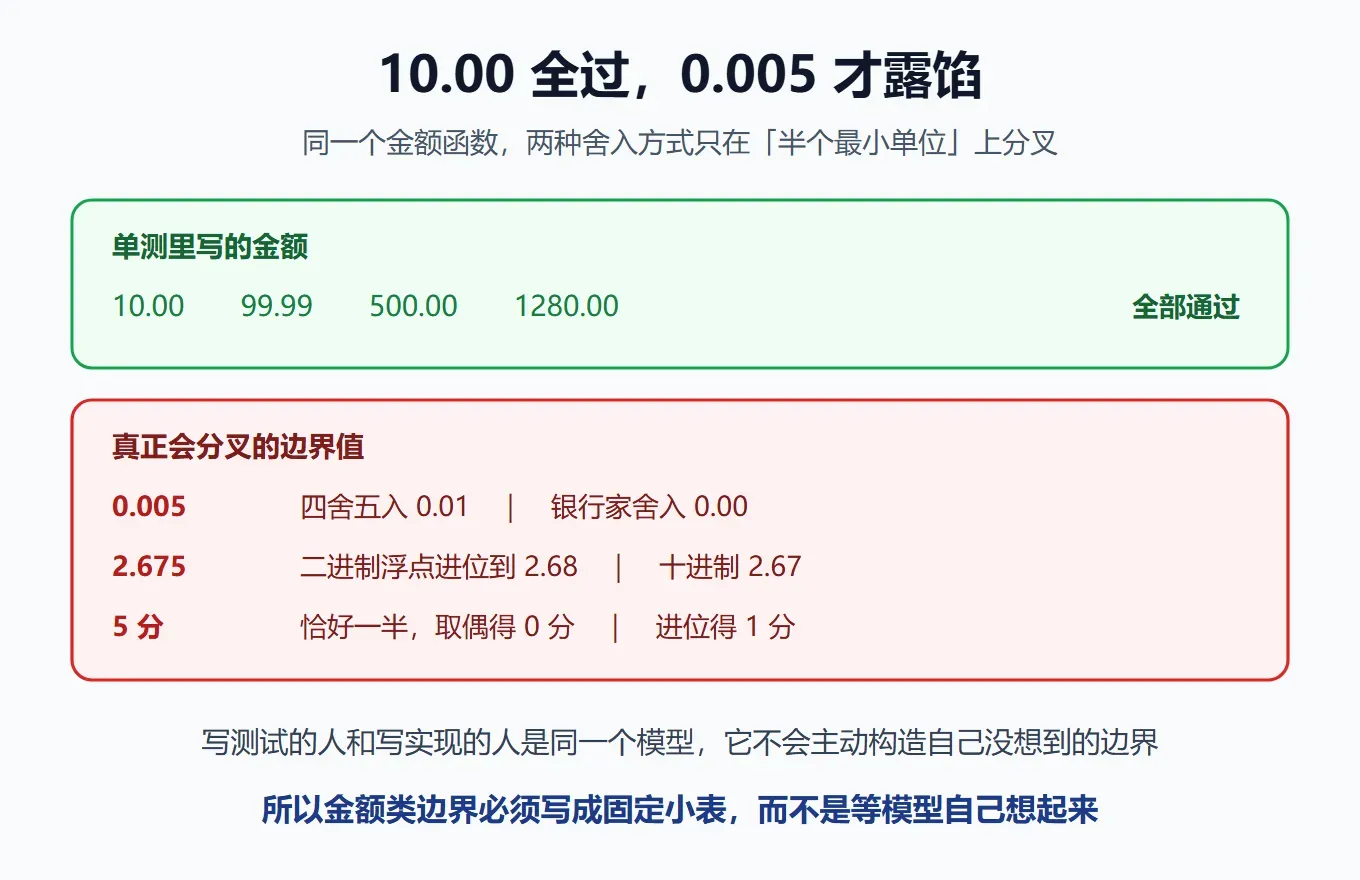
因为单测验证的是"这个函数自洽",不是"这个函数与系统里唯一的那个实现一致"。新函数的测试会用 10.00、99.99 这类常见金额,全都通过;差异只在 0.005、0.015、2.675 这类边界值上出现,而写测试的人和写实现的人是同一个模型,它不会主动去构造自己没想到的边界。
更麻烦的是,这类缺陷不会以"报错"的形式出现。金额差一分钱,接口返回 200,页面正常展示,监控没有告警。它只会在对账时出现,而那时候距离合并已经过去几周。
把"抓不到"这件事画出来,原因就一目了然——通过的和分叉的,根本不是同一批数值:
Agent 为什么爱重复造轮子
那篇评论给了四条解释,和工程现场对得上:
- 局部上下文偏好:相关工具在三个包之外,提示里没有任何东西指向它,Agent 就在它能看到的文件里解决问题;
- 命名不匹配:既有函数叫
formatCurrency,Agent 想的是"金额分",模糊搜索也会错过; - 完成度奖励:一个自包含的小函数能让当前改动变绿,而且不用碰共享代码——这是通往绿色的最短路径;
- 桶导出掩盖来源:所有东西都从一个索引重导出,Agent 意识不到需要的函数已经在公共接口上。
四条里没有一条是"模型能力不足",全是检索与归属的问题。这也意味着,靠一句"请不要重复造轮子"的提示词解决不了,得靠约定加一道评审关卡。
测试侧能做的四件事
| 动作 | 怎么做 | 拦住的缺陷 |
|---|---|---|
| 先搜后写 | 提交前做语义检索(不只搜文件名),要求说明为何既有实现不能用 | 重复实现 |
| 边界用例矩阵 | 金额类固定跑边界值,不看业务常用值 | 舍入差异 |
| 单一事实源断言 | lint/import 边界:计费逻辑只能从指定模块导入 | 第二份真相 |
| 事故样本回归 | 把历史真实事故金额固化成用例 | 同类问题复发 |
金额边界用例可以固定成一张小表,每次改动都跑:
| 输入(分) | 四舍五入 | 银行家舍入 | 差异原因 |
|---|---|---|---|
| 5 | 1 分 | 0 分 | 恰好一半,取偶 |
| 15 | 2 分 | 2 分 | 一半取偶后进位一致 |
| 25 | 3 分 | 2 分 | 一半取偶 |
| 2675 | 27 分 | 28 分 | 二进制浮点与十进制舍入差异 |
差异可以用几行代码验证,不需要跑整个系统:
from decimal import Decimal, ROUND_HALF_EVEN, ROUND_HALF_UP
amt = Decimal("0.005")
print(amt.quantize(Decimal("0.01"), ROUND_HALF_UP))    # 0.01
print(amt.quantize(Decimal("0.01"), ROUND_HALF_EVEN))  # 0.00
评审阶段的三步拦截
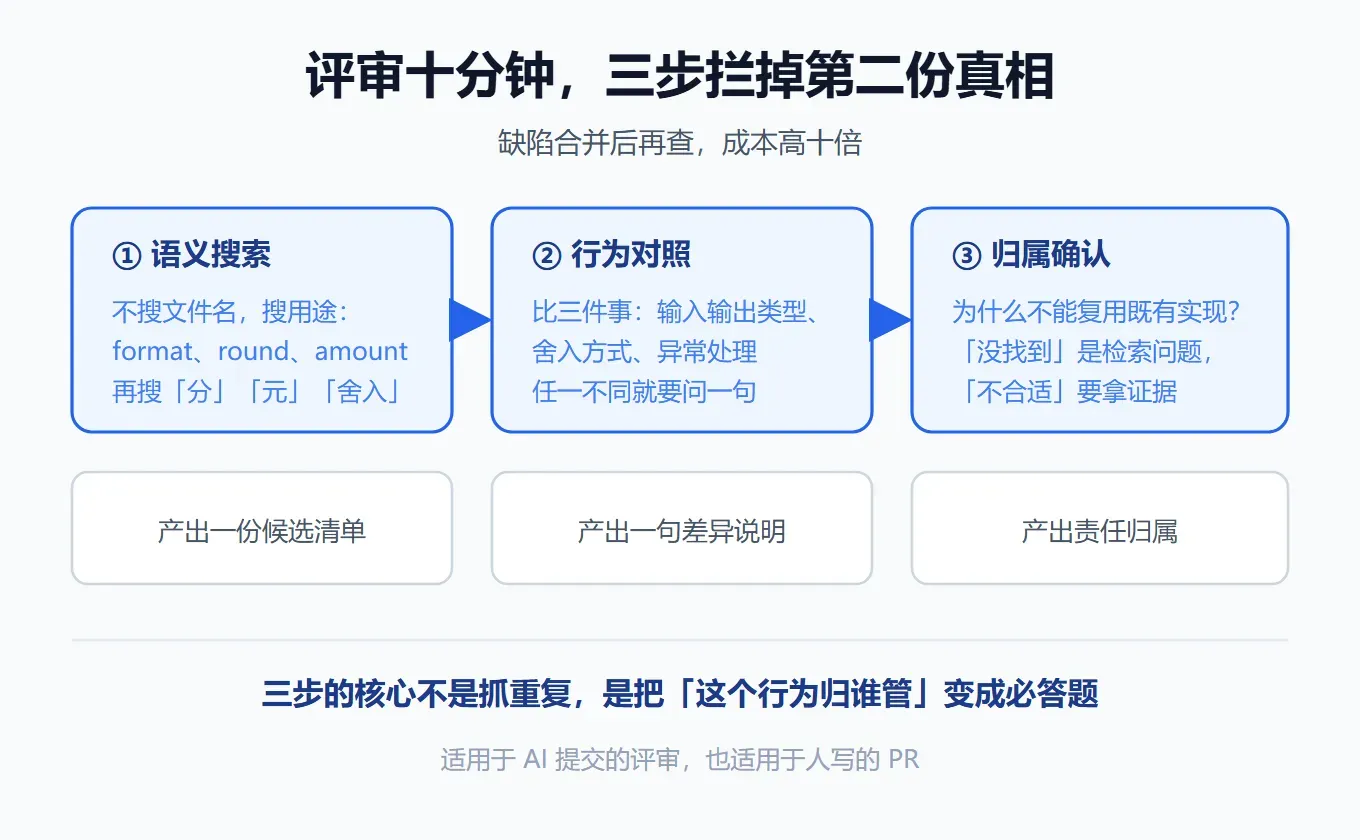
缺陷合并后再查,成本高十倍。评审时按三步走,十分钟能做完:
第一步,语义搜索。 不看文件名,用函数用途搜:format、round、amount、currency,再搜中文注释里的"分""元""舍入"。只看命名会漏,因为新函数常常叫得不一样。
第二步,行为对照。 找到候选实现后,比三件事:输入输出类型、舍入方式、异常处理。三者任一不同,就要问一句"这是有意的差异,还是不知道有旧实现"。
第三步,归属确认。 让提交者(人或 Agent)回答:为什么不能复用既有实现?如果答案是"没找到",那就是检索问题;如果是"旧的不合适",就要给出不合适的证据,并在命名上体现差异。
三步的核心不是抓重复,是把"这个行为归谁管"变成评审必答题。
把单一事实源写进 lint
约定靠人记,lint 靠机器记。两条规则最有效:
- 导入边界:计费、退款、结算相关目录,只允许从
currency包导入金额函数,禁止本地实现; - 禁用清单:禁止直接使用语言内置的四舍五入(如
round()、Math.round)处理金额,必须走统一封装。
这两条规则会在 CI 里直接失败,不依赖评审者的经验。规则本身要写清例外通道:确实需要特殊舍入的,走显式命名(如 formatForDisplayOnly),并且禁止出现在计费链路。
多币种与税费:边界会翻倍
单一币种时,边界是几个"半分";多币种时,边界是"半分 × 币种小数位 × 税率舍入顺序"。
举例:日元没有小数位,最小单位是1元,0.5 这种输入本身就不该出现;而美元、欧元有两位小数,分币处理必须一致;某些币种有三位小数(如部分中东货币),如果系统按两位截断,误差会累积到对账层面。
再叠加税费:先算税再舍入,和先舍入再算税,结果不同。测试用例必须把这两种顺序都固定下来,并写明业务选择的是哪一种。没有写明的,就是未来对账差异的源头。
AI 代码评审清单
看到 AI 新增的工具函数,问五句:仓库里有没有同职责实现?舍入/时区/编码这类隐性规则跟谁对齐?失败时返回什么?边界输入谁负责测?这段逻辑归哪个模块管?五句里有两句答不上来,就要求补证据再合并。
为什么"财务签过字"这件事,不能只写在注释里
那个既有函数之所以特殊,不是因为代码写得好,而是因为它承载了一个组织决策:一次真实的分币事故之后,财务确认了舍入规则。这种决策通常只留下两种痕迹——代码注释,或者一次会议。
注释会被复制、被忽略、被 AI 当成普通说明。会议则根本不在仓库里。所以第二个实现出现时,它不可能知道"这个规则签过字"。
可迁移的做法是:把这类决策变成可执行的约束,而不是可阅读的说明。具体三步:把规则写成边界用例(0.005 该舍到哪边);把用例挂到唯一的实现上(改实现必须过这组用例);把实现标记为唯一入口(其他模块只能调用)。三步做完,规则就从"人记得"变成"机器拦得住"。
这件事对 AI 编程时代尤其重要:模型读得到注释,但它不会因为一句"这是财务确认的"就改变行为。它只对失败负责。
边界:不是所有重复都要拦
判断标准不是"有没有重复代码",而是"这个行为是否已经有唯一归属"。如果新函数确实承担不同语义——比如只用于界面展示、不参与计算——那它可以存在,但必须在命名和注释上区分,并且用 lint 规则禁止它出现在计费链路里。反过来,两个函数今天行为一致、明天各自演化,这才是最贵的债:第一次有人只修了其中一个 bug,它们就分道扬镳。
这件事和"AI 写代码"的关系
AI 让写一个新函数变得比找一个旧函数更便宜,这才是重复激增的根本原因。成本结构变了,评审的重点也得变:过去审"这段代码对不对",现在还要审"这段代码该不该存在"。
测试工程师在这件事上有天然优势——你比谁都清楚哪些规则踩过坑、哪些数字出过事。把这些沉淀成边界用例和导入约束,比写十条"让AI别重复"的提示词有用得多。
系统的可靠性,最终取决于同一件事有几个版本。版本越少,越可信。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。