摘要
Microsoft Research与卡内基梅隆大学研究者在2026年10月公开CRBugBench代码审查Agent基准,覆盖公开仓库与一家企业的专有仓库任务。本文区分Benchmark结果与生产能力,拆解漏报、误报、上下文差异及人机责任边界,并给出可复现的审查Agent验证步骤。
PR里有一处边界条件没处理,代码能编译,单测也通过,审查Agent却给出一条看起来很专业的评论。测试工程师的问题是:这条评论抓住了真正的缺陷吗?更重要的是,它没评论的那部分,能不能被当成安全信号?Microsoft Research与卡内基梅隆大学研究者于2026年10月公开的CRBugBench预印本,正是围绕审查Agent是否能发现经过人工验证的bug构建基准。arXiv页面称,公开仓库部分包含1000个review任务,另有来自一家大型公司的800个专有仓库任务;最佳被评估组合在top-5评论中捕获71.9%的bug,而五个月前的一个模型组合为47.7%。这些数字来自论文作者的benchmark评估,不是生产缺陷拦截率;预印本于2026年10月9日提交,Microsoft Research页面标注为2026年10月。本文要回答:测试团队怎样把研究结果转成自己仓库里的可验证试点,又不把“Agent没评论”误读成“代码没问题”。
看见数字,先问它的分母是什么
代码审查Agent最容易被营销数字简化成“能发现多少bug”。CRBugBench把bug和引入它的PR配成评审任务,用人工确认过的缺陷来评估评论是否命中。这个设定比让模型给PR打总体质量分更接近具体审查任务,但它仍有边界:benchmark问题来自被收集到的历史缺陷;真实PR里,缺陷可能尚未被发现、需要跨服务上下文,或由产品目标本身定义不清造成。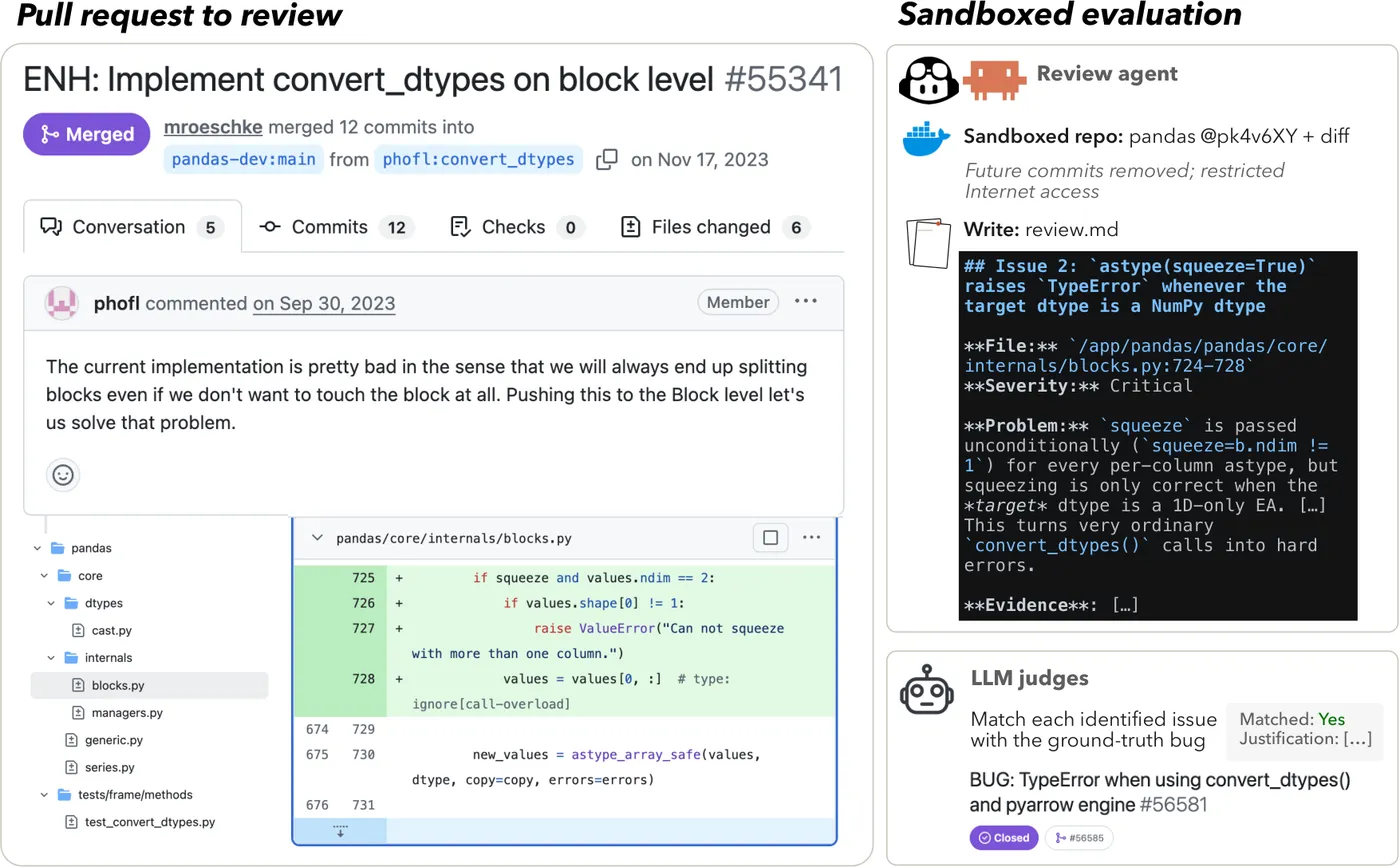
研究结果中“top-5评论捕获bug”的意思,是前五条评论里是否包含与已知缺陷有关的发现。它不等于模型对所有代码的正确率,也不意味着评论可以自动阻断合并。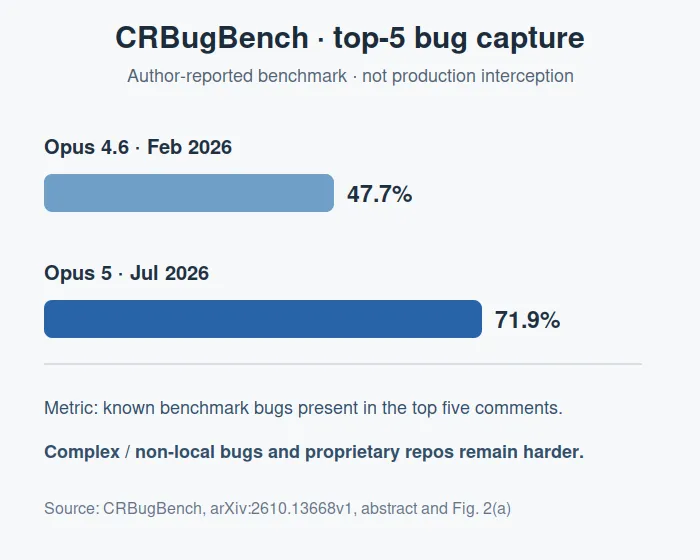
还要看“已知缺陷”是怎样成为标签的。论文分别从合并前被人工修复的Review comment,以及合并后由Issue和修复PR回溯到引入缺陷的变更中收集任务。前一类更接近评审现场能看到的信号,后一类更接近原评审逃逸的缺陷。两种来源的可观测信息不同,因此团队复现时应分别报告,不能将一组样本的命中率当成对所有缺陷的统一能力。
论文的任务构造还使用模型评估器判断Agent评论是否对应已知缺陷。它能扩展标注规模,却会引入新的误差:措辞相似不代表识别了同一个业务错误,表达不同也不代表完全无关。团队本地试点最好抽查边界样本,由开发和测试共同确认“评论指出了哪条不变量、怎样复现、影响是什么”,而不是只依赖评估器的相似度标签。页面还指出,复杂变更和需要非局部推理的缺陷上表现下降,在专有企业仓库上也有明显下降,因为项目上下文更重要。这个反差对测试团队很关键:模型看得懂语法,不等于掌握业务约束;能找出历史样本中的问题,不等于能判断当前需求是否满足。
“没有评论”不是一种判定
接入审查Agent时,团队往往先看它指出了哪些问题。更难的是统计它没有指出什么。对任一PR,至少有四种情况:评论命中真实缺陷;评论指出真实但低优先级的问题;评论是误报;它漏掉了已知风险。只统计评论数会鼓励模型多说,导致审查者疲劳;只统计命中率会让模型通过少评论提高精确率,却把漏报留给后续。
建议把审查Agent当作一个“候选风险提示器”,而不是合并裁决者。第一阶段只让它对历史PR回放,保留人类原始审查和后续缺陷记录。每条评论需落到文件、行号、风险类别、严重性和可复现理由。评估时区分精确率、召回率、重复评论率、评论延迟以及审查者采纳率。涉及授权、资金、隐私、数据迁移的变更,应当单独设定更高的漏报容忍要求;一个平均分会掩盖高影响类别的缺陷。
| 证据问题 | 可记录字段 | 判定不能偷换成 |
|---|---|---|
| 评论是否命中 | defect_id、file、line、category | 评论数量越多越好 |
| 是否漏报 | 已知缺陷未被提示的任务 | 未评论即无风险 |
| 是否误报 | reviewer disposition、复现证据 | 人类没采纳就一定错 |
| 是否可操作 | 建议是否能被修复并验证 | 语言流畅就是质量高 |
| 是否适用 | 仓库类型、改动复杂度、上下文可用性 | benchmark结果等于线上表现 |
一次可复现的试点怎么做
不要直接在真实合并流程里打开自动阻断。先选一个有历史PR、后续缺陷记录完整的仓库,固定Agent版本、提示词、可读取的项目说明、工具权限和推理预算。抽样时同时纳入已知有缺陷的PR和后来确认没有缺陷的PR,否则无法估计误报。把任务按变更类型分层:局部逻辑、跨模块调用、配置与权限、数据迁移、测试代码本身。评估集应按时间切分,避免同一个缺陷的修复提交出现在训练提示和验证集两边。
每轮回放保存完整输入、仓库快照、Agent输出、工具调用、运行耗时和人工标注。遇到不一致时,先区分是上下文缺失、工具没有执行、推理路径偏离、还是规则本身不明确。测试人员可以维护一个由开发、产品和安全共同签字的缺陷分类表,而不是只靠一个LLM Judge给评论打分。Judge可以辅助排序,但对高风险结论仍要留出可核验样本和人工复核。
试点上线可以分三段。影子阶段:评论对开发者不可见,只做离线比较;提示阶段:展示建议但不阻断,记录采纳和忽略理由;门禁阶段:只对经过验证、规则明确的确定性问题阻断。只有当某一类别在当前仓库持续具有足够召回、误报可接受且定位信息可靠,才扩大范围。每次模型或上下文升级,都需要重放固定回归集。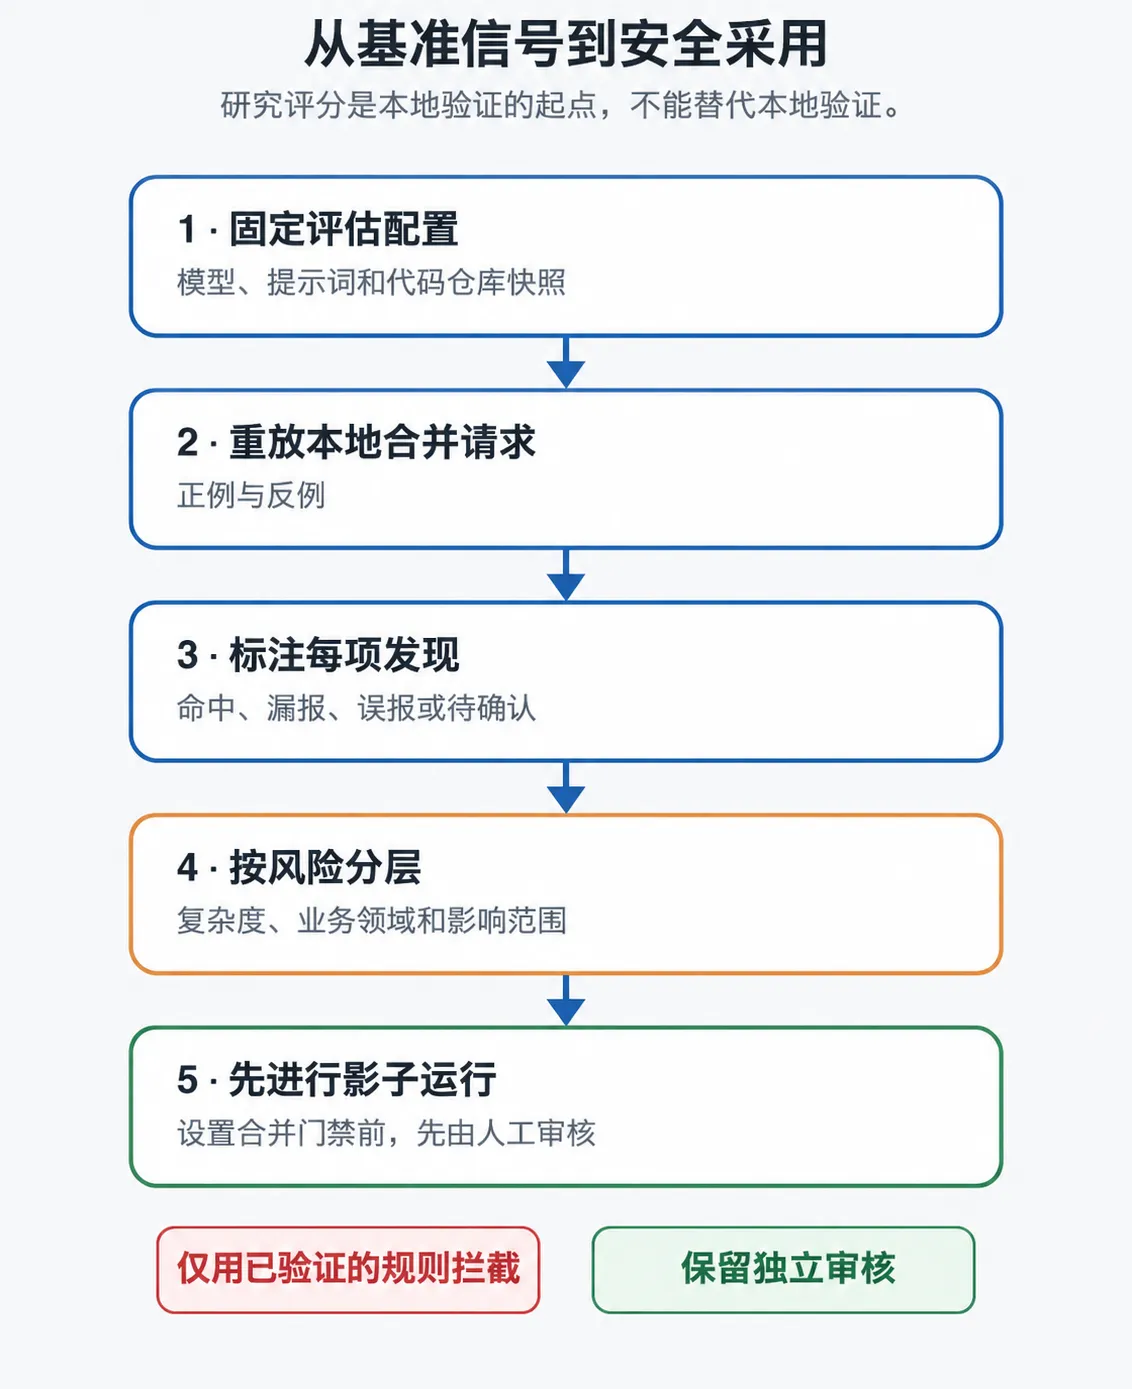
把研究结果迁移到团队时,可以沿着“固定环境—本地PR回放—人工标签—按风险分层—先影子观察”的路径推进。每一步都保留可回查证据,避免一次离线分数直接变成线上门禁。
复杂PR与私有仓库为何掉分
复杂缺陷通常不是单行错误,而是跨越多个文件的行为不一致:接口改了但调用方仍假设旧语义;新增重试却没有幂等;权限检查放在UI而未放在服务端;迁移脚本只覆盖新建数据。审查Agent需要知道仓库的架构边界、业务不变量、版本兼容政策和已弃用组件。只把代码片段送给模型,它很可能对局部写法给出合理评论,却错过系统级后果。
专有仓库还存在访问控制和隐私问题。为了提升上下文,把整个仓库、历史PR、生产日志全部交给第三方服务,并非无成本选项。测试团队应定义上下文最小化:Agent能读哪些目录,是否可访问Secrets、制品、网络、生产数据;审查结果保存多久;模型输出是否进入开发者绩效或安全审计。能力提升与数据暴露必须一起评估。
不要让实现和验收共享同一猜测
如果Coding Agent写补丁、生成单测,再由另一个同模型Agent审查,三者可能共享相同错误理解。一个看似完整的闭环可能只是同一个假设被重复三遍。独立证据可以来自需求契约、数据库状态断言、消费者驱动契约、独立维护的业务规则样例,或者由业务人员确认的验收条件。审查Agent的价值在于补充视角,而不是创造一个自我认证体系。
另一个重要边界是缺陷发现与代码审查价值并不完全重合。CRBugBench把重点放在可验证缺陷上,代码审查还会涉及可维护性、架构一致性、性能取舍和产品意图。若Agent指出“可以改成另一种写法”,但没有说明违反了哪条契约,这类评论不能和越权漏洞或资金计算错误按同一严重度计数。测试报告应把可复现缺陷、设计建议和风格反馈分开,避免评论数量被误当作风险覆盖。
对测试工程师来说,可复用的项目练习是搭一个离线PR回放器:读取固定commit和diff,向Agent提供限定上下文,输出结构化finding;再用真实缺陷标签计算命中、漏报和误报,并按复杂度分层。项目说明要写清楚数据集来源、任务切分、模型配置、人工标注规则和限制。面试时被追问“为何不让AI直接合并”,答案应落到证据边界:Benchmark告诉我们某能力存在,但生产适用性仍需本仓库验证,尤其要独立验证它无法观察到的风险。
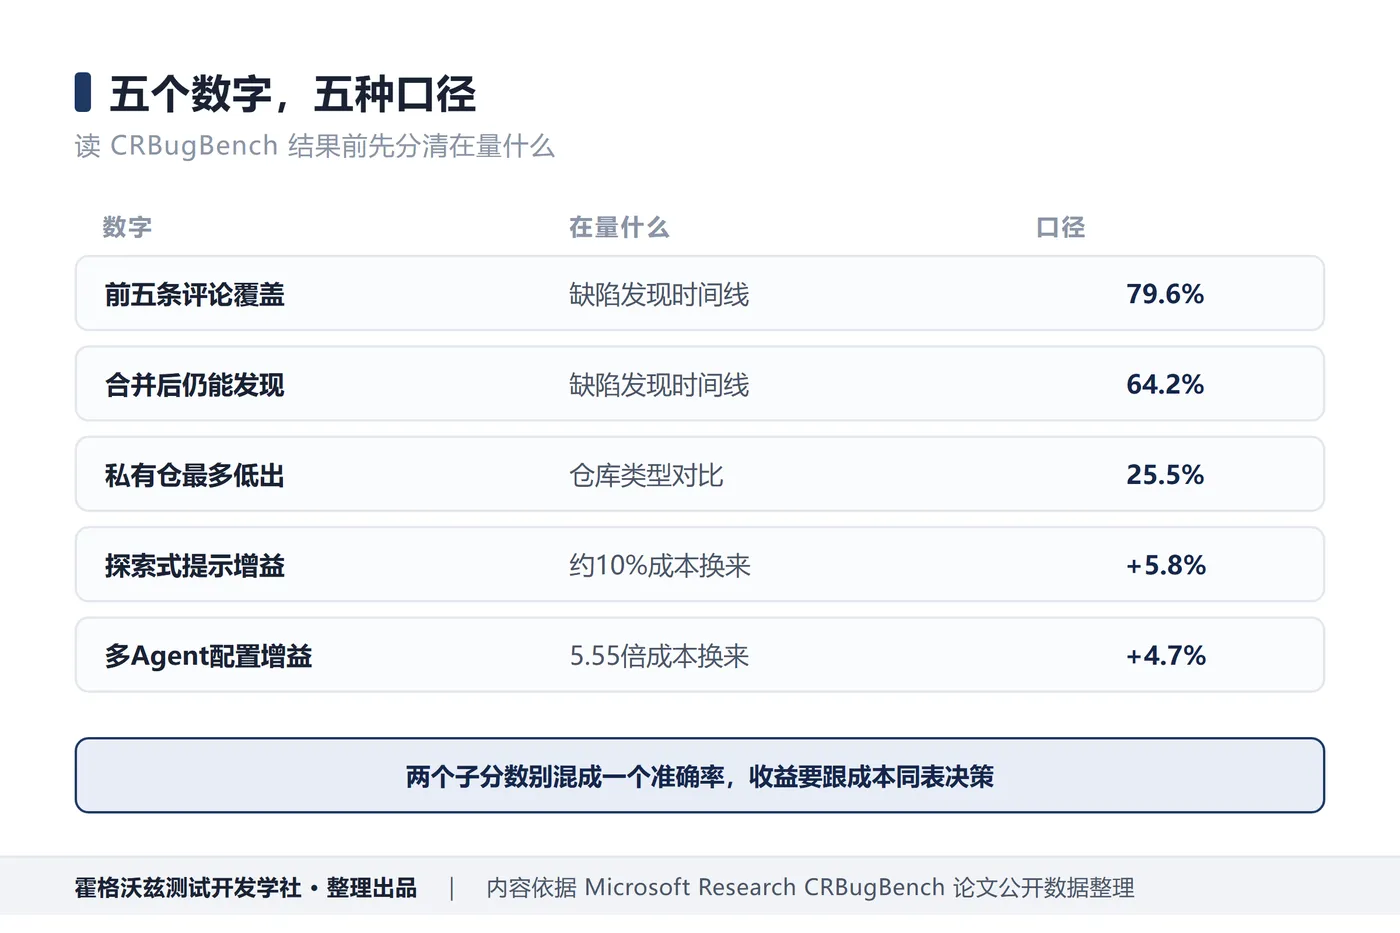
还可以把论文结果按缺陷被发现的时间拆开看。最佳配置在前五条评论中覆盖了79.6%的合并前已发现缺陷,以及64.2%的合并后才被发现缺陷。后者原本没有出现在评审讨论里,因而更接近“历史逃逸缺陷能否被回看发现”。两个分母不能混成一个总体正确率;测试团队做本地回放,也要把评审时已知问题与发布后才暴露的问题分层保存。
私有仓库结果进一步说明上下文是能力边界。论文报告在企业专有仓库任务上的表现最多下降25.5%,并指出这些任务更常需要从diff之外的项目上下文推理;相关仓库平均超过十万个源文件,而公开仓库平均约三千个。团队不应把这个规模差异理解为“代码越多必然越差”,更合理的推断是:缺少项目知识、跨模块契约和组织特有约定,会让只看变更片段的Agent更难找出问题。
作者还测了额外推理预算的成本收益:探索提示带来最高5.8%的性能提升,成本约增加10%;多Agent配置的提升为4.7%,成本达到5.55倍。它提醒测试团队,评测报告不能只排模型分数,还应把一次评审成本、延迟和人工复核时间放在同一张决策表里。一个较小的增益可能值得用于高复杂PR,却不适合对所有变更默认开启。
结论:从评论机器人转向可问责的证据补充
代码审查Agent可以缩短发现问题的时间,但评估目标不能只是让它多写几条建议。真正需要验证的是:特定仓库、特定变更类型下,它能否稳定发现值得行动的问题,漏掉什么、误报多少、权限边界是否守住,以及模型升级后表现是否退化。Microsoft Research的CRBugBench提供了可讨论的研究信号,不能替代团队自己的历史回放和风险分层。最稳妥的定位,是让Agent扩大审查覆盖,同时保留独立测试与人类责任判断。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。