9.0 起 Elasticsearch 的超时异常从 5xx 变成 429(Too Many Requests)。这条 breaking change 不报错、不改数据,但会让"按 5xx 判服务端故障"的客户端、告警规则和重试逻辑全部误判。
说明
实测环境:本机保留带 v5.6.16 / v7.3.0 / v7.4.0 / v8.17.0 / v8.18.0 / v9.0.0 / v9.1.0 / v9.2.0 / v9.3.0 / v9.4.2 等标签的上游源码仓库 elasticsearch/;用 git -C elasticsearch 的 show / diff / ls-tree 读指定标签的源码、提交 diff 与文件清单。另起一个 9.4.2 单节点实例(HTTP 9200)用于出图框架。文末实测小节里的命令与响应均取自本机。
一个状态码改动,影响面比看起来大
一个状态码的改动,影响面比看起来大:
- 客户端里
if (status >= 500) 判定服务端故障的逻辑,从此不再覆盖超时; - 反过来,把 429 一律当成"被限流、等一会儿再试"的代码,现在会把等待超时也当成限流;
- 告警规则如果按 5xx 计数,"集群里超时变多"这件事会从监控里消失。
这条改动官方只给了一句说明,没有细节,所以直接去源码里对了一遍。
官方依据
9.0 的 breaking changes 列表里这一条(docs/release-notes/breaking-changes.md @ v9.4.2):
304: * Change Elasticsearch timeouts to 429 response instead of 5xx [#116026]
v9.4.2:docs/release-notes/breaking-changes.md#L304——就这一行,没给原因也没给范围。所以下面全靠代码核实。
代码对照:8.18 与 9.4.2 的差异
超时异常是 ElasticsearchTimeoutException。先看 8.18(server/src/main/java/org/elasticsearch/ElasticsearchTimeoutException.java @ v8.18.0):
public class ElasticsearchTimeoutException extends ElasticsearchException {

    public ElasticsearchTimeoutException(StreamInput in) throws IOException {
    super(in); }
    public ElasticsearchTimeoutException(Throwable cause) {
    super(cause); }
    public ElasticsearchTimeoutException(String message, Object... args) {
    super(message, args); }
    public ElasticsearchTimeoutException(String message, Throwable cause, Object... args) {

        super(message, cause, args);
    }
}
没有覆写 status()——所以它继承 ElasticsearchException.status() 的默认值,也就是 500(INTERNAL_SERVER_ERROR)。这就是"以前是 5xx"的来源。
再看 9.4.2(同文件 @ v9.4.2):
40:    public RestStatus status() {

42:        return RestStatus.TOO_MANY_REQUESTS;
43:    }
46:    public boolean isTimeout() {
两个变化:
- 第 40–42 行:显式覆写
status(),返回RestStatus.TOO_MANY_REQUESTS; - 第 46 行:新增
isTimeout(),让调用方能直接判断"这是超时",不用去猜状态码。
TOO_MANY_REQUESTS 的定义在 v9.4.2:server/src/main/java/org/elasticsearch/rest/RestStatus.java#L468:TOO_MANY_REQUESTS(429)——这个枚举值 8.18 和 9.4.2 里都有(同样在 468 行),变的只是超时异常不再走默认 500。
为什么是 429
官方没说,判断是语义归位:超时是"服务端在规定时间内没干完",属于可重试的临时状态,和限流(429 Too Many Requests,标准语义里就带"你可以稍后重试")是一类;而 5xx 的语义是"服务端出错",客户端通常不会重试,还会把它算进故障率。以前把超时归到 5xx,等于让一堆可重试的场景被当成故障。
需要说明:这段是推断,不是官方文档的说法,判断依据是 HTTP 状态码的语义分工——结论本身(5xx→429)是核实过的,原因是补的解释。
哪些路径会拿到 429
凡是抛 ElasticsearchTimeoutException 的地方,HTTP 状态码都从 5xx 变成 429。在 v9.4.2 里 grep 了这个异常的引用位置,能核实到的有:
| 文件 | 场景 |
|---|---|
org/elasticsearch/action/support/ListenerTimeouts.java |
请求 listener 的超时控制 |
org/elasticsearch/action/support/SubscribableListener.java |
listener 超时 |
org/elasticsearch/cluster/service/ClusterApplierRecordingService.java(L103) |
集群状态应用没在规定时间完成 |
org/elasticsearch/action/admin/cluster/configuration/TransportAddVotingConfigExclusionsAction.java |
投票配置排除的等待超时 |
org/elasticsearch/action/admin/cluster/configuration/TransportClearVotingConfigExclusionsAction.java |
同上,清理分支 |
org/elasticsearch/action/fieldcaps/TransportFieldCapabilitiesAction.java |
field_caps 等待超时 |
org/elasticsearch/action/support/single/shard/TransportSingleShardAction.java |
单分片操作(get、termvectors 一类) |
org/elasticsearch/common/util/concurrent/FutureUtils.java |
通用 future 超时 |
一条重要的边界:搜索请求自带的 timeout 参数(以及 search.default_search_timeout)不在这个异常的抛出路径上——grep action/search/ 目录没有命中 ElasticsearchTimeoutException,搜索超时的表现是返回已经收集到的部分结果、响应里带 timed_out: true,HTTP 状态码仍是 200。
这条未逐个接口实测,落到具体场景上,建议自己确认一次:造一个会超时的小请求,看返回的响应码是不是 429,而不要只看客户端日志里的报错文案。
客户端要改什么
1. 判断逻辑从"5xx 即故障"改成"先看是不是超时"。 服务端现在给了更准的信号:
{

  "error": {
    "type": "timeout_exception", "reason": "..." },
  "status": 429
}
判断顺序建议是:先判 status == 429,再看 is_timeout / 异常类型是不是 timeout_exception,最后才落到通用 5xx 分支。
2. 重试策略要分开。 超时和限流都是 429,但处置方式不一样:
- 限流(
EsRejectedExecutionException,见下节):退避重试,同时该考虑降压; - 超时:重试是有用的,但先确认超时阈值合不合理——一直超时的重试只会把压力放大。
3. 告警规则要补一个维度。 如果告警是按 HTTP 状态码分桶的,超时会从 5xx 桶里消失、混进 429 桶(和限流一起)。建议把 429 拆成"限流 429"和"超时 429"两个指标再设阈值,否则限流告警会被超时稀释。
429 和限流怎么区分
同一个 429 现在代表两件事,这是升级后最容易踩的坑。看 v9.4.2:server/src/main/java/org/elasticsearch/ExceptionsHelper.java#L88-L89:
} else if (t instanceof EsRejectedExecutionException) {

    return RestStatus.TOO_MANY_REQUESTS;
}
也就是说,队列打满被拒绝(EsRejectedExecutionException)一直是 429,现在超时也变成 429。区分办法是看 error.type:
| 场景 | 异常类 | error.type |
|---|---|---|
| 被限流/队列满 | EsRejectedExecutionException |
es_rejected_execution_exception |
| 等待超时 | ElasticsearchTimeoutException |
timeout_exception |
别只看状态码。
在本地仓库上跑一遍
正文说 9.0 起超时返回 429,把两个标签的异常类读一次就能对上。
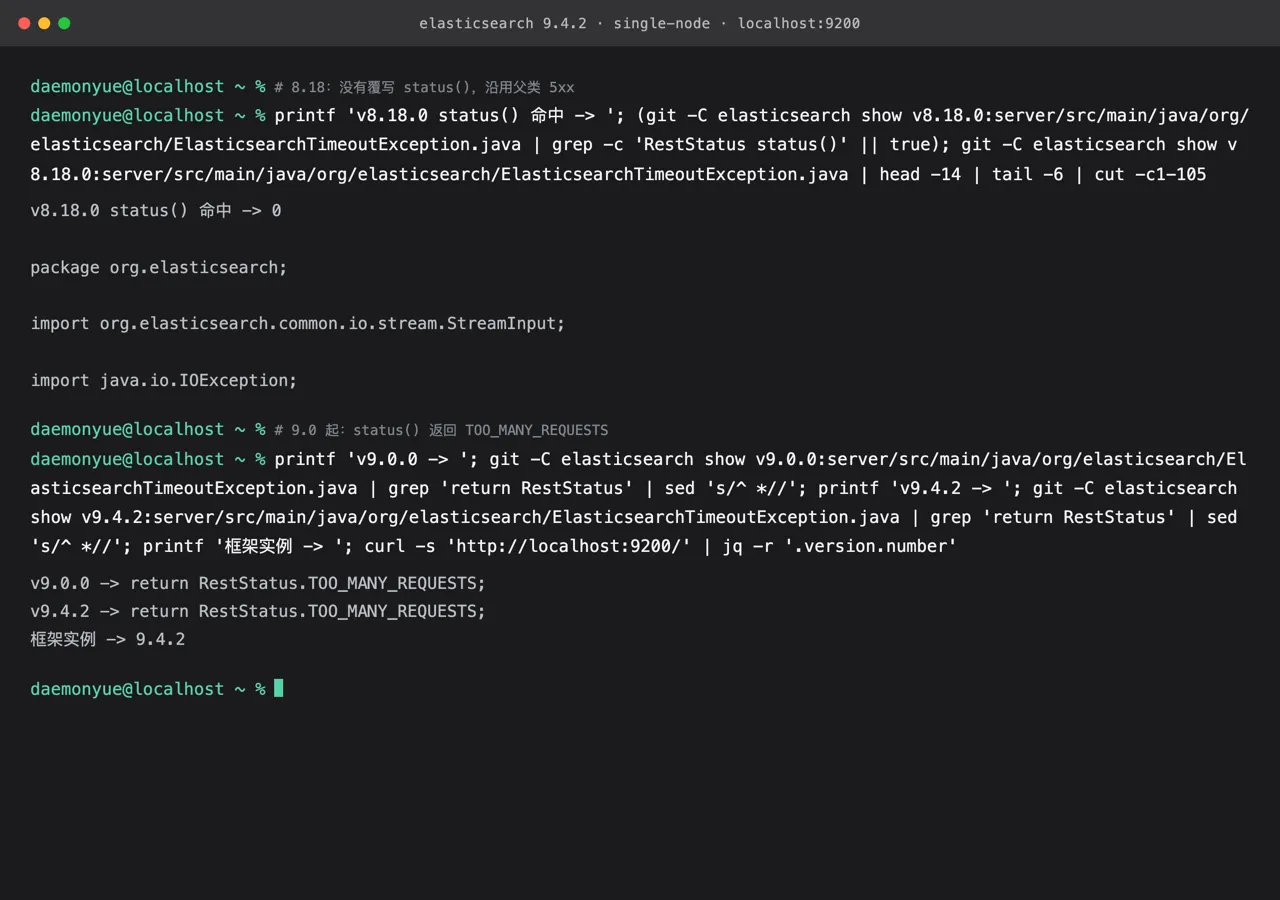
图 1:本机源码标签的实测输出。ElasticsearchTimeoutException.java 在 v8.18.0 里没有覆写 status()(沿用父类 5xx);v9.0.0 与 v9.4.2 都新增 public RestStatus status() 并返回 RestStatus.TOO_MANY_REQUESTS。
P=server/src/main/java/org/elasticsearch/ElasticsearchTimeoutException.java
printf 'v8.18.0 status() 命中 -> '; git -C elasticsearch show "v8.18.0:${P}" | grep -c 'RestStatus status()'
# 0
for t in v9.0.0 v9.4.2; do printf '%s -> ' "$t"; \
  git -C elasticsearch show "${t}:${P}" | grep 'return RestStatus' | sed 's/^ *//'; done
# v9.0.0 -> return RestStatus.TOO_MANY_REQUESTS;
# v9.4.2 -> return RestStatus.TOO_MANY_REQUESTS;
curl -s 'http://localhost:9200/' | jq -r '.version.number'
# 9.4.2
图 1 把 changelog 里那句「超时从 5xx 改成 429」落到了代码:旧类没有 status() 覆写,新类直接返回 TOO_MANY_REQUESTS,到 9.4.2 仍然如此。按 5xx 判服务端故障的客户端逻辑因此需要改,这一点正文已经展开。
边界:
- 图 1 出自本机源码标签,没有起集群、没有发起过会超时的请求,也未验证实际 HTTP 响应码;
- 「为什么改成 429」是推断,「搜索 timeout 不受影响」未逐个接口实测;
- 客户端侧的重试与告警误判未模拟。
写在最后
- 这条 breaking change 的杀伤力在于它很安静:没有报错、没有数据影响,只是状态码语义变了,所以升级后没人第一时间发现,直到告警曲线和重试行为开始对不上。
- 改客户端的三件事:判断顺序先 429 后 5xx、重试策略把超时和限流分开、告警把 429 拆成两个指标。
- 别忘了一条边界:搜索的
timeout不在这次改动里,它照旧返回 200 +timed_out: true。
参考
- docs/release-notes/breaking-changes.md#L304 @ v9.4.2
- ElasticsearchTimeoutException.java#L40-L46 @ v9.4.2
- ElasticsearchTimeoutException.java @ v8.18.0(对照:未覆写 status)
- RestStatus.java#L468 @ v9.4.2
- ExceptionsHelper.java#L88-L89 @ v9.4.2
本文所有代码引用均取自本地
elasticsearch/仓库v9.4.2/v8.18.0标签,行号已逐条核对。文末实测小节里已实际对照ElasticsearchTimeoutException:v8.18.0无status()覆写,v9.0.0与v9.4.2返回RestStatus.TOO_MANY_REQUESTS。本机未发起过超时请求,实际 HTTP 响应码未验证;"为什么改成 429"是推断;"搜索 timeout 不受影响"未逐个接口实测。