
AI第一次给AI动手术
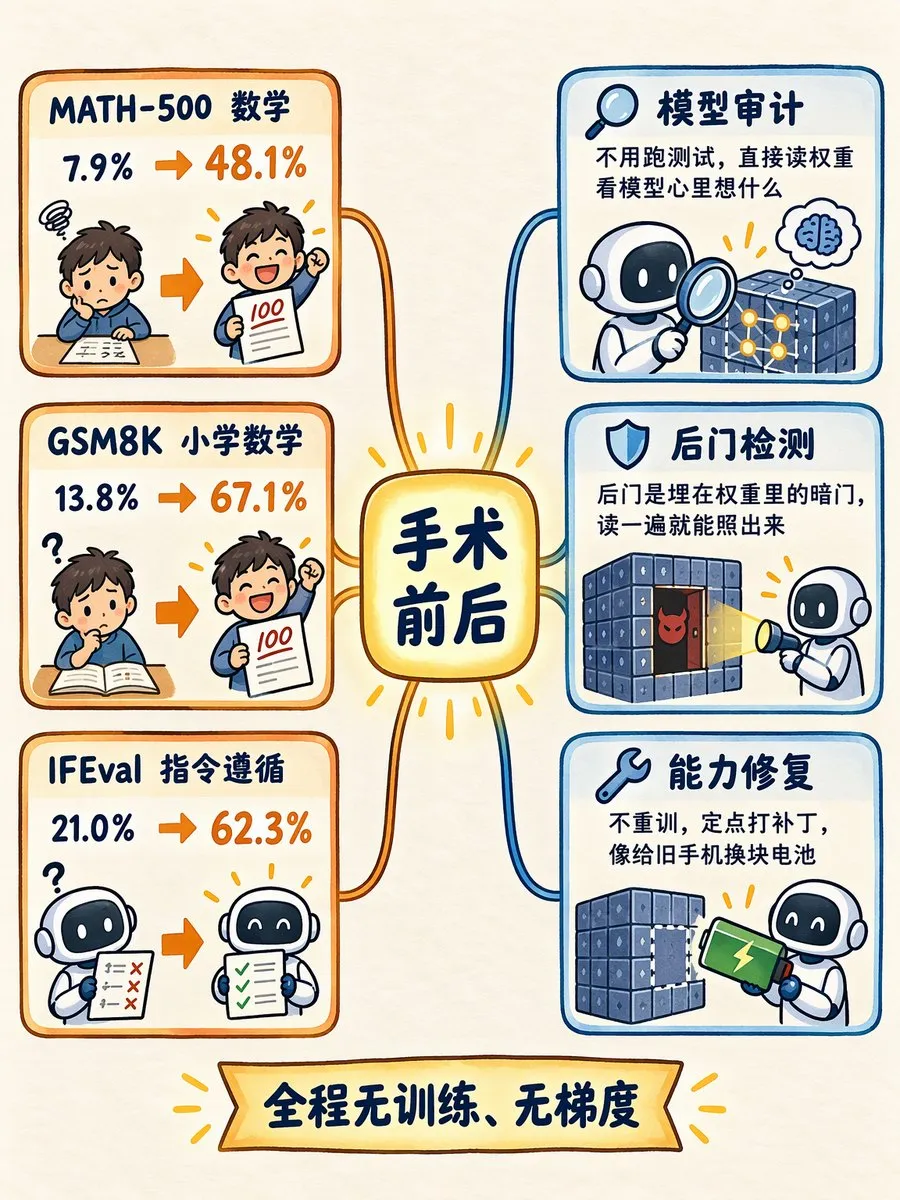
只改 0.016% 的参数,数学成绩从 7.9% 涨到 48.1%
 封面
 第1页
 思维导图①
 第3页
 第4页
 思维导图②
 第6页
 第7页
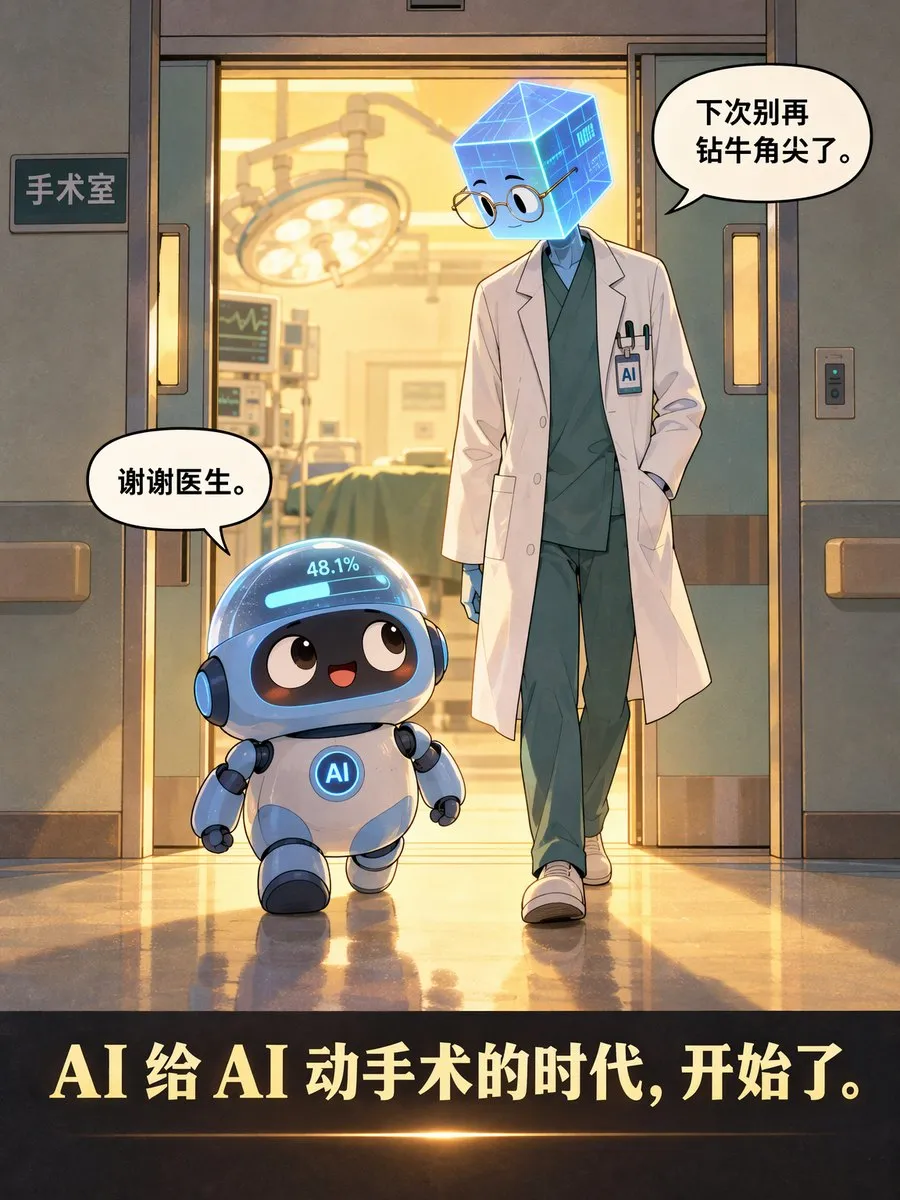
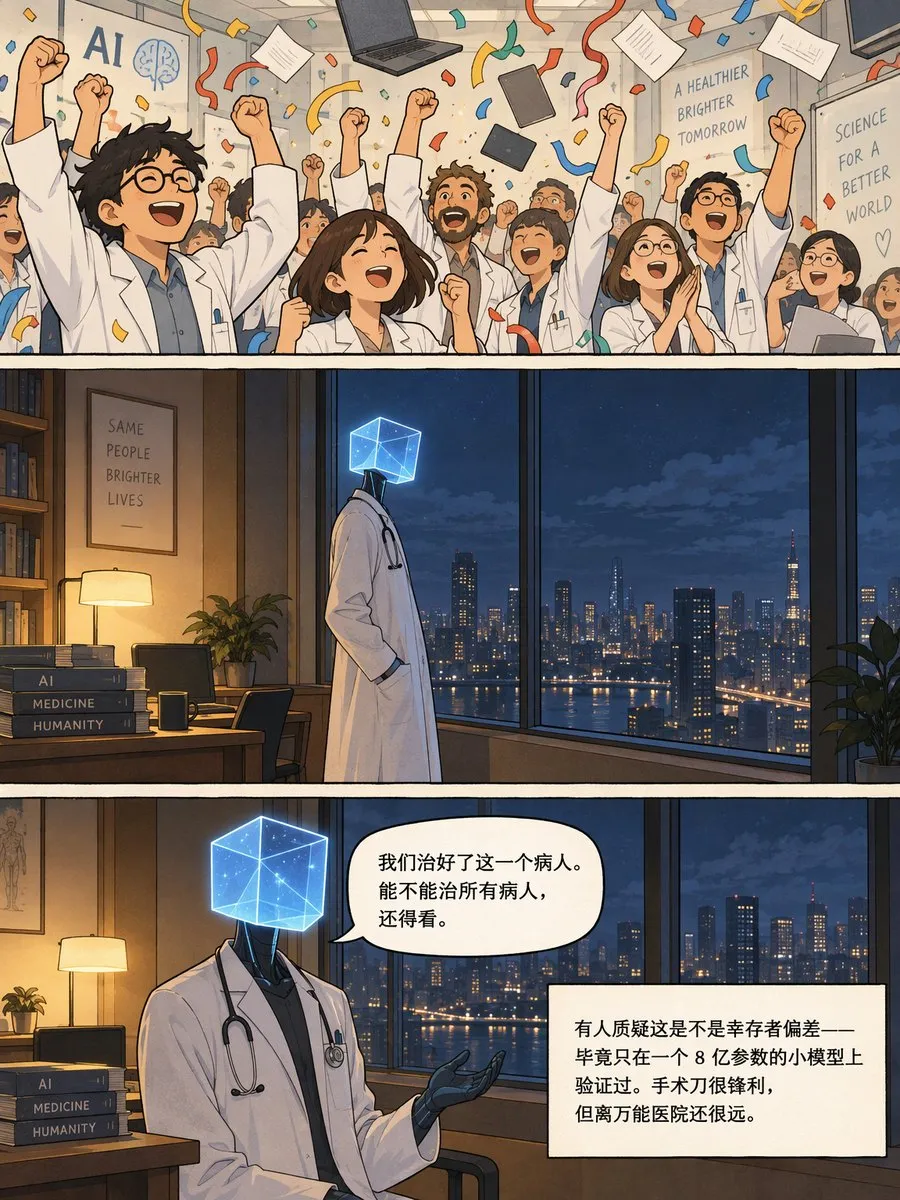
这条新闻里有个细节,我觉得比"数学成绩涨 6 倍"更值得玩味——被改的那个模型,是 Qwen3.5-0.8B。 一个 8 亿参数的开源小模型,被另一个大模型读懂了内部结构,然后精准地改了 0.016% 的参数,能力就有了实质变化。 这件事对开源模型生态的意义,可能比表面看起来要大。 另外提一句,这篇文章配的 9 张漫画,是我用 AI 生成的——把技术流程讲成故事,读者理解起来快得多。
先把事实摆清楚
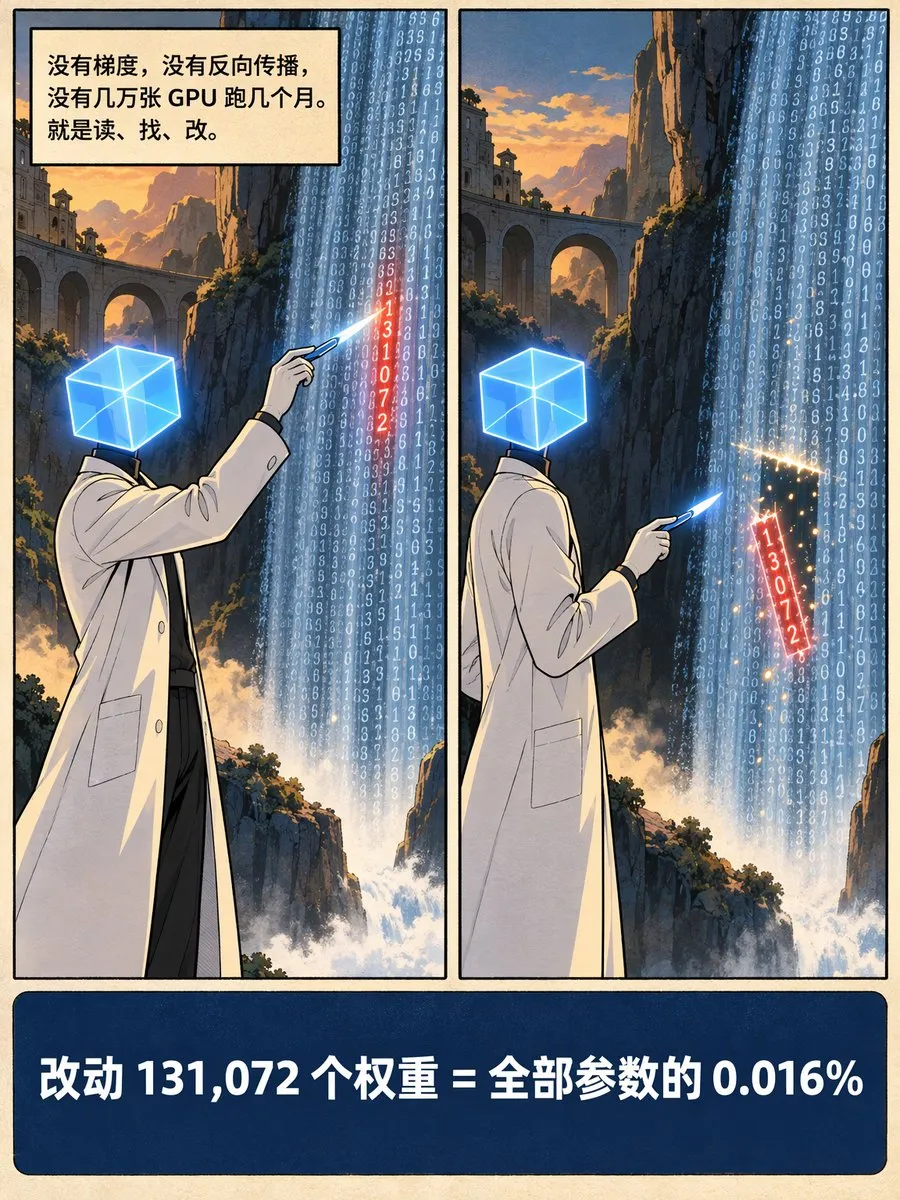
MIT CSAIL 的 Weight-Space Programming 方法,让 GPT-6 Astra 直接读写 Qwen3.5-0.8B 的权重。改动 131,072 个参数,占比 0.016%。
- - MATH-500:7.9% → 48.1%
- - GSM8K:13.8% → 67.1%
- - IFEval:21.0% → 62.3%
无梯度、无训练、无反向传播。
开源模型的一个老问题
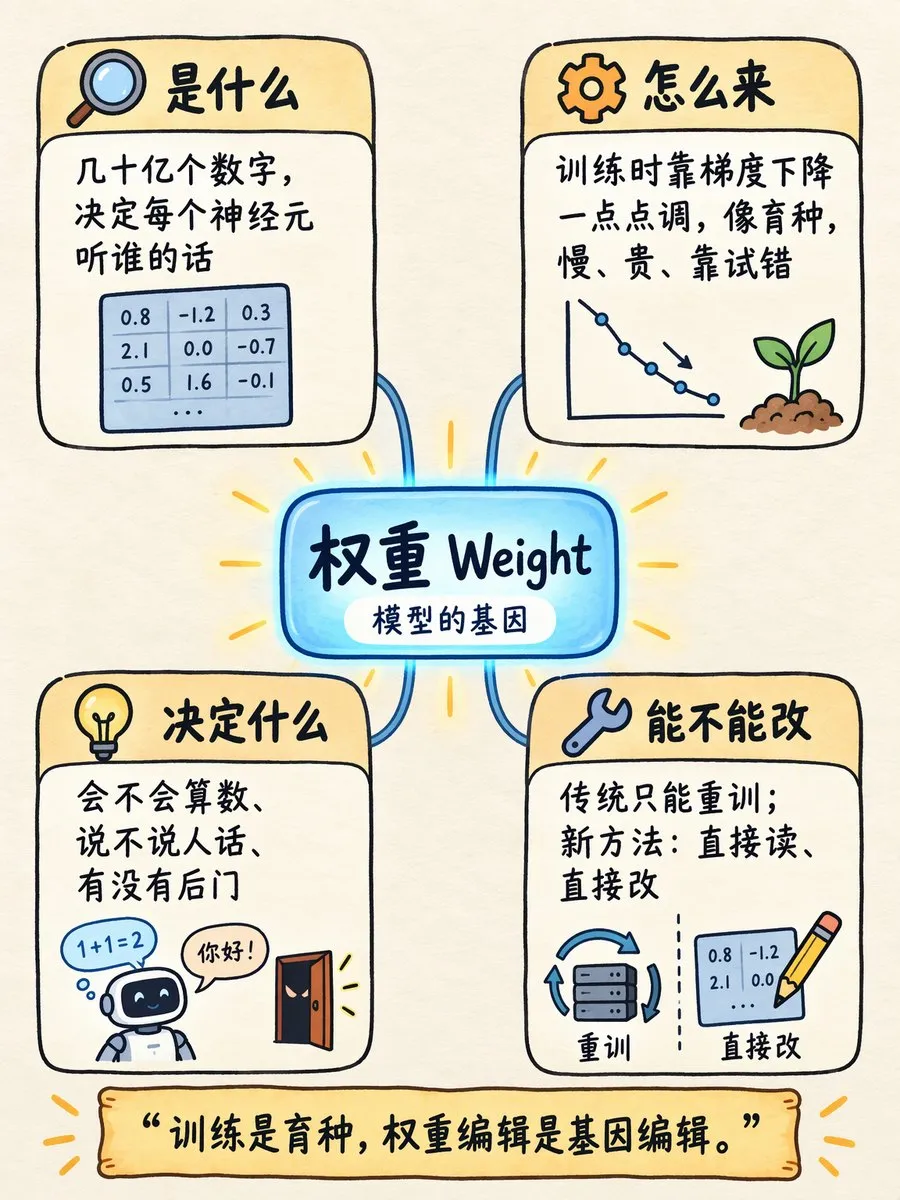
开源模型的好处是透明、可改、可商用。但"可改"这件事,一直停留在比较粗的层面。 你能做的无非是:继续预训练、做 SFT、做 LoRA、改推理代码。这些都是"外部干预",改的是模型的行为表现,不是模型本身的结构。 真正想动内部,得懂架构、懂训练、有算力。门槛很高。 权重空间编程提供的是另一条路:用自然语言描述问题,让一个强模型去定位并修改参数。 如果这条路走通了,开源模型的二次开发门槛会大幅降低。你不需要懂反向传播,只要能描述清楚"这个模型哪里不对",就有可能修好它。 这个思路其实和 AiPy 一直在做的事有点像——把复杂的模型能力包成普通人能直接用的工具,用户只管说需求,底层怎么调模型、怎么串流程,交给系统。门槛降下来,用的人才会多起来。
对模型分发的想象
顺着这个思路往下想,会有一个挺有意思的场景。 以后开源模型的分发,可能不只是给一个权重文件,还会附带一份"权重说明书"——哪些参数对应哪些能力,哪些区域是敏感的,哪些地方有已知缺陷。 下游开发者拿到模型,可以先"体检",再按需"手术"。 这会让模型的复用变得更精细。现在大家用开源模型,基本是"拿来即用"或者"整体微调",中间地带很空。
但有几个坎
第一,可解释性的边界。 Astra 能定位到"这一列在制造死循环",但它能不能解释"这一列为什么会导致死循环"?定位和解释是两回事。前者够用,后者才是真正的理解。 第二,验证的规模。 8 亿参数跑通了,不代表 70B 能跑通。参数越多,权重序列化后的长度越大,大模型的上下文窗口扛不扛得住是个问题。 第三,安全的两面性。 权重可读,后门可查;但权重可写,后门也可埋。开源模型如果支持这种编辑方式,供应链安全的复杂度会上升。
一个我比较在意的点
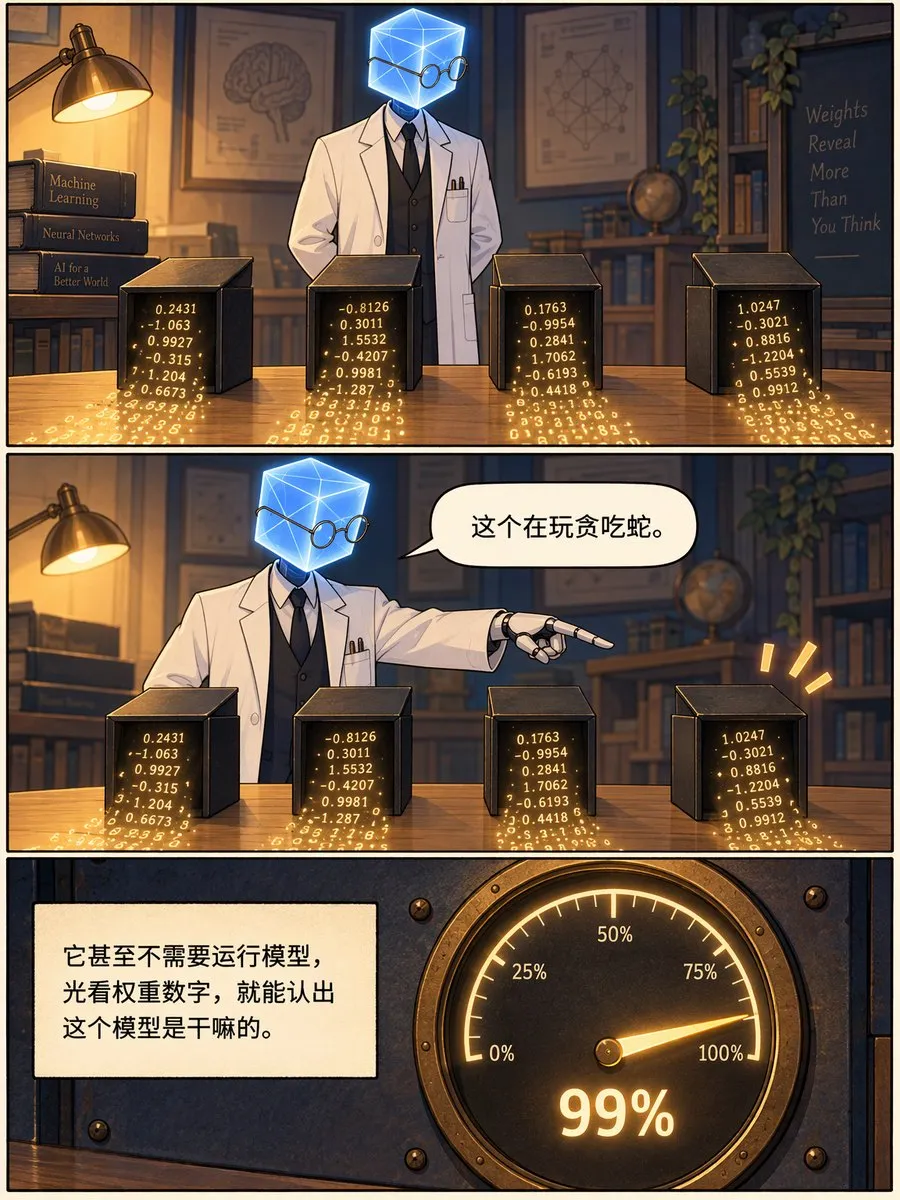
这个实验里,Astra 不只是"改",它还"认"。 给它 17,253 个权重数字,它能以 99% 的置信度判断这个模型在玩哪个游戏。这个能力说明,权重里确实编码了高层语义信息,而且是可以被外部模型提取的。 如果这个能力可以泛化,那模型的"指纹识别"就有了技术基础。判断两个模型是不是同源、判断一个模型有没有被微调过、判断模型的实际能力和宣称是否一致——这些都有解了。
最后
我倾向于把这件事看成开源模型生态的一个转折点信号,而不是一个成熟技术。 它打开的方向是:模型从"整体黑箱"变成"可拆解的部件集合"。 这个方向如果走通,开源模型的玩法会变。至于变多快,得看接下来有没有人把工具链做出来、把大模型上的验证补上。
