摘要:让模型"输出 JSON"是新手第一反应,也是生产事故的高发区——格式错乱、字段缺失、超范围取值,下游系统根本接不住。LangChain 的结构化输出用 Pydantic Schema 约束模型行为:返回带类型的可校验对象,校验失败自动把错误喂回模型重试。本文讲清四种 Schema 表达的取舍(Pydantic/dataclass/TypedDict/JSON Schema)、ProviderStrategy 与 ToolStrategy 两种策略的选择、handle_errors 的五种配置形态,以及"规则写进 Schema、错误交给框架"的核心方法论,附合同抽取的完整可运行案例。
关键词:LangChain、结构化输出、Pydantic、with_structured_output、ToolStrategy、ProviderStrategy、handle_errors、数据抽取、大模型应用开发
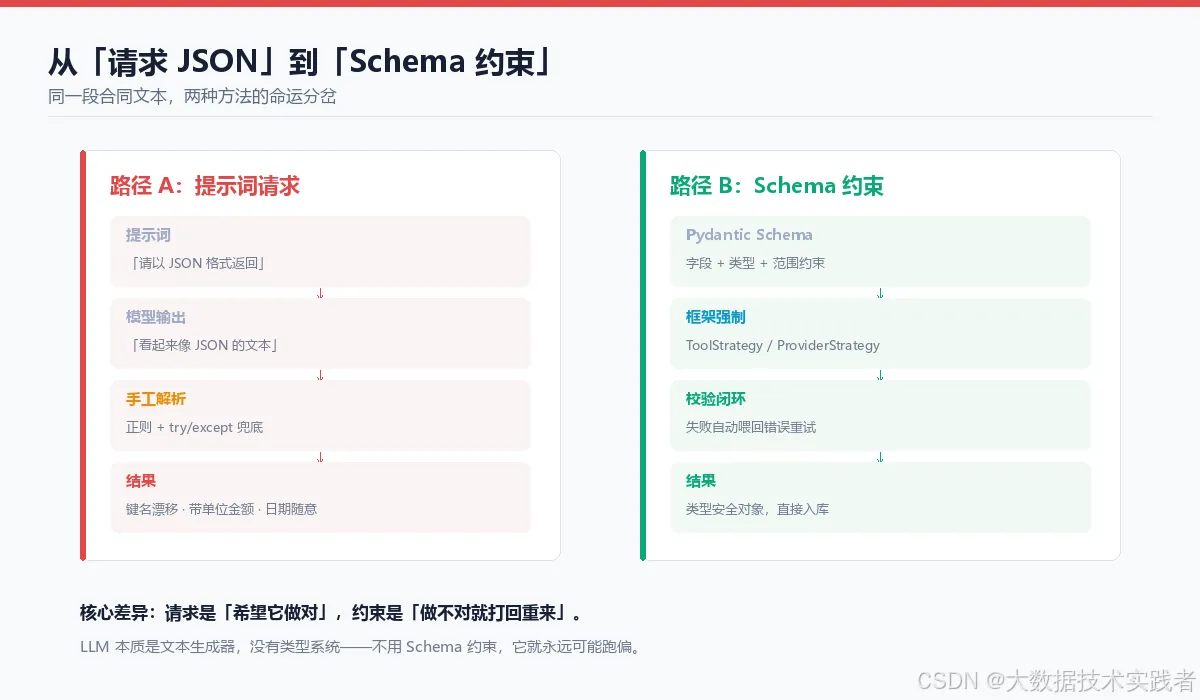
一、"请返回 JSON 格式"为什么是错的
几乎每个新手都写过这样的提示词:
请从以下合同文本中提取信息,以 JSON 格式返回:
{"party_a": "甲方名称", "amount": 金额, "expire_date": "YYYY-MM-DD"}
然后惊喜地发现:模型返回的是"看起来像 JSON 的文本"——键名换了、金额带单位成了字符串、日期是"明年三月"、外层还包了段 markdown 代码块。你写正则解析、加"不要 markdown"的提示、再补"严格 JSON"……最后用 try/except 兜底,失败就丢弃。
问题的根源不在提示词,在方法:你在"请求"模型输出结构,而不是"约束"它。LLM 的本质是文本生成器,没有类型系统,你不用 Schema 约束它,它就永远可能跑偏。
结构化输出(Structured Output)就是这个约束:用 Schema 定义结构,框架强制模型遵守,返回可校验的类型化对象。
二、两种使用姿势:单模型与 Agent
姿势一:直接绑在模型上——适合简单的抽取任务:
from pydantic import BaseModel, Field

class ContractInfo(BaseModel):
    party_a: str = Field(description="甲方全称")
    party_b: str = Field(description="乙方全称")
    amount: float = Field(description="合同金额,单位万元")
    expire_date: str = Field(description="到期日期,格式 YYYY-MM-DD")

structured_llm = llm.with_structured_output(ContractInfo)
info = structured_llm.invoke(contract_text)

info.party_a      # 直接点取,类型安全
info.amount       # float,可直接入库
姿势二:挂在 Agent 的 response_format 上——适合需要工具配合的复杂任务:
from langchain.agents import create_agent
from langchain.agents.structured_output import ToolStrategy

agent = create_agent(
    model=llm,
    tools=[search_kb],
    response_format=ToolStrategy(ContractInfo),   # 结构化输出并入主循环
    system_prompt="你是合同审查助手。",
)
result = agent.invoke({
   "messages": [...]})
print(result["structured_response"])   # ContractInfo 对象
v1.0 的关键改进:Agent 的结构化输出并入主循环,不再需要额外一次模型调用——延迟和成本同时下降。
三、四种 Schema 表达,验证强度完全不同
| Schema 类型 | 返回 | 校验 | 适用 |
|---|---|---|---|
| Pydantic BaseModel | 校验后的对象 | ✅ 完整校验(ge/le/Literal 全生效) | 生产首选 |
| dataclass / TypedDict | dict | ⚠️ 轻量检查 | 简单场景 |
| 原始 JSON Schema dict | dict | ❌ 不做校验 | 仅定形状 |
一个容易被忽略的官方说明:原始 JSON Schema dict 不做校验——模型的工具调用参数原样返回,handle_errors 的自动重试形同虚设。想要校验和自动重试,Schema 必须写成 Pydantic(或 dataclass/TypedDict)。
Pydantic 的 Field 约束就是你的业务规则:
from typing import Literal

class ProductReview(BaseModel):
    rating: int | None = Field(description="1-5 分", ge=1, le=5)
    sentiment: Literal["positive", "negative", "neutral"]
    key_points: list[str] = Field(description="关键点,每条 1-3 个词")
ge=1, le=5 意味着模型返回 10 分会被直接打回;Literal 意味着情感只能是三个值之一。规则写进 Schema,而不是写在提示词里求模型遵守——这是结构化输出的核心方法论。
Field 的 description 同样重要:它既是给模型的提示(怎么填这个字段),也是校验的语义依据(什么算填对)。
四、两种策略:ProviderStrategy 与 ToolStrategy
LangChain 在底层用两种方式实现约束:
| 策略 | 机制 | 可靠性 | 适用 |
|---|---|---|---|
| ProviderStrategy | 厂商原生结构化输出 | 最高(厂商强制 Schema) | OpenAI/Anthropic/Gemini 等原生支持时 |
| ToolStrategy | 借道工具调用强制形状 | 高(自动重试兜底) | 任何支持工具调用的模型 |
直接传 Schema 类型时框架自动选择:模型原生支持就用 ProviderStrategy,否则回退 ToolStrategy。日常实践建议显式指定 ToolStrategy——跨厂商行为一致,且能配错误处理。
v1.0 还支持 Union 多 Schema:模型根据内容自选最合适的结构返回(比如一段文本可能是联系人信息也可能是日程),校验仍然完整。
五、handle_errors:校验失败的自动闭环
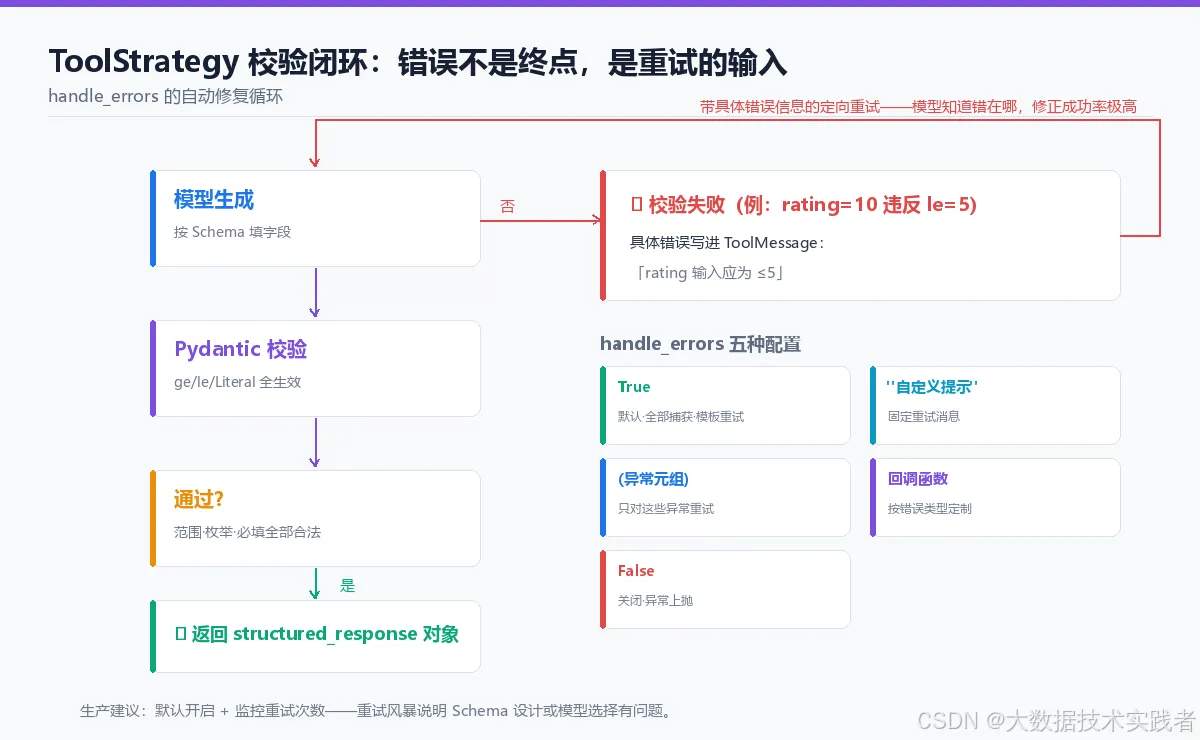
这是结构化输出最有生产价值的部分。模型返回 rating=10 违反 le=5 约束时会发生什么?
ToolStrategy 默认行为(handle_errors=True):
- Pydantic 校验失败;
- 框架把具体错误写进 ToolMessage 喂回模型:"rating 输入应为 ≤5";
- 模型基于错误提示重新生成;
- 循环直到通过校验。
这不是模糊的"再试一次",而是带具体错误信息的定向重试——模型知道错在哪,修正的成功率极高。
五种配置形态,按需选择:
# 1. 默认:捕获所有错误,用默认模板重试
ToolStrategy(ProductReview)

# 2. 自定义重试提示
ToolStrategy(ProductReview, handle_errors="请按 1-5 分给出 rating,key_points 用中文短句")

# 3. 只对特定异常重试,其余抛出
ToolStrategy(ProductReview, handle_errors=(ValueError, TypeError))

# 4. 回调函数:按错误类型定制消息
def err_handler(e: Exception) -> str:
    if isinstance(e, MultipleStructuredOutputsError):
        return "只返回一个结构化对象,不要同时调多个"
    return f"格式错误:{e}"

ToolStrategy(ProductReview, handle_errors=err_handler)

# 5. 关闭重试,异常直接抛给调用方
ToolStrategy(ProductReview, handle_errors=False)
另一类常见错误是 MultipleStructuredOutputsError:模型一次调了两个结构工具(比如同时返回联系人和日程),框架同样会以错误反馈提示模型只保留一个。生产上建议保持默认开启,但在重试次数上做好监控——重试风暴说明 Schema 设计或模型选择有问题。
六、完整案例:合同要素抽取
串起全部概念的最小生产案例:
from typing import Literal
from pydantic import BaseModel, Field
from langchain.chat_models import init_chat_model
from langchain.agents import create_agent
from langchain.agents.structured_output import ToolStrategy
from dotenv import load_dotenv
import os

load_dotenv(override=True)

llm = init_chat_model(
    "deepseek:deepseek-chat",
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url=os.getenv("DEEPSEEK_BASE_URL"),
    temperature=0.0,          # 抽取任务必用低温
)


class ContractInfo(BaseModel):
    """合同要素抽取结果"""
    party_a: str = Field(description="甲方全称,工商注册名称")
    party_b: str = Field(description="乙方全称,工商注册名称")
    amount: float = Field(description="合同金额,单位万元", gt=0)
    contract_type: Literal["采购", "销售", "服务", "租赁", "其他"]
    expire_date: str = Field(description="到期日期,格式 YYYY-MM-DD,原文没有则填 unknown")


extractor = create_agent(
    model=llm,
    tools=[],
    response_format=ToolStrategy(ContractInfo, handle_errors=True),
    system_prompt="你是合同审查助手。只依据原文抽取,不得编造任何字段。",
)

result = extractor.invoke(
    {
   "messages": [{
   "role": "user", "content": contract_text}]}
)
info = result["structured_response"]
print(info.party_a, info.amount, info.contract_type)   # 类型安全,直接入库
三个细节值得抄走:temperature=0.0(抽取要确定性);docstring 写给模型看(它是 Schema 的一部分);system_prompt 明确"不得编造"(配合 Schema 的 unknown 兜底值,防止模型硬填)。
七、给 Java / 大数据工程师的对照
- Pydantic Schema ≈ DTO + Bean Validation:
Field(ge=1, le=5)就是@Min(1) @Max(5),Literal就是枚举校验——只是校验对象从用户输入换成了模型输出; - handle_errors 闭环 ≈ 消息重试队列:校验失败不是丢弃而是带着错误信息重新入队,直到成功或到达上限;
- "规则写进 Schema" ≈ "约束写进 DDL":靠应用代码兜底和靠 Schema 约束的差别,数据库工程师最懂。
八、小结
结构化输出的方法论三句话:
- 别请求,要约束——提示词里的"请返回 JSON"换成 Schema 定义;
- 规则写进 Schema——范围、枚举、必填都是 Pydantic 约束,不是提示词里的恳求;
- 错误交给框架——handle_errors 自动闭环,比你自己写解析重试可靠得多。
凡是"模型输出要给程序消费"的场景——抽取、分类、路由、评估——这一套都是标配能力。从第一行 Schema 开始,把输出从"祈祷"变成"工程"。
本文基于 LangChain v1.0 官方文档与社区实践整理,代码在 Python 3.13 + langchain 1.2.0 环境下验证通过。