
本文是《滚动轴承故障诊断》系列的第 5 篇(随机森林)。
系列完整目录见文末【专栏导航】。本篇配套的可运行脚本与报错速查见公众号。
一、都是深度学习年代了,为什么还要学随机森林
先给结论:因为论文里必须有对比实验。
一篇故障诊断的毕设,评审最看重的就是"你凭什么说你的方法好"——这需要一个对照组。而随机森林正是最合适的对照组:
- 它代表"传统机器学习路线"(人工特征 + 集成学习);
- 代码短、跑得快、不需要显卡,几秒钟就能出一个可靠的基线成绩;
- 用它证明"深度学习/残差网络确实比传统方法强",比单独夸自己的模型有说服力得多。
所以本篇不是"凑数的",它是你论文实验章节的地基。
二、随机森林原理
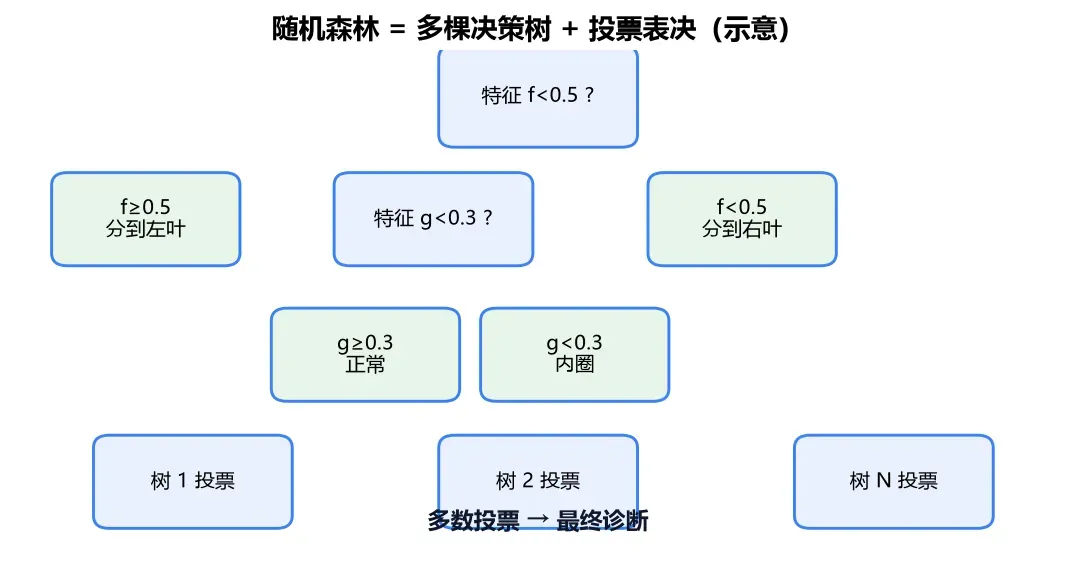
随机森林 = 很多棵决策树 + 投票表决。
- 决策树:像"考公务员的一连串是非题",根据特征不断把样本分到不同的叶子;
- 森林:训练 50 棵彼此略有差异的树(每棵看的样本、看的特征都不同,防止"一棵树全错");
- 投票:预测时 50 棵树各投一票,得票最多的类别就是最终答案。
"随机"两个字是关键:每棵树都只用随机抽出的样本和特征去学,这样它们各不相同,合起来才稳健——这也是"集成学习"的核心思想。
三、为什么要把信号"拍平"成 2000 维
这是随机森林最朴素也最关键的一步:
m_train = train_data.reshape(N, -1) # 每条样本 (1000, 2) → 摊平成 2000 个数
- 树模型不理解"波形"的结构,它只会把每一条样本看成一串数字(特征向量);
- 所以把每条 1000×2 的样本"摊平"成 2000 个特征,喂给随机森林;
- 代价是:它看不到"波形的形状",只能看到"这 2000 个数的取值"——这正是它不如深度网络的地方,后面会讲。
这一行代码也是全系列唯一一次"主动降维展开"的地方,值得记住:树模型吃一维特征,神经网络吃多维结构。
四、几个关键超参数在干什么
RandomForestClassifier(n_estimators=50, min_samples_split=5,
                       min_samples_leaf=4, max_depth=5)
| 参数 | 含义 | 本项目取值 |
|---|---|---|
n_estimators |
决策树棵数 | 50(越多越稳,但更慢) |
max_depth |
树最大深度 | 5(防过拟合) |
min_samples_split |
内部节点至少多少样本才继续分 | 5 |
min_samples_leaf |
叶子节点最少样本数 | 4 |
这套参数是一个"够用且不贪"的组合:既保证有足够的表达能力,又通过深度限制和叶子下限防止模型把噪声也背下来(过拟合)。毕设里不需要调得很精,能讲清楚每个参数是干嘛的就够了。
五、结果怎么看
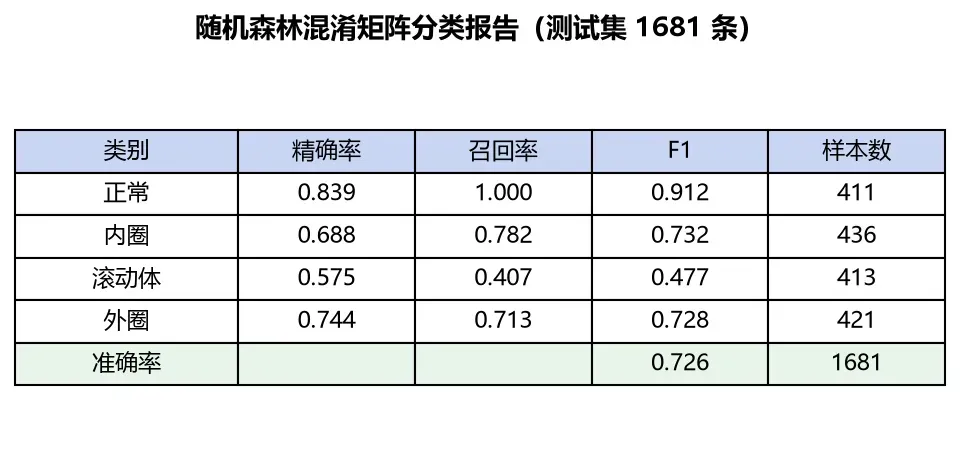
训练完会输出一个 classification_report,这是论文实验表的"原料":
              precision  recall  f1-score  support
       0      0.84       1.00    0.91      411
       1      0.69       0.78    0.73      436
       2      0.57       0.41    0.48      413
       3      0.74       0.71    0.73      421
    accuracy                           0.73   1681
- precision(精确率):说它是"内圈",说对的比例;
- recall(召回率):真的是内圈的样本,找回了多少;
- f1:两者的调和平均,综合分。
随机森林整体能到 0.73 上下——不错,但"只是 73",它到底弱在哪,第 6 篇讲残差时会有对照组。
六、随机森林的"天花板"
承认它的局限,才显得专业:
- 它看不到波形结构:只会看 2000 个数的"数值",抓不住"冲击、节奏、包络"这些波形特征;
- 到 73% 就上不去了:不是调参能救的,是模型表达能力的边界;
- 但这恰恰是它存在的价值:没有这个 73%,就衬托不出深度网络 95% 的价值。
七、本篇小结
- 随机森林是论文的"对照组",短平快、可复现;
- 它把样本"拍平"成特征向量、用树集成投票,原理简单、结果稳定;
- 完整脚本、运行步骤、结果解读见公众号。
专栏导航
| 篇次 | 主题 | 状态 |
|---|---|---|
| 1 | 项目总览与三模型对比 | ✅ |
| 2 | 环境部署 | ✅ |
| 3 | CWRU 数据集深度解析 | ✅ |
| 4 | 数据预处理源码走读 | ✅ |
| 5 | 随机森林实战(本文) | ✅ |
| 6 | 一维卷积与残差模块 | 排期中 |
| 7 | 模型训练与评估 | 排期中 |
| 8 | 可视化诊断系统 | 排期中 |
| 9 | 论文报告与答辩话术 | 排期中 |
下一篇预告:《一维卷积与残差模块:83% 到 95% 的原理拆解》,讲本系列最有含金量的一篇——为什么加一条"捷径",准确率就能跳 12 个百分点。
版权说明:CWRU 数据集版权归凯斯西储大学所有,仅限学习研究使用。
